Google holt sich mit Gemini 4 Carbon Platz eins zurück
Carbons offizielle Benchmarks und unabhängige Tests, warum gleicher Token-Preis trotzdem teurere Aufgaben heißt und die Preiserhöhung am 1. Dezember.
Krypton verfeuert für feinste Details das 5,7-Fache an Reasoning-Tokens wie Carbon, während das in begrenzten Tests laufende GPT-6.2 Sol angeblich für $1.19 pro Aufgabe mit Platz eins gleichzieht. Noch ist keines der beiden Modelle breit verfügbar, doch Tester, die den ganzen Tag mit diesen Modellen arbeiten, teilen ihre Aufgaben längst auf: eines für Tiefe, eines für den Alltag und ein drittes für Code.
Unter Entwicklern geht gerade ein Vergleichspost herum: Googles Gemini 4 Krypton und OpenAIs GPT-6.2 Sol treten im direkten Duell gegeneinander an, um zu zeigen, welches Modell mehr wegschafft.
Schaut man hinter den Trubel, ist etwas anderes viel spannender: Wer den ganzen Tag in diesen Modellen steckt, verteilt seine Arbeit längst nach Aufgabe. Ein Modell übernimmt die tiefen, detailreichen Brocken, ein zweites das tägliche Pensum, und ein drittes kümmert sich um Code und Orchestrierung. Die dichte Release-Welle im Jahr 2026 hat die Vorstellung von dem einen Modell für alles ziemlich gründlich abgeräumt.
Kurz gesagt: Krypton verbrennt für feine Details fast sechsmal so viele Reasoning-Tokens wie Carbon, während GPT-6.2 Sol mit Platz eins gleichziehen soll – bei rund einem Zehntel der Rechnung. Offiziell erschienen ist aber noch keines der beiden Modelle, und der kursierende Sol-Benchmark ist auf der Website von Artificial Analysis nicht zu finden. Produktiv einsetzen kannst du heute Carbon, Argon, GPT-6.1 Sol und Opus 5.5 – wie du sie je nach Aufgabe aufteilst, zeigen die Messwerte unten.
Fangen wir mit Gemini 4 Krypton an. Viral gegangen ist es vor allem mit kreativen Aufgaben: Ein einziger Prompt reicht, und das Modell baut eine komplette Voxel-Welt – samt Hafen, Leuchtturm, Kirschblütenbäumen, Burg und Segelbooten, bis hin zu Wasser und Beleuchtung.
Clips von Krypton (ein sehr früher Checkpoint), Carbon und Argon wurden nebeneinandergestellt: drei Videos von jeweils gut vierzig Sekunden, die alle dieselbe Voxel-Hafenstadt zeigen. Den Unterschied in der Detaildichte sieht man auf den ersten Blick.
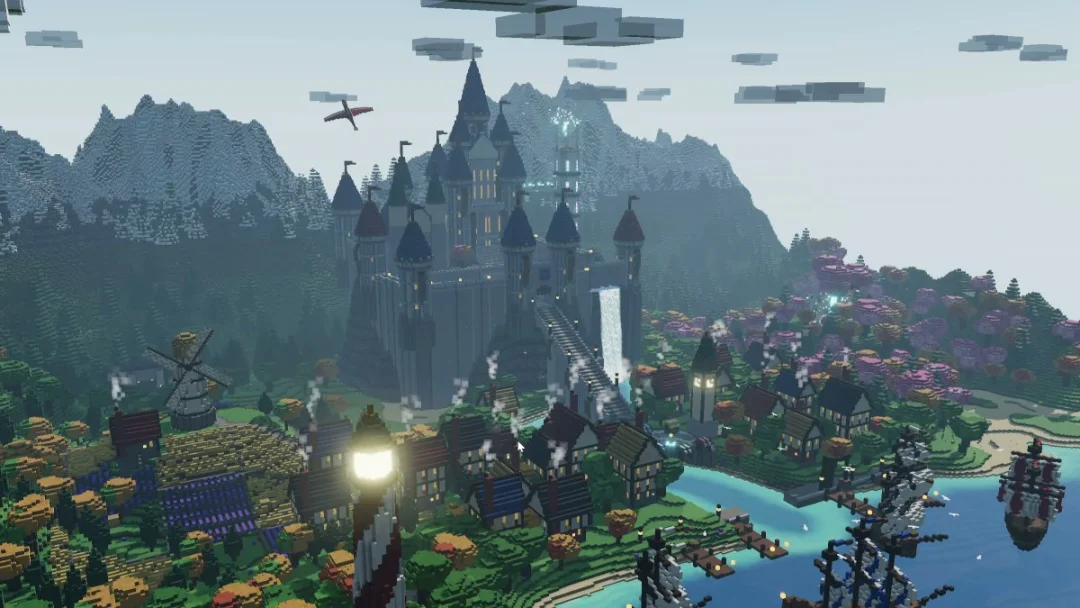 X · @lyraxanaGemini 4 Krypton vs Carbon vs ArgonAuf X ansehen
Woher kommt diese Detailtiefe? Krypton verfeuert dafür massenhaft Reasoning-Tokens. Es überlegt lange und gründlich, bevor es die erste Zeile ausgibt, und spart selbst beim PlayStation-Logo in der Mitte eines SVG-Controllers nicht an Feinheiten.
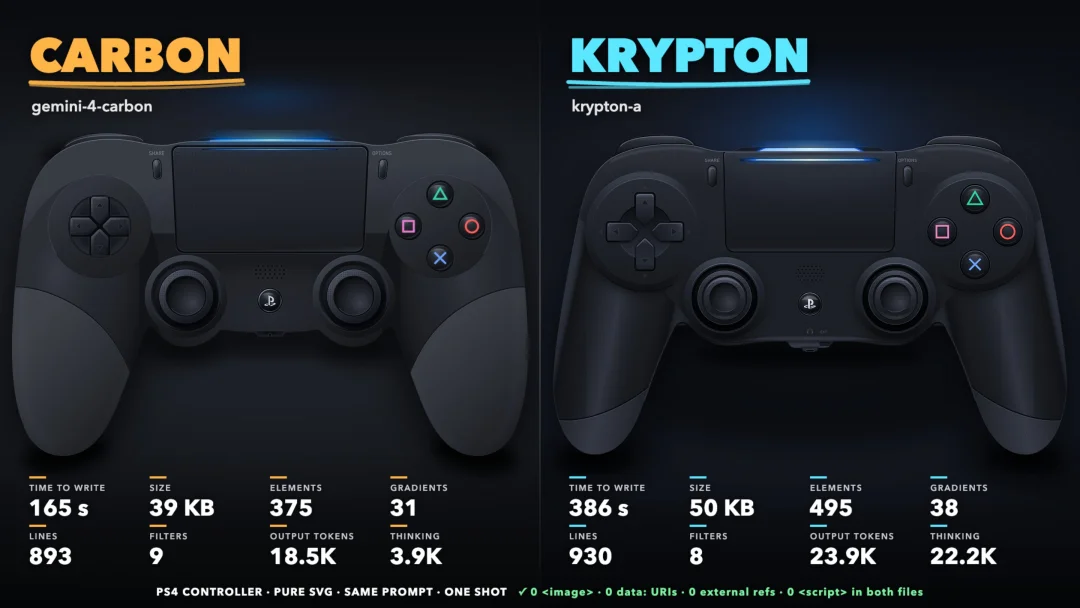
Beim selben Prompt lässt sich Krypton mehr als doppelt so viel Zeit – und liefert dafür das detailreichste Ergebnis, das ein Google-Modell bisher hervorgebracht hat. Ein Blick auf das PS-Logo in der Mitte des Controllers reicht.
| Kennzahl | Gemini 4 Carbon | Krypton | Krypton / Carbon |
|---|---|---|---|
| Generierungsdauer | 165 s | 386 s | 2,3× |
| Reasoning-Tokens | 3,9K | 22,2K | 5,7× |
| Output-Tokens | 18,5K | 23,9K | 1,3× |
| Dateigröße | 39 KB | 50 KB | 1,3× |
| Codezeilen | 893 | 930 | 1,04× |
Die Laufzeit hat sich mehr als verdoppelt, doch der fertige Code ist nur um 4 % länger. Der gesamte Zusatzaufwand steckt in den Reasoning-Tokens – dem 5,7-Fachen von Carbon. Jede Kurve und jeder Schatten wurde vor dem Schreiben durchdacht, nicht über zusätzliche Codezeilen zusammengebastelt.
Dieser Tausch von Denkzeit gegen Detailtreue zieht sich durch die gesamte Gemini-4-Familie. Kryptons PS5-Controller als SVG folgt demselben Muster, und Google-AI-Studio-Leiter Logan Kilpatrick sagt es so: „Carbon ist ein großartiges Modell, aber das Team kocht weiter : )“
Die Kehrseite ist ebenso deutlich. Wer Gemini 4 Carbon in Googles Antigravity auf hoher Reasoning-Stufe rund 7 Stunden lang parallel über mehrere Projekte laufen ließ, sah sein Wochenlimit von etwa 88 % auf 23 % abstürzen – über 60 % des Kontingents waren in einem Rutsch weg.
Je höher du die Reasoning-Stufe drehst, desto besser wird das Ergebnis, desto länger wartest du und desto mehr Tokens landen auf der Rechnung. Dieses Muster begegnet uns bei den nächsten Modellen immer wieder.
Schauen wir auf GPT-6.2 Sol. Am meisten Aufsehen erregt in der Community seit ein paar Tagen ein Screenshot, der angeblich erste Testergebnisse von Artificial Analysis (AA) zeigt:
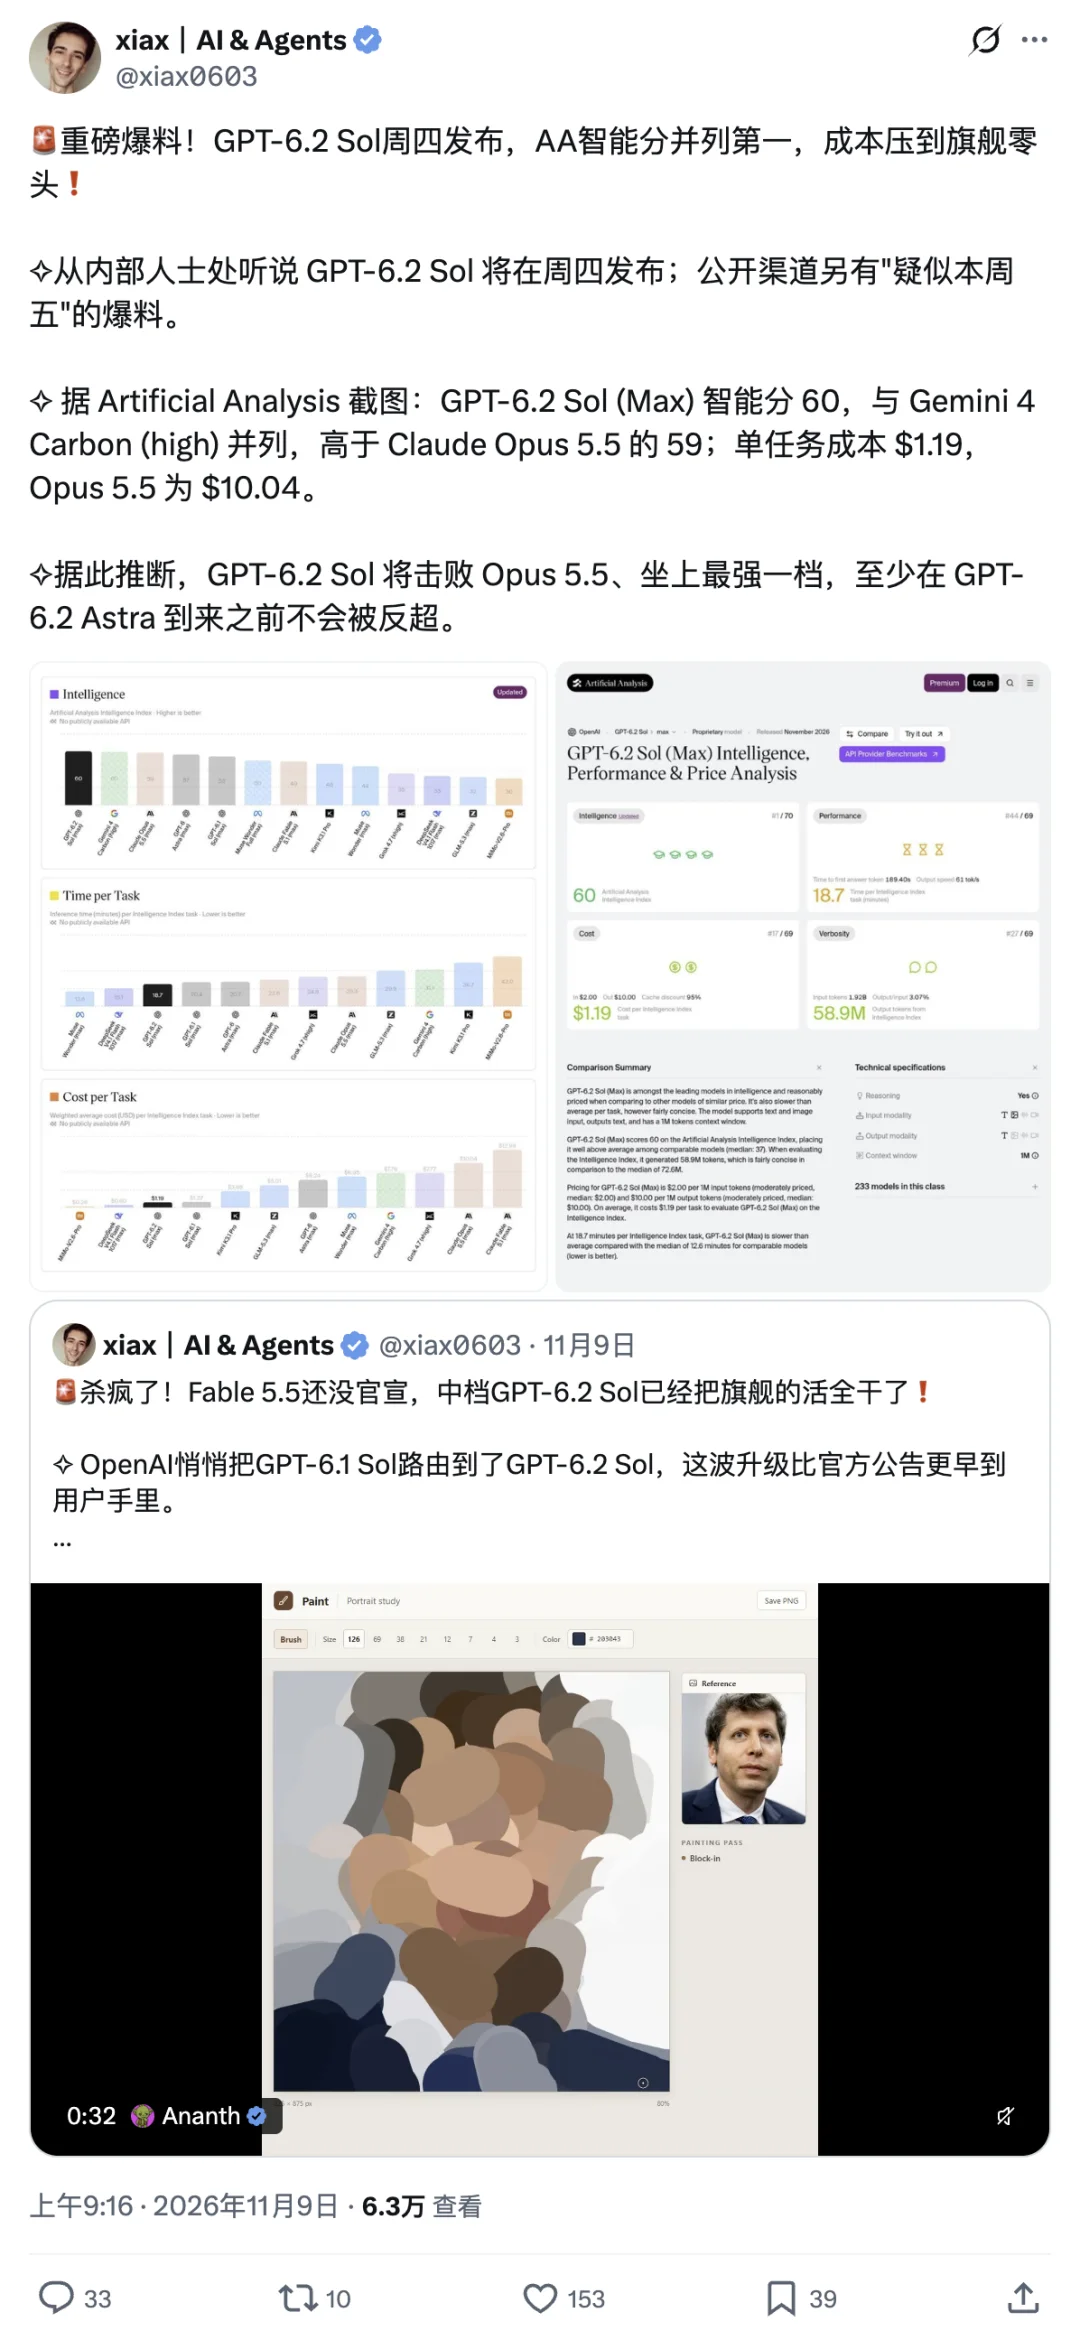
Den Zahlen im Bild zufolge kommt Sol im Intelligence Index auf 60 Punkte: Es zieht mit Googles Gemini 4 Carbon auf Platz eins gleich, liegt knapp vor Claude Opus 5.5 (59 Punkte), legt gegenüber dem Vorgänger GPT-6.1 Sol volle 5 Punkte zu und überholt sogar OpenAIs eigenes GPT-6 Astra – als erstes OpenAI-Modell überhaupt, das Opus 5.5 klar hinter sich lässt.
Noch spektakulärer lesen sich Dauer und Kosten: Eine komplexe Aufgabe dauert im Schnitt nur 18,7 Minuten und kostet $1.19 – rund ein Achtel von Opus 5.5 ($10.04).
Als gesichert sollte man das aber noch nicht nehmen. Wir haben die Website von Artificial Analysis und die OpenAI-Dokumentation am 12. November geprüft: In der AA-Rangliste taucht GPT-6.2 Sol nirgends auf, und die URL der Modellseite aus dem Screenshot liefert einen 404-Fehler. Stellt man die kursierenden Zahlen neben die Flaggschiff-Modelle, die bei AA tatsächlich online sind, klärt sich einiges auf:
| AA-Kennzahl | GPT-6.2 Sol (kursierender Screenshot) | GPT-6.1 Sol (max) | Claude Opus 5.5 (max) | Gemini 4 Carbon (high) |
|---|---|---|---|---|
| Intelligence Index | 60 | 55 | 59 | 60 |
| Zeit pro Aufgabe | 18,7 Min. | 21,9 Min. | 25,0 Min. | 25,7 Min. |
| Kosten pro Aufgabe | $1.19 | $1.27 | $10.04 | $7.76 |
| Output-Tokens im Intelligence Index | 58,9 Mio. | 63,7 Mio. | 218 Mio. | 205 Mio. |
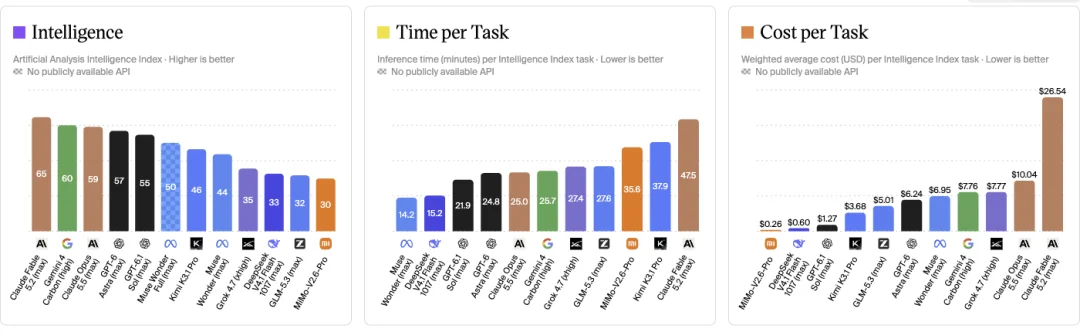
Zuerst zur Laufzeit. Die kolportierten 18,7 Minuten sind rund ein Viertel schneller als Opus 5.5 (25,0 Minuten) und Carbon (25,7 Minuten) – unter diesen Schwergewichten ist Sol damit das flotteste Modell. Zur Einordnung gehört aber auch: Der Median vergleichbarer Modelle liegt bei AA bei 12,8 Minuten. Es ist also schnell für ein Flaggschiff, aber nicht schnell im gesamten Feld.
Was die Community wirklich elektrisiert hat, ist die Rechnung über $1.19 pro Aufgabe – rund ein Achtel von Opus 5.5 und ein Fünftel von GPT-6 Astra ($6.24). Ein Blick auf die offiziellen Zahlen oben zeigt allerdings: Niedrige Kosten pro Aufgabe sind keine Neuheit von 6.2. Schon das längst verfügbare GPT-6.1 Sol liegt bei $1.27 pro Aufgabe – gerade einmal 8 Cent über den kolportierten $1.19. Wir finden: Wer eine günstige Alternative für den Alltag sucht, kann schon heute mit 6.1 Sol kalkulieren und muss nicht auf 6.2 warten.
Am Listenpreis pro Token liegt das nicht: GPT-6.1 Sol kostet $2 pro Million Input-Tokens und $10 pro Million Output-Tokens bei einem Kontextfenster von 1 Million Tokens – genau im Rahmen der Konkurrenz. Was die Rechnung drückt, ist die Kürze: Über den gesamten Intelligence-Index-Durchlauf erzeugte 6.1 Sol 63,7 Millionen Output-Tokens, während Opus 5.5 und Carbon jeweils über 200 Millionen lagen. Weil Sol deutlich knapper antwortet, bleiben die Kosten pro Aufgabe im Keller.
Eine Kostenfalle sollte man dabei kennen: Sowohl OpenAI als auch Google rechnen Reasoning-Tokens zum Output-Preis ab. Lässt du das Nachdenken unbegrenzt laufen, kostet ein einzelner Aufruf schnell ein Mehrfaches einer normalen Frage-Antwort-Runde.
Auch Demos fluten derzeit die Timelines. Aus einem einzigen Prompt spuckt das für einzelne Konten freigeschaltete Sol eine komplette 3D-Szene in Three.js aus, verpackt in eine einzige HTML-Datei – ohne Blender, ohne externe Assets. Schwarze Löcher, Segelboote oder ein Kolosseum drehen sich direkt im Browser und treten bei identischen Prompts gegen Opus 5.5 an. Ein Tester ließ es 3 Stunden am Stück laufen, baute mehrere Three.js-Demos und fand es besser als Opus 5.5.
Für normale Nutzer zählt vor allem die Abo-Rechnung. Für Plus-Abonnenten könnte Sol das größte und beste Upgrade seit Jahren werden: Im Alltag schlägt es Opus 5.5, ohne die Nutzungslimits vorschnell leerzusaugen – selbst im 5-Stunden-Fenster hält es durch. Damit ergibt OpenAIs 20-Dollar-Abo endlich wieder Sinn.
Allerdings stammen solche Aussagen überwiegend von Accounts, die Leaks und Vorab-Signale sammeln, und sind noch im Futur formuliert. Auf dem Papier klingt das hervorragend – solange das Modell aber nicht offiziell draußen ist, setzen wir dahinter lieber noch ein Fragezeichen.
Wer prüfen will, ob das eigene Konto schon stillschweigend auf das neue Modell umgeleitet wurde, nutzt in der Community einen einfachen Test: Wähle GPT-6.1 Sol (auf Max oder xhigh), schalte Websuche und Erinnerung aus und frag „do you know Claude Fable 5“ – kann es antworten, bist du im Rollout dabei. Wer bereits Zugriff hat, lobt außerdem einen angenehmen Tonwechsel: Statt sich wie früher in jedem Satz abzusichern und erst einmal alle Vorbehalte aufzuzählen, antwortet das Modell deutlich direkter.
Rund um den Release gab es zudem reichlich Nebelkerzen. Am 9. November veröffentlichte der Entwickler-Account von OpenAI einen 14-sekündigen Clip mit einem einzigen Wort – „Tomorrow.“ –, der über 2,4 Millionen Aufrufe sammelte. Fast die gesamte Timeline ging davon aus, dass am nächsten Tag das neue Modell erscheint:
 X · @OpenAIDevsTomorrow.Auf X ansehen
Am Tag darauf folgte die Auflösung: Es ging überhaupt nicht um ein Modell, sondern um einen Retro-Handheld im Game-Boy-Stil in OpenAIs Merch-Shop (ModRetro Chromatic).
Und von dem für Donnerstag angekündigten GPT-6.2 Sol fehlte auch am Donnerstag, dem 12. November, in OpenAIs offizieller Modelldokumentation jede Spur.
Noch sind das alles Stichproben aus einem begrenzten Testlauf, und die Herkunft des Benchmark-Screenshots ist ungeklärt. Erst wenn das Modell breit ausgerollt ist und Artificial Analysis eigene Messungen veröffentlicht, lässt sich Bilanz ziehen.
Neben Krypton werden aus Googles aktueller Generation vor allem Carbon und Argon miteinander verglichen – und die beiden haben völlig unterschiedliche Temperamente.
| Kennzahl | Gemini 4 Carbon (high) | Gemini 4 Argon (high) | Quelle |
|---|---|---|---|
| Intelligence Index | 60 | 50 | AA |
| Ausgabegeschwindigkeit | 80 Token/s | 65 Token/s | AA |
| Zeit bis zum ersten Antwort-Token | 67 s | 37 s | AA |
| Zeit pro Aufgabe | 25,7 Min. | 30,0 Min. | AA |
| Halluzinationsrate | 11 % | 4 % | AA-Omniscience |
| Vibe Code Bench | 89,06 % | 91,91 % | Vals AI (OpenHands) |
| Kontextfenster | 1 Mio. Tokens | 1 Mio. Tokens | |
| Input / Output pro 1 Mio. Tokens | $2 / $10 (ab 1. Dez. $4 / $20) | $2 / $10 (ab 1. Dez. $4 / $20) | Google-Preisseite |
Carbon erreicht 60 Punkte im Intelligence Index und bringt ein Kontextfenster von 1 Million Tokens mit; lange Dokumente, Cybersicherheit und ausdauernde autonome Läufe sind sein Heimspiel. Ebenso deutlich sind die Schwächen: 11 % Halluzinationsrate auf hoher Reasoning-Stufe und über eine Minute Wartezeit bis zum ersten Antwort-Token.
Argon liegt beim Gesamtwert eine Stufe tiefer – 50 Punkte im Intelligence Index –, punktet aber mit Verlässlichkeit: Die Halluzinationsrate sinkt auf 4 %, im Vibe Code Bench von Vals AI holt es 91,91 % (vor Carbon mit 89,06 % und Opus 5.5 mit 90,29 %), und bis zum ersten Antwort-Token vergehen nur rund 37 Sekunden.
Aber Vorsicht: Argon fängt nur schneller an zu schreiben. Über die gesamte Aufgabe gerechnet ist es sogar langsamer – bei AA braucht es im Schnitt 30,0 Minuten pro Aufgabe und damit über vier Minuten länger als Carbon (25,7 Minuten).
Beide starten bis zum 30. November zum Einführungspreis von $2 Input und $10 Output pro Million Tokens; ab dem 1. Dezember steigt der Preis wieder auf $4 und $20. Carbon war zum Start nur einer kleinen Gruppe von Cyber-Verteidigern zugänglich und steht seit dem 10. November allen zahlenden Entwicklern per API offen; im Free Tier sind beide Modelle nicht verfügbar.
Das langsame Tempo ist derzeit auch der größte Kritikpunkt an Carbon. Als Theo (t3.gg) dieselbe Programmieraufgabe stoppte, war Opus 5.5 auf der Stufe high nach 9 Min. 33 s fertig, während Carbon selbst auf der niedrigsten Stufe low volle 22 Min. 21 s brauchte.
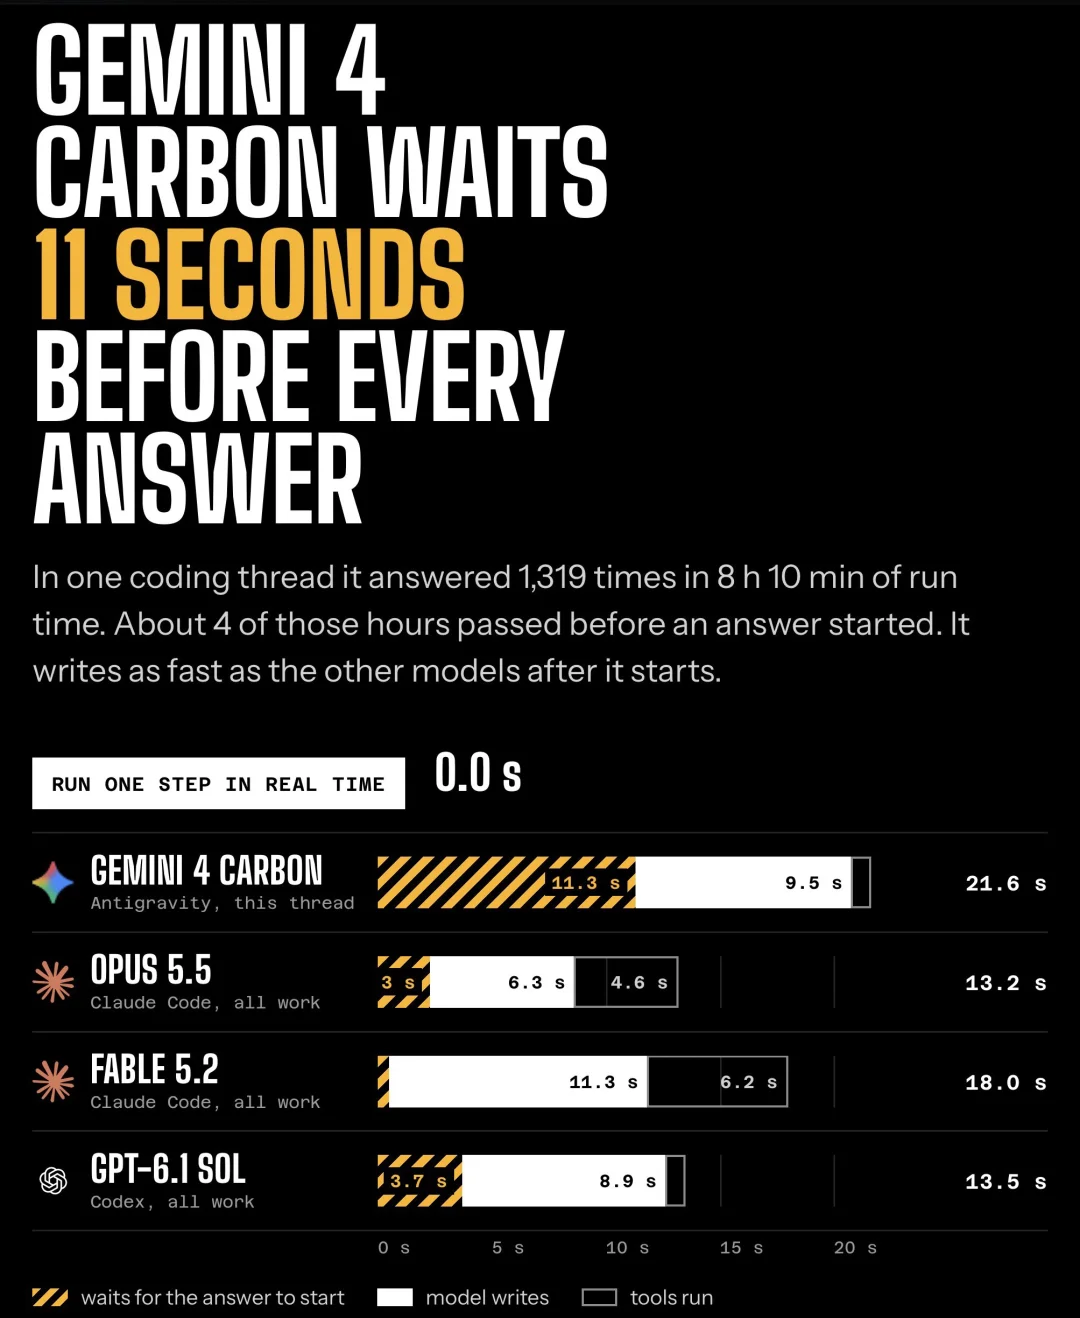
Zerlegt man einen einzelnen Schritt, sieht man sofort, wo die Zeit bleibt: Carbon wartet vor jeder Antwort über 11 Sekunden, bevor überhaupt das erste Wort kommt; danach schreibt es genauso schnell wie die Konkurrenz. In einer Sitzung von 8 Stunden und 10 Minuten mit 1.319 Antworten gingen rund 4 Stunden allein fürs Warten auf den Antwortbeginn drauf. Das Problem liegt fast vollständig auf Googles Serverseite, nicht am Modell selbst.
Dazu kommen knappe Kontingente. Selbst in Googles teuerstem Abo für 200 Dollar im Monat ist das Kontingent für die großen Gemini-4-Modelle winzig und im Nu aufgebraucht. Technisch liegt Google vorn, im Angebot für Endkunden kommt das aber noch nicht an.
Eine Zahlenreihe aus dem AA Intelligence Index lohnt einen eigenen Blick: Über den gesamten Benchmark-Durchlauf erzeugte Carbon 205 Millionen Output-Tokens, Argon 113 Millionen und GPT-6.1 Sol 63,7 Millionen. Gleiche Preisliste pro Token, völlig andere Rechnung am Ende: Nach der AA-Methode kostet eine Aufgabe mit Argon $9.95, mit Carbon $7.76 und mit GPT-6.1 Sol $1.27. Der Unterschied liegt allein darin, wie viel jedes Modell schreibt und wie lange es nachdenkt – genau die Reasoning-Rechnung von oben.
Beim Blick auf die Ranglisten sollte man außerdem auf den Zusatz in Klammern hinter dem Modellnamen achten: AA hat Carbon und Argon auf (high) getestet, Opus 5.5 und Sol dagegen auf (max). Weil Reasoning-Stufen und Agent-Harnesses zwischen den Anbietern nicht einheitlich sind, ist ein Abstand von einem oder zwei Punkten noch kein endgültiges Urteil.
Teilt man die Werkzeuge nach der Arbeit ein, ist die Rollenverteilung unter Testern ziemlich klar:
Kein Modell gewinnt in jeder Disziplin. Selbst wenn GPT-6.2 Sol wie kolportiert nach Punkten mit Carbon gleichzieht, dauert eine Aufgabe damit immer noch länger als im Median vergleichbarer Modelle; Carbon ist stark bei langen Läufen, verlangt aber Geduld beim Warten und hat eine höhere Halluzinationsrate; Argon arbeitet verlässlich, bleibt in der Spitze aber eine Stufe darunter. Und Opus 5.5 ist sowohl pro Token als auch pro Aufgabe ein Vielfaches teurer als Sol und braucht bei AA fast 6 Minuten bis zum ersten Antwort-Token – teuer und langsam, beim Schreiben von Code aber nach wie vor die verlässlichste Bank. Ein oder zwei Punkte Unterschied in der Tabelle fühlen sich an der eigenen Aufgabe völlig anders an.
Krypton und GPT-6.2 Sol lassen noch auf sich warten, aber genau diese Arbeitsteilung kannst du schon heute mit den vier verfügbaren Modellen fahren. Auf CodingPass teilen sich alle denselben API-Key; für den Wechsel änderst du nur die Modell-ID (die Monatskontingente je Tarif findest du unter Alle Modelle):
| Modell | Modell-ID | Jetzt verfügbar? | Mindesttarif auf CodingPass |
|---|---|---|---|
| Gemini 4 Krypton | — | Interne Tests bei Google | — |
| GPT-6.2 Sol | — | Begrenzter Test bei einzelnen Konten, unveröffentlicht | — |
| Gemini 4 Argon | gemini-4-argon | Verfügbar | Go |
| Gemini 4 Carbon | gemini-4-carbon | Verfügbar | Go |
| GPT-6.1 Sol | gpt-6.1-sol | Verfügbar | Plus |
| Claude Opus 5.5 | claude-opus-5-5 | Verfügbar | Plus |
Bevor du für eine Aufgabe ein Modell auswählst, entscheide zuerst, ob es um feine Details oder um Durchsatz geht, und stell danach die Reasoning-Stufe ein – das bringt im Alltag weit mehr als der Blick auf ein oder zwei Punkte Vorsprung in den Ranglisten. Gib bei kreativen Aufgaben eine hohe Stufe frei und lass dem Modell Zeit; dreh sie bei alltäglichen Fragen herunter, damit nicht schon für eine kurze Rückfrage eine lange Kette interner Überlegungen durchläuft. Rechnung und Wartezeit hängen meist genau an diesem Regler.
Die Release-Welle 2026 hat die Wahl des Werkzeugs zurück in die Hände der Nutzer gelegt. Statt auf das eine Übermodell für alles zu warten, zerlegst du deine Arbeit besser und schickst jede Aufgabe an das Modell, dem sie am besten liegt. Wenn es genug gute Werkzeuge gibt, ist kluges Auswählen mehr wert als Abwarten.
Mit einem Key zwischen Modellen wechseln, abgerechnet zu offiziellen API-Preisen. Keine Überraschungskosten, jederzeit kündbar.