Alle Modelle
Die ID jedes Modells, der Mindesttarif und das Monatskontingent in Go, Plus und Pro.
Alle reden darüber, wer die meisten Token generiert und wer besser schlussfolgert. Google hat ein Modell nachgelegt, das keine Antwort schreibt: Du gibst ihm Eingabe und ein paar Optionen, es rechnet alles in einem Durchgang und sagt dir, welche Option es wählt und wie sicher es sich ist. JevBench: 92,2 % Genauigkeit, $0.10 pro Million Eingabe-Token, Ausgabe kostenlos.
Die Branche misst sich daran, wer die meisten Token ausgibt und wer besser schlussfolgert. Google hat dagegen ein Modell veröffentlicht, das in die Gegenrichtung geht: Es schreibt keine Antwort Wort für Wort.
Am 11. November hat Google Gemini Decision 1 veröffentlicht, dazu die Gemini Decisions API, die darauf läuft. Das Modell trifft nur Entscheidungen: Du legst die Kandidaten fest, es führt einen einzigen Vorwärtsdurchlauf aus, bewertet jeden Kandidaten, und das war’s.
Kurz gesagt: Decision 1 schreibt keinen Text. Du gibst ein paar Optionen vor, und es sagt dir, welche es wählt. Klassifizierung, Routing, Tool-Auswahl und Compliance-Prüfungen, bei denen nur ein Ergebnis gebraucht wird, laufen damit schneller und günstiger, und jede Antwort kommt mit einer Konfidenz. Es kann aber nicht alles: Bei der Frage „Soll ich ein Tool aufrufen?“ gewinnt es in Googles eigener Tabelle nicht.
Googles CEO Sundar Pichai hat das Modell selbst auf X angekündigt.
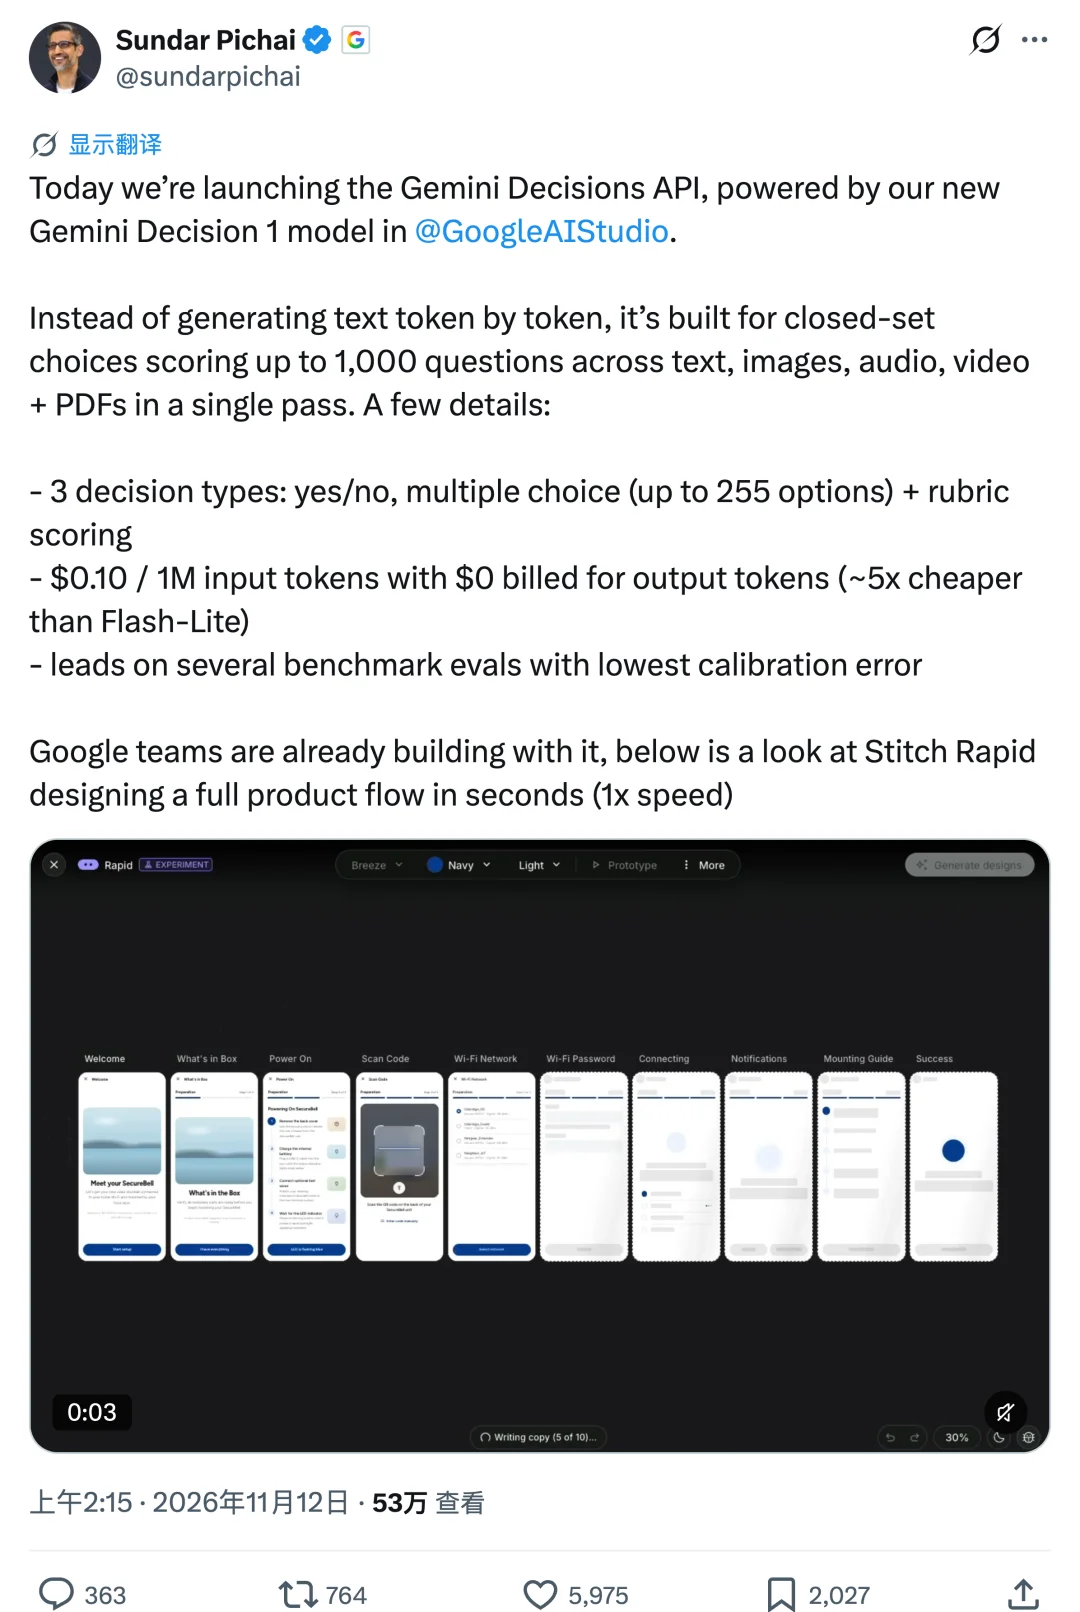
In seinem Post hebt er drei Punkte hervor:
Er sagt außerdem, dass Googles interne Teams das Modell schon nutzen. Dazu zeigt er eine Demo von Stitch Rapid in Originalgeschwindigkeit (1x): In wenigen Sekunden entsteht ein kompletter Produktablauf. Wie sich das Modell in echten Beispielen verhält, zeigt dieses Einstiegsvideo:
Bisher musstest du, wenn eine KI entscheiden sollte, ob eine E-Mail Spam ist oder welcher Agent eine Aufgabe bekommt, ein Generierungsmodell aufrufen, auf den Text warten und das Ergebnis aus dem Text herausparsen. Bei Decision 1 entfällt die Token-für-Token-Generierung ganz: Du gibst Eingabe, Fragen und Optionen vor, und das Modell liefert direkt die gewählte Option, die Wahrscheinlichkeit jeder Option und die Konfidenz.
Aufgaben, die nur eine Klassifizierung, einen Wert oder eine Auswahl brauchen, müssen damit nicht mehr durch die komplette Textgenerierung.
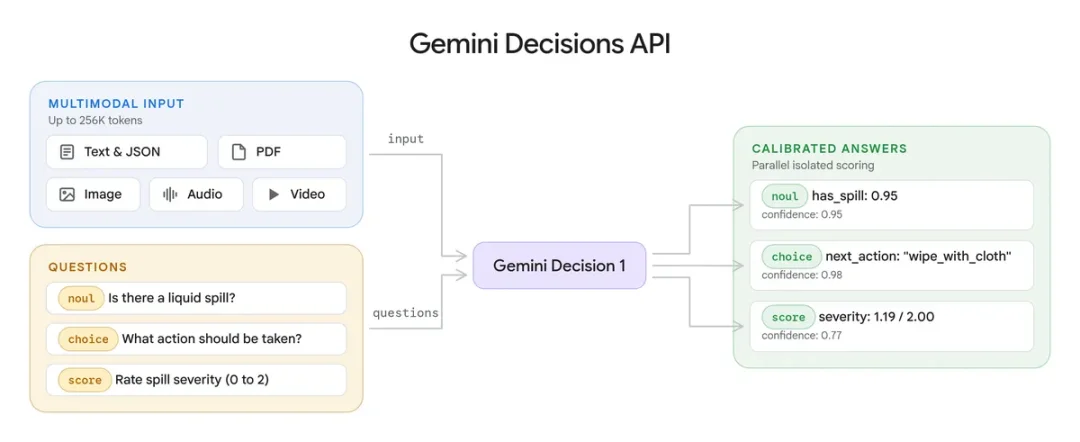
Laut Googles Angaben lassen sich in einer Anfrage bis zu 1.000 unabhängige Fragen stellen. Als Eingabe sind Text, Bilder, Audio, Video und PDF möglich, die End-to-End-Latenz liegt bei 150 bis 250 Millisekunden.
Auch beim Preis geht Google weit: $0.10 pro Million Eingabe-Token, Ausgabe kostenlos. In Googles gemeinsamer Auswertung ist das Modell über die Interactions API fast fünfmal günstiger als Gemini 3.5 Flash-Lite.
Google will das Modell nicht auf Auswahlfragen beschränken. Modell-Routing, die Tool-Auswahl von Agents, Produktdesign und Sicherheitsprüfungen laufen intern bereits damit. Ziel ist, dass es in KI-Systemen die Schicht bildet, die entscheidet.
Decision 1 kennt drei Fragetypen:
| Typ | Name in der API | Was es kann | Rückgabe |
|---|---|---|---|
| Ja / Nein | noul | Erkennen, ob auf einem Bild eine Gefahr zu sehen ist, ob ein Text gegen Regeln verstößt | Wahrscheinlichkeit, dass die Bedingung zutrifft |
| Mehrfachauswahl | choice | Aus 2 bis 255 Kandidaten den passendsten auswählen | Die gewählte Option und die normalisierte Wahrscheinlichkeit jeder Option |
| Geordnete Bewertung | score | Nach einer Skala bewerten, die du festlegst (beginnend bei 0) | Ein stetiger gewichteter Wert und die Wahrscheinlichkeit jeder Stufe |
Die drei Typen lassen sich in einer Anfrage kombinieren.
Googles Beispiel ist das Foto einer Arbeitsplatte in einer Büroküche, dazu ein kurzer Begleittext. Das Modell beantwortet gleichzeitig drei Fragen: Liegt Flüssigkeit auf der Platte, die nicht weggewischt wurde? Wie soll man sie beseitigen? Wie schwer ist der Vorfall?
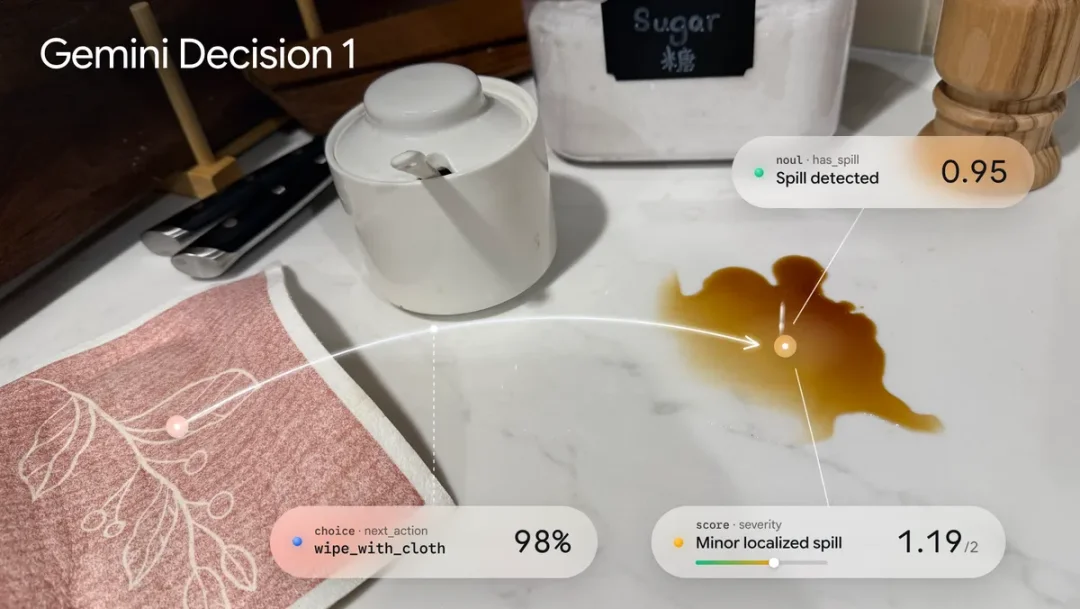
Früher hätte man dafür mehrere Klassifikatoren gebraucht oder mehrere Prompts für ein Generierungsmodell getrennt laufen lassen. Jetzt reicht eine Anfrage.
Der Eingabe-Kontext reicht bis zu 256K Token, und verschiedene Modalitäten lassen sich mischen. Im Unternehmen heißt das: Gesprächsaufnahme und Kundenakte gemeinsam auswerten oder Unterlagen zu einem Schadensfall und Fotos vom Ort zusammen prüfen.
Jede Entscheidung hat eine Konfidenz zwischen 0 und 1. Bei unsicheren Fällen kann das System direkt an ein anderes Modell oder an einen Menschen zur Prüfung übergeben.
Tempo und Kosten sind seine andere Stärke. Bei einem Kontext unter 16K Token liegt die mediane Latenz des Modells bei 50 bis 100 Millisekunden, die End-to-End-Latenz bei 150 bis 250 Millisekunden. Steigt die Zahl der Fragen in einer Anfrage von 1 auf 100, steigt die Latenz kaum. Die gemeinsame Eingabe wird pro Anfrage nur einmal berechnet; jede zusätzliche Frage kostet nur die Token für ihre eigene Beschreibung und ihre Optionen.
Dazu kommt eine Ergebnistabelle, die sich lohnt.
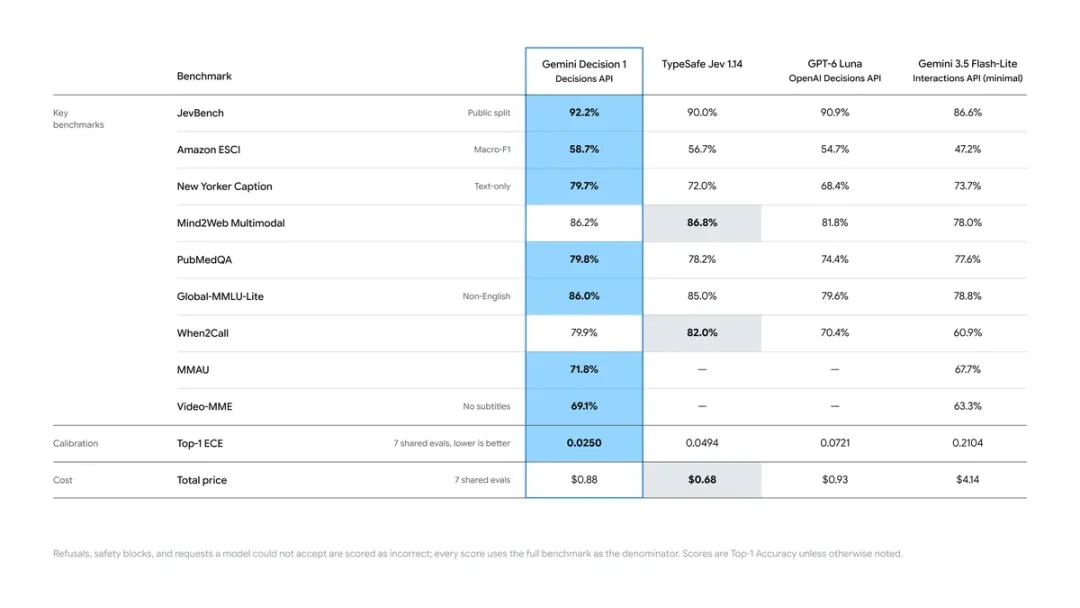
Meist vergleichen sich neue Modelle mit einer Reihe allgemeiner Sprachmodelle. Google hat dieses Mal drei Gegner aus derselben Kategorie gewählt: GPT-6 Luna über die Decisions API von OpenAI, TypeSafe Jev 1.14, das auf Klassifikationsentscheidungen spezialisiert ist, und das eigene Gemini 3.5 Flash-Lite.
| Benchmark | Decision 1 | TypeSafe Jev 1.14 | GPT-6 Luna | Flash-Lite |
|---|---|---|---|---|
| JevBench | 92,2 % | 90,0 % | 90,9 % | 86,6 % |
| Amazon ESCI (Macro-F1) | 58,7 % | 56,7 % | 54,7 % | 47,2 % |
| New Yorker Caption | 79,7 % | 72,0 % | 68,4 % | 73,7 % |
| Mind2Web Multimodal | 86,2 % | 86,8 % | 81,8 % | 78,0 % |
| PubMedQA | 79,8 % | 78,2 % | 74,4 % | 77,6 % |
| Global-MMLU-Lite (Nicht-Englisch) | 86,0 % | 85,0 % | 79,6 % | 78,8 % |
| When2Call | 79,9 % | 82,0 % | 70,4 % | 60,9 % |
| MMAU (Audio) | 71,8 % | — | — | 67,7 % |
| Video-MME (ohne Untertitel) | 69,1 % | — | — | 63,3 % |
| Top-1 ECE (niedriger ist besser) | 0,0250 | 0,0494 | 0,0721 | 0,2104 |
| Gesamtkosten 7 gemeinsame Evals | $0.88 | $0.68 | $0.93 | $4.14 |
Von 9 Benchmarks gewinnt Decision 1 7, bei der Kalibrierung liegt es ebenfalls vorn. Bei zwei Benchmarks und den Gesamtkosten ist die Konkurrenz besser.
Zuerst die Siege. Bei JevBench liegt es mit 92,2 % 1,3 Prozentpunkte vor GPT-6 Luna. Bei Amazon ESCI, der Relevanz von Produktsuchen, liegt es 4 Prozentpunkte vor Luna und 11,5 Prozentpunkte vor Flash-Lite.
Den größten Abstand gibt es bei New Yorker Caption. Dabei geht es darum, zu einem Cartoon die passende Bildunterschrift aus mehreren Kandidaten zu wählen, also Kontext zu verstehen und zwischen Optionen zu entscheiden. Decision 1 erreicht 79,7 %, Luna 68,4 %, ein Abstand von 11,3 Prozentpunkten. Bei der medizinischen Fragebeantwortung PubMedQA liegt es bei 79,8 %, Luna bei 74,4 %. Beim mehrsprachigen Global-MMLU-Lite liegt es bei 86,0 %, Luna bei 79,6 %.
Bei Audio (MMAU) und Video (Video-MME) haben nur Decision 1 und Flash-Lite Ergebnisse. Es erreicht 71,8 % bzw. 69,1 % und liegt damit jeweils vor Flash-Lite.
Bei Mind2Web Multimodal liegt TypeSafe Jev mit 86,8 % vorn, Decision 1 kommt auf 86,2 %, der Abstand beträgt 0,6 Prozentpunkte.
Bei When2Call ist Jevs Vorsprung deutlicher: 82,0 % gegen 79,9 %. Der Test prüft, ob und wann ein Tool aufgerufen werden soll. Genau dieser Agent-Fall ist einer von Googles Schwerpunkten, und trotzdem gewinnt das auf Entscheidungen spezialisierte Jev.
Auch bei den Gesamtkosten ist Decision 1 nicht am günstigsten. Über die 7 gemeinsamen Evals kostet Decision 1 $0.88, Jev nur $0.68. „Fast fünfmal günstiger“ bezieht sich auf Flash-Lite mit $4.14.
Unter der Tabelle steht außerdem eine Fußnote: Ablehnungen, Sicherheitsblockaden und Anfragen, die das Modell nicht verarbeiten kann, zählen als falsche Antwort. Der Nenner ist der gesamte Testsatz.
Google betont besonders die Kalibrierung der Wahrscheinlichkeiten. Beim Top-1 ECE (erwarteter Kalibrierungsfehler) liegt Decision 1 bei 0,0250, Jev bei 0,0494, Luna bei 0,0721 und Flash-Lite bei 0,2104. Der Kalibrierungsfehler ist damit rund 65 % niedriger als bei Luna und rund 88 % niedriger als bei Flash-Lite.
Für Agents ist das besonders wichtig. Soll ein Agent etwa beurteilen, ob ein Code-Abschnitt eine Sicherheitslücke enthält, gibt das Modell nicht nur „ja“ oder „nein“ aus, sondern auch eine Wahrscheinlichkeit. Wenn das Modell bei Antworten mit 90 % Konfidenz tatsächlich in neun von zehn Fällen richtig liegt, kann das System anhand der Wahrscheinlichkeit eine Grenze ziehen: Was darüber liegt, wird automatisch verarbeitet, was darunter liegt, geht an einen Menschen zur Prüfung. Bei schlecht kalibrierten Modellen lässt sich diese Grenze kaum sinnvoll setzen.
Viele neue Modelle zeigen nur Benchmarks. Google beschreibt dieses Mal außerdem vier Einsätze der Decisions API in eigenen Produkten.
Gemini Notebook: Routing der Modelle in Echtzeit. Das ist der interessanteste Fall. Jede Anfrage wird zuerst von der Decisions API auf ihre Komplexität geprüft, dann wird entschieden, welche Modellstufe sie bekommt und wie viel Denkaufwand sie erhält. Einfache Alltagsfragen gehen an das günstigere, schnellere Modell, komplexes Schlussfolgern an das starke Modell. Laut Google ist die Latenz bei alltäglichen Anfragen damit um bis zu 40 % gesunken.
Das passt zur Richtung, in die sich Agents entwickeln. Ein Agent trifft bei seiner Arbeit ständig kleine Entscheidungen: welches Tool er nimmt, welches Modell er aufruft, ob ein Mensch hinzugezogen werden soll. Gibt man jede einfache Entscheidung an ein großes Generierungsmodell, steigen Latenz und Kosten immer weiter. Ein eigenes Entscheidungsmodell teilt die Arbeit anders auf: Entscheidungen mit klaren Optionen gehen an ein Modell mit niedriger Latenz, komplizierte Aufgaben bleiben beim großen Allzweckmodell.
Stitch: klickbare Wireframes in wenigen Sekunden. Stitch hat mit Rapid Canvas ein experimentelles Feature eingeführt. Es nutzt die Decisions API, um in Sekunden klickbare Wireframes für Produktabläufe zu erzeugen. Nutzer ändern sie per Sprache oder Klick, die Reaktion kommt praktisch sofort. Passt die Richtung, lässt sich die Seite mit einem Klick in das vollständige Stitch übernehmen und dort weiter ausarbeiten. Die Demo in Sundars Post stammt aus diesem Feature.
CC: Emojis aus über 200 auswählen. Google Labs’ CC wählt damit blitzschnell aus über 200 Emojis die passende Reaktion aus, ohne dass der Chat langsamer wird.
Google Search: Sicherheitsschicht für MCP-Tools. Search hat die Decisions API intern als zusätzliche Sicherheitsprüfung für MCP-Tools eingebaut. Sie erkennt adversariales Verhalten und Inhalte, innerhalb des Latenzbudgets.
Du brauchst nur einen API-Key aus Google AI Studio, eine kostenlose Stufe reicht für Prototypen. Google stellt drei Demo-Apps bereit: Doorstep Parcels, Speed Sketch und Find the Zoo Keeper. Die Dokumentation enthält Anleitungen für Python, JavaScript und REST.
Neben dem google-genai SDK sind Integrationen für OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit und OpenCode nach und nach verfügbar. Gemini auf Google Cloud soll später ebenfalls unterstützt werden.
Alle Modelle werden zu offiziellen API-Preisen abgerechnet. Keine Überraschungskosten, jederzeit kündbar.