全部模型
每个模型的 ID、最低档位,以及在 Go、Plus、Pro 上的月额度。
Anthropic 发布 Claude Fable 5.2:编程、电脑操作、机器人评测都比上一代高出一截,High 推理强度就追平 Opus 5.5 的 Max,官方价降 20%。本文整理官方数据,讲清推理强度怎么选、在 Pro 上怎么用,最后是小编体感。
Anthropic 发布了 Claude Fable 5.2,同时发布的还有 Claude Mythos 5.2。两者是同一个底层模型:Fable 带严格的网络安全和生物安全防护,所有人都能用;Mythos 去掉了部分防护,只开放给通过 Anthropic 网络安全验证计划和生命科学计划的机构。
对写代码的人来说,要看的是 Fable 5.2。在 Anthropic 评测的几乎所有能力上,它都超过了 Opus 5.5;生成速度比 Fable 5.1 最多快 30%,官方价降了 20%。CodingPass Pro 的主打模型已经换成 Fable 5.2。本文整理官方数据,讲清推理强度怎么选、在 Pro 上怎么用,最后是小编这几天的体感。
一句话:Pro 用户把模型 ID 换成 claude-fable-5-2 就能用。日常用 Medium 推理强度,难题再开 Xhigh。官方价降到每百万 token $8 输入、$40 输出,CodingPass 按官方价计量,同一份额度能多跑约 25% 的 token。
官方公布了 Fable 5.2 和上一代 Fable 5.1、Opus 5.5、GPT-6 Astra、Gemini 4 Carbon 的对比。绿色一列是 Fable 5.2。
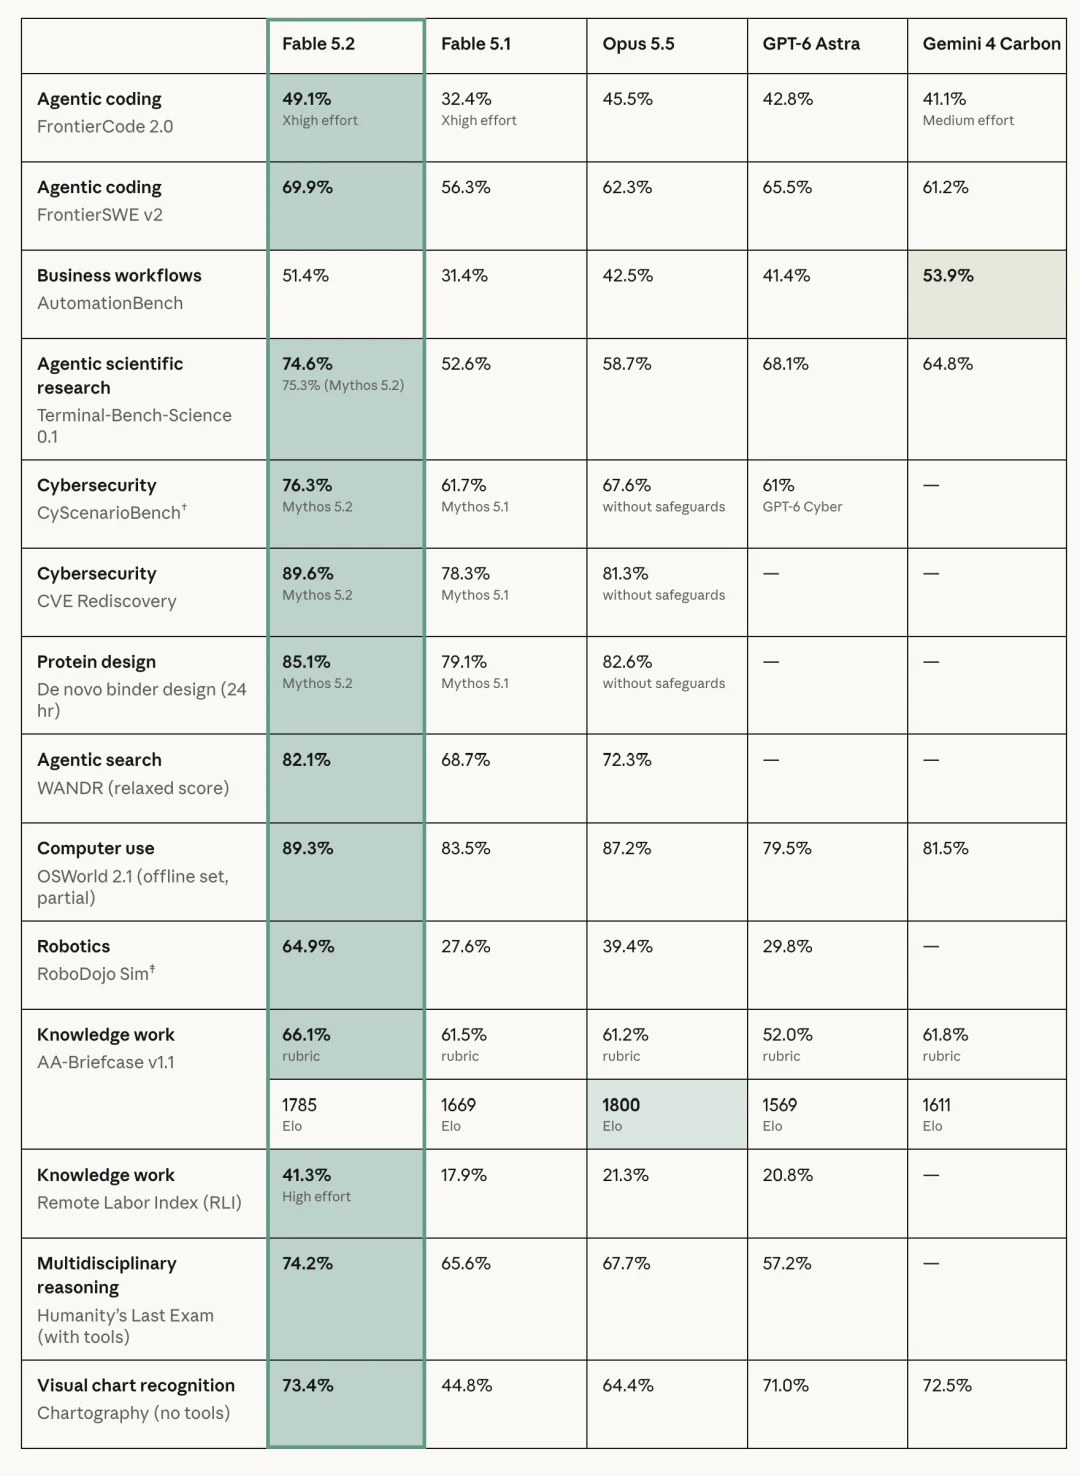
和写代码关系最大的几项:
编程。FrontierCode 2.0 49.1%(Xhigh),FrontierSWE v2 69.9%,都是参评模型里最高。Opus 5.5 是 45.5% 和 62.3%,GPT-6 Astra 是 42.8% 和 65.5%。
电脑操作。OSWorld 2.1 89.3%,Opus 5.5 是 87.2%。
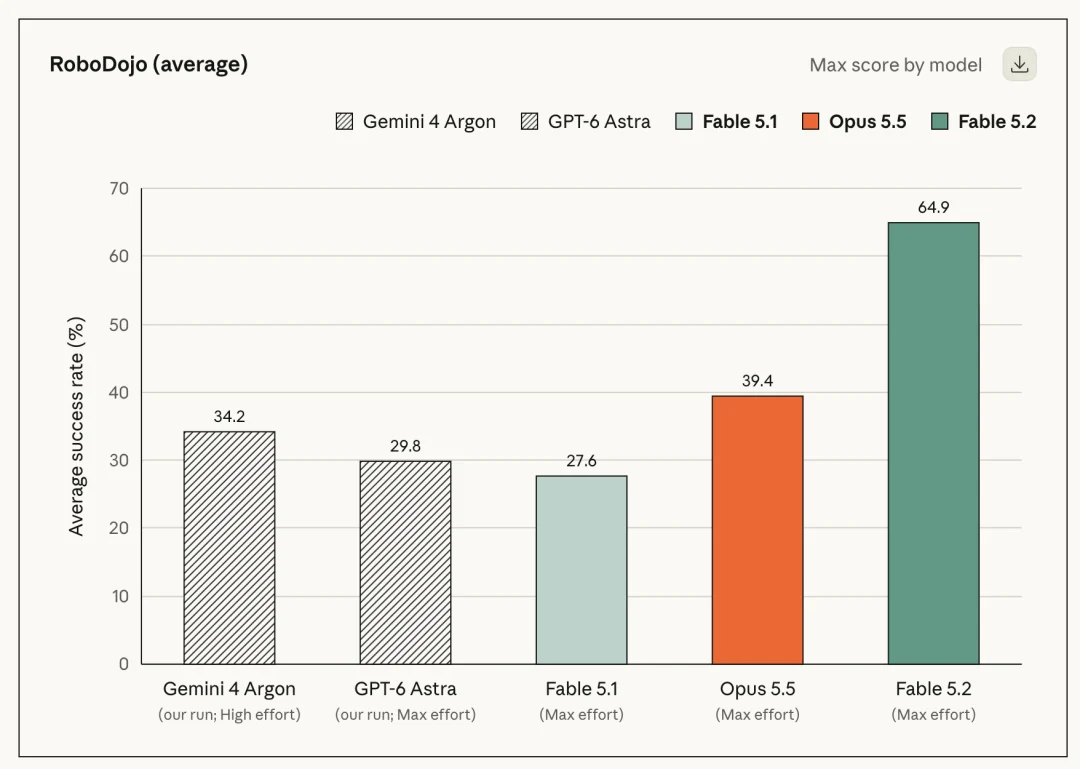
机器人。RoboDojo Sim 从 Fable 5.1 的 27.6% 涨到 64.9%,是这次涨得最多的一项。
不是每项都第一。AutomationBench 上 Gemini 4 Carbon 的 53.9% 高于 Fable 5.2 的 51.4%;AA-Briefcase 的 Elo 是 Opus 5.5 的 1800 略高于 Fable 5.2 的 1785。网络安全和蛋白质设计的高分来自 Mythos 5.2,不是 Fable。
这次最实用的一张图,是 FrontierCode 2.0 上分数和单任务成本的关系。
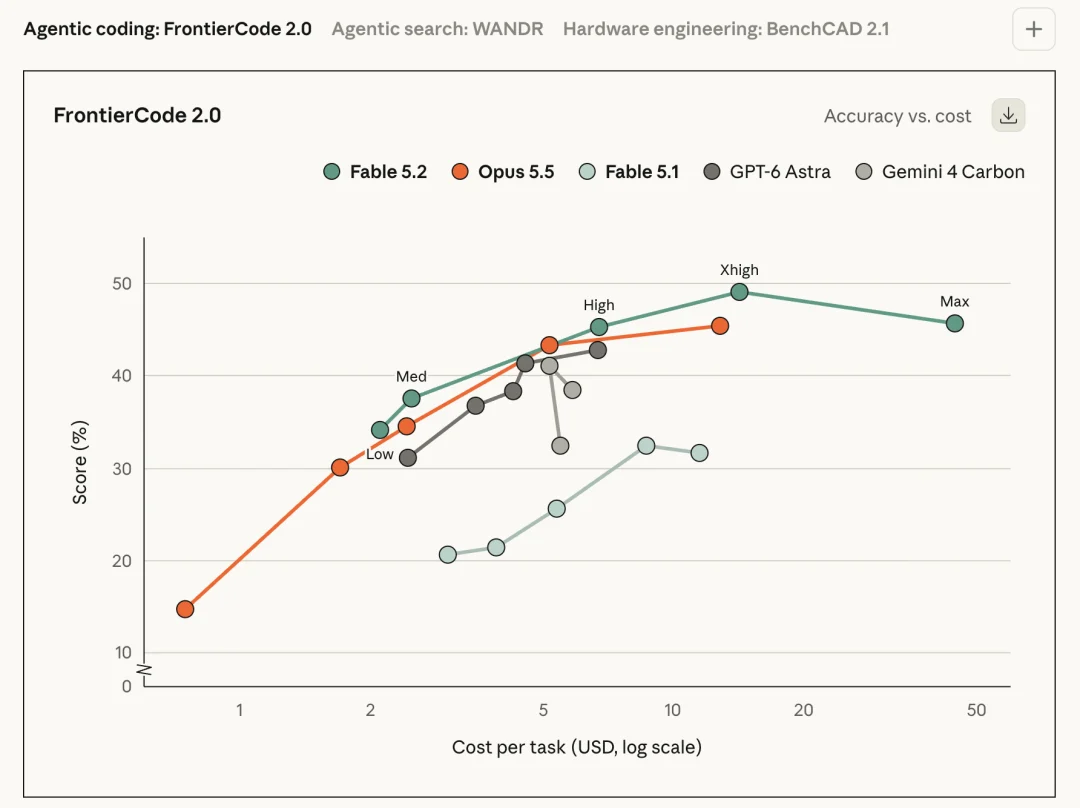
Medium 是 Claude 应用和 Claude Code 的默认设置。在这一档,Fable 5.2 完成高难任务用的 token 比 Fable 5.1 少。
High 的成绩和 Opus 5.5 开到 Max 大致相当,单任务成本只有后者一半左右。
Xhigh 超过了所有已发布模型的所有推理强度。
Max 的分数反而比 Xhigh 低一点,成本却约是 Xhigh 的 3 倍。最高档不等于最好。
官方价从 Fable 5.1 的每百万 token $10 输入、$50 输出,降到 $8 和 $40。另有可选的快速模式(Fast Mode),生成速度最高是标准模式的 2.5 倍,价格翻倍。
| 模型 | 输入 | 输出 |
|---|---|---|
| Fable 5.2 | $8 | $40 |
| Fable 5.2 快速模式 | $16 | $80 |
| Fable 5.1 | $10 | $50 |
CodingPass 的额度按各厂商官方 API 价计量,所以降价直接落到你的额度上:同一份 $500 的 Fable 额度,按 $8 / $40 计,比按 $10 / $50 计能多跑约 25% 的 token。
官方公告里的案例很多,挑几个和工程最相关的。
Python 迁到 Rust。一组由早期版本 Fable 5.2 驱动的 Agent,把一项关键生产服务从 Python 迁到 Rust,效率和可靠性都提升了,启动速度约为原来的 26 倍。
从空文件夹写出一个操作系统。Fable 5.2 协调 1000 多个子 Agent,连续 8 天写代码、测试、审查,做出一个能在笔记本上启动的原型系统:有自己的内核,磁盘、键盘和网络驱动,持久化文件存储、窗口系统、登录界面和安装程序。
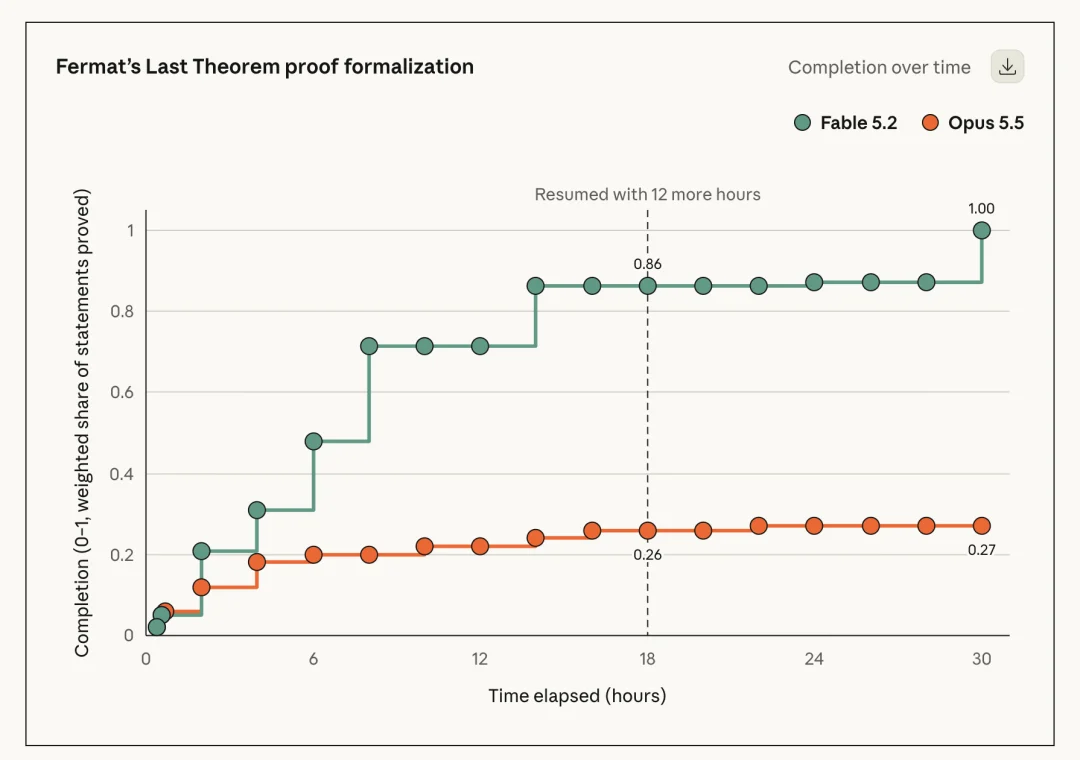
30 小时形式化费马大定理。1000 个 Fable 5.2 Agent 几乎没有人工干预,30 小时完成整个定理的形式化。同样的配置,Opus 5.5 跑了 18 小时只完成 26%,跑到 30 小时也几乎没再前进。
硬件。只给一段简短提示,Fable 5.2 自己写规格、选元器件、画四层电路板、建外壳模型、写软件,做出了三款能用的设备:家用语音助手中枢、USB 扬声电话和一款手持虚拟宠物,电路一次都没改。
机器人。在 RoboDojo 上,Fable 5.2 通过摄像头图像控制模拟的双臂机器人,平均成功率 64.9%,超过了同一测试框架下的其他前沿模型。
Fable 5.2 在 Pro 上可用,Pro 每月 $100。
接入 CodingPass。还没接的话,设好 ANTHROPIC_BASE_URL 和 ANTHROPIC_AUTH_TOKEN,步骤见 Claude Code 接入指南。
换模型 ID。启动时指定,或者在会话里切换。
claude --model claude-fable-5-2 # 启动时指定/model claude-fable-5-2 # 会话中切换留好请求 ID。每个响应都带 x-request-id 响应头,和控制台用量明细里的是同一个 ID,你和支持都能按它查到这次请求。
Codex、OpenCode 和 Cline 也一样,在模型列表里填 claude-fable-5-2。
最后是小编这几天用下来的感受,不是评测,仅供参考。
Medium 就够日常用。Fable 5.2 的 Medium 比 Opus 5.5 的 High 更稳,速度也快。改 bug、加功能、写测试,不用往上调。
Xhigh 留给真正的难题。一周里总有一两个 Opus 啃不动的问题:跨模块的重构、说不清原因的偶发 bug、要先读懂一大片老代码的需求。这时开 Xhigh,往往一轮就能给出靠谱的方案。Max 不用急着开,上面的成本曲线已经说明它不划算。
需求模糊也能接住。以前要把需求拆得很细,现在给一个方向,它会先补齐假设、列出方案再动手。工程判断比上一代成熟,官方也专门提了这一点。
额度还是要省着用。降价归降价,长时间开着 Xhigh 跑 Agent,额度掉得依然很快。小编的做法是难题交给 Fable 5.2,日常活交给 Opus 5.5 或 Sonnet 5.5,在 Claude Code 里用 /model 随时切。
别指望它做安全研究。漏洞复现、渗透相关的任务大多会被防护拦下。这是 Fable 和 Mythos 的分工,不是 bug。
最意外的是硬件。电路板、外壳、嵌入式软件这一路超出预期,做硬件或嵌入式的值得专门试试。
新模型刚上线,正适合拿它清一清积压的难题。
Pro 含 Fable 5.2,按官方 API 价计量。不会意外扣费,随时取消。