全部模型
每个模型的 ID、最低档位,以及在 Go、Plus、Pro 上的月额度。
大家还在比谁生成的 token 多、谁推理更强,谷歌反手发了一个不写答案的模型:给它输入和几个选项,它一次算完,直接告诉你选哪个、有几成把握。JevBench 准确率 92.2%,每百万输入 token 只要 $0.10,输出不收钱。
整个行业还在比谁能吐出更多 token、谁的推理更强,谷歌这次发了一个反过来的模型:它不逐字生成答案。
11 月 11 日,谷歌发布 Gemini Decision 1,以及由它驱动的 Gemini Decisions API。这个模型只管做判断:你先把候选答案列好,它做一次前向计算,给每个候选打分,就结束了。
一句话:Decision 1 不写文字,你给几个选项,它直接告诉你选哪个。分类、路由、选工具、合规检查这类本来只要一个结果的活,交给它更快也更便宜,每个答案还带一个可信的置信度。但它不是全能的:“该不该调工具”这一项,谷歌自己的评测表上它没赢。
谷歌 CEO Sundar Pichai 在 X 上亲自发帖介绍了它。
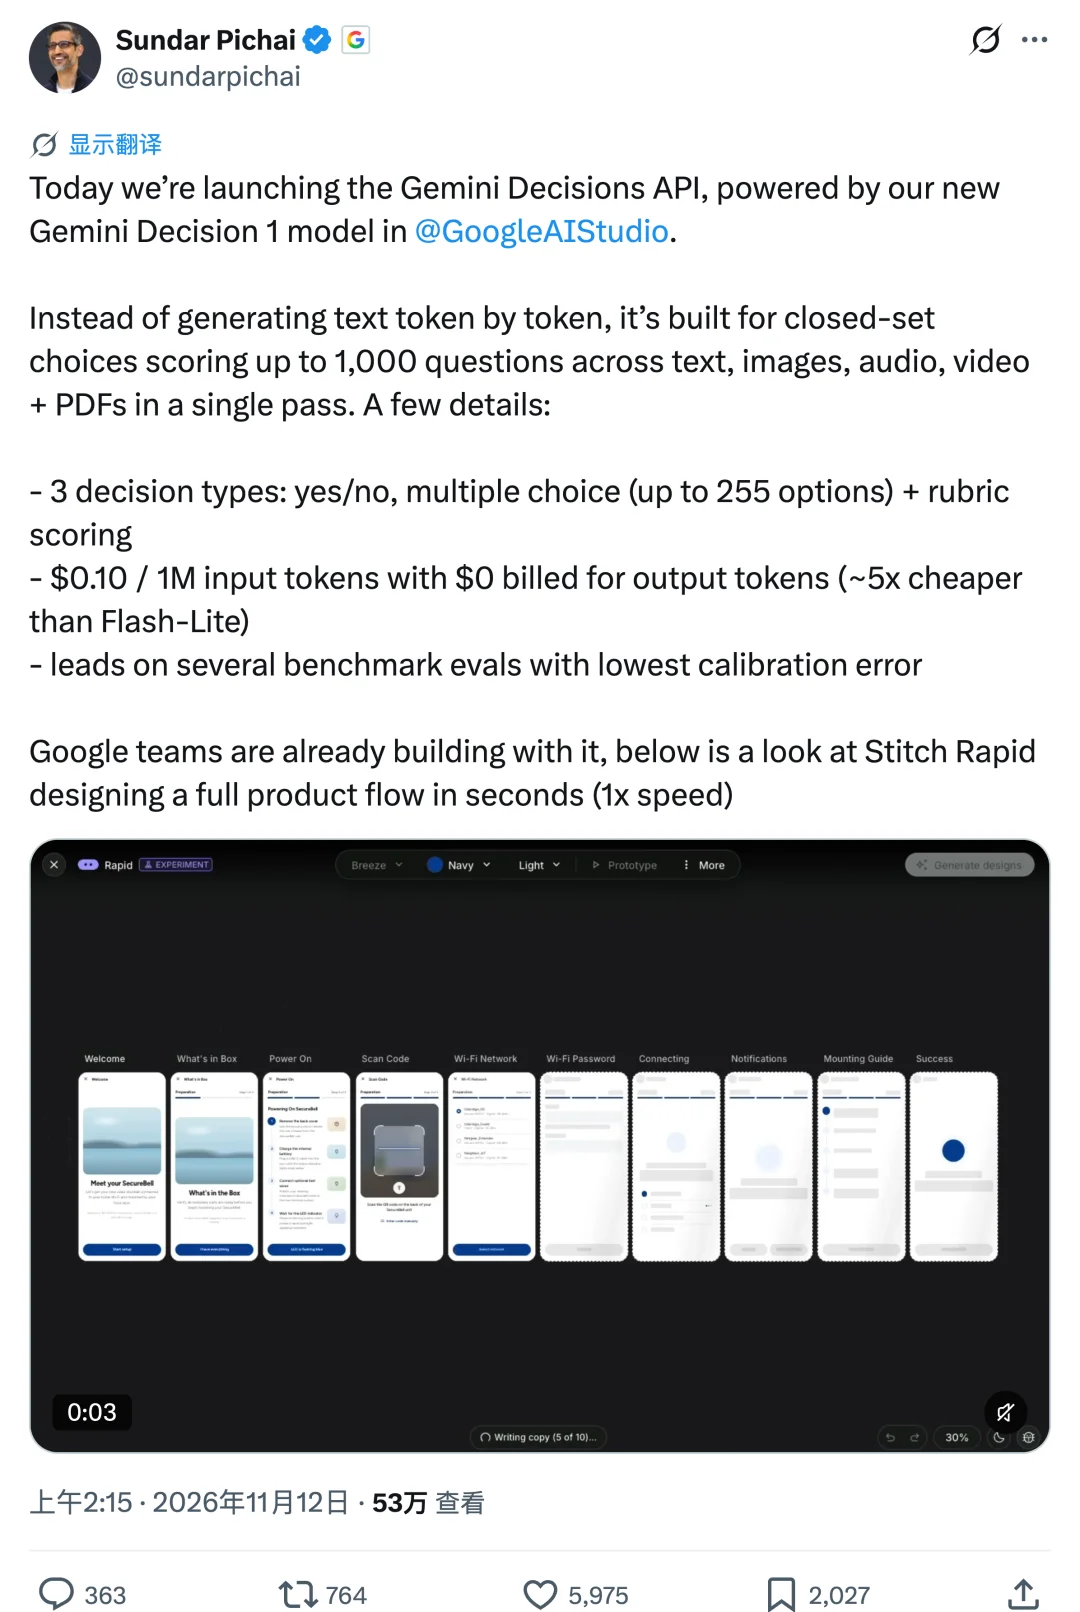
帖子里他点了三处细节:
他还说,谷歌内部团队已经在用,并贴了一段 Stitch Rapid 的 1 倍速演示:几秒钟设计出一整套产品流程。想看它在真实例子里怎么跑,可以看这段上手视频:
以前想让 AI 判断一封邮件是不是垃圾邮件,或者决定一个任务该派给哪个 Agent,通常得调一次生成模型,等它写出一段文字,再从文字里把结果解析出来。Decision 1 把逐字解码这一步整个省掉了:你给输入、问题和候选选项,它直接返回选了哪个、每个选项的概率和置信度。
本来只要一个分类、一个分数、一个选择的任务,从此不用再走完一整套文本生成。
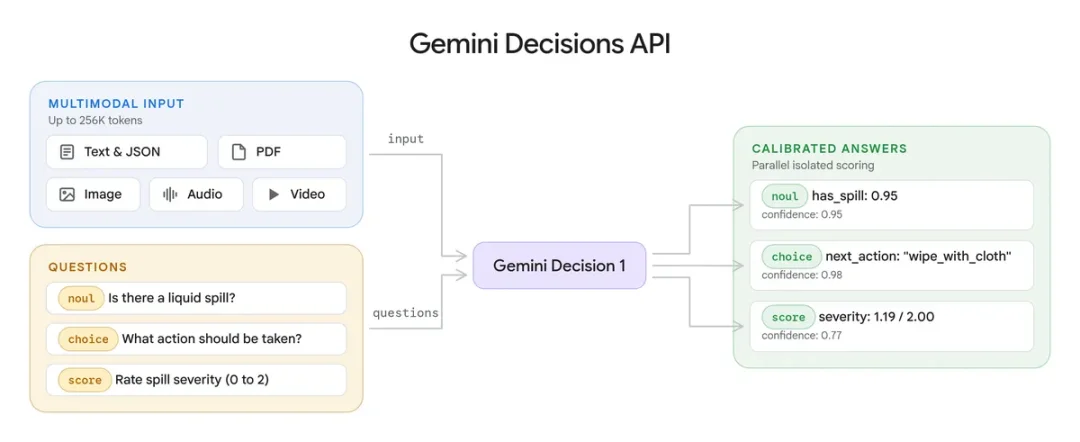
按谷歌公布的数字,一次请求最多能问 1000 道独立的题,输入可以是文本、图片、音频、视频和 PDF,端到端延迟 150~250 毫秒。
价格给得也狠:每百万输入 token $0.10,输出不收费。在谷歌那组共同评测上,它比通过 Interactions API 调 Gemini 3.5 Flash-Lite 便宜将近 5 倍。
谷歌也没打算只让它做选择题。模型路由、Agent 选工具、产品设计、安全检测,这几个场景谷歌内部都已经用上了,想让它成为 AI 系统里专门负责拍板的那一层。
Decision 1 提供三种题型:
| 题型 | API 里的名字 | 能做什么 | 返回什么 |
|---|---|---|---|
| 是 / 否 | noul | 图里有没有安全隐患,一段文字有没有违规 | 条件成立的概率 |
| 多项选择 | choice | 从 2~255 个候选里挑最合适的 | 胜出的选项,以及每个选项归一化后的概率 |
| 有序评分 | score | 按你定的等级(从 0 开始)打分 | 连续的加权分数,以及每一档的概率 |
三种题可以混在一个请求里一起问。
谷歌给的例子是一张办公室茶水间台面的照片,配一句文字说明,同时问三件事:台面上有没有没擦的液体,该怎么收拾,情况有多严重。
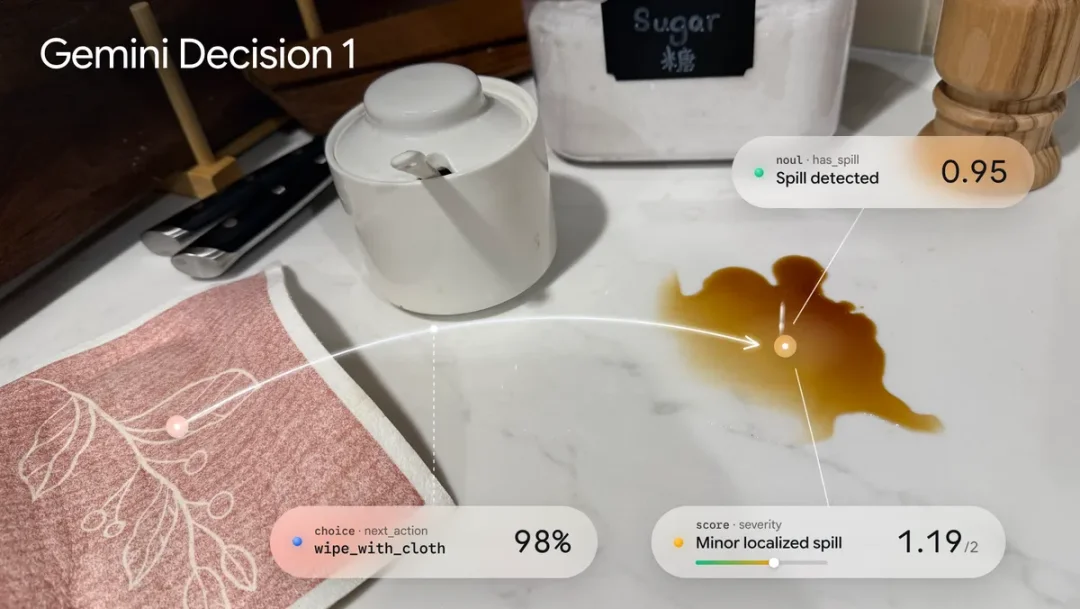
放在以前,这得做好几个分类器,或者给生成模型写几套提示词分别跑。现在一个请求就够了。
输入上下文最长 256K token,而且能混着放不同模态。放到企业里,就是把通话录音和客户资料放在一起判断,或者把保险理赔文件和现场照片一起看。
每个判断都带一个 0~1 的置信度。拿不准的,系统可以直接转给别的模型或者人工复核。
速度和成本是它的另一张牌。上下文在 16K token 以内时,模型计算的中位延迟是 50~100 毫秒,端到端 150~250 毫秒;一个请求里的题从 1 道加到 100 道,延迟几乎不涨。共享的输入每次请求只算一次钱,每多一道题,只多算它自己的说明和选项那点 token。
谷歌这次还放出了一份很有看点的成绩单。
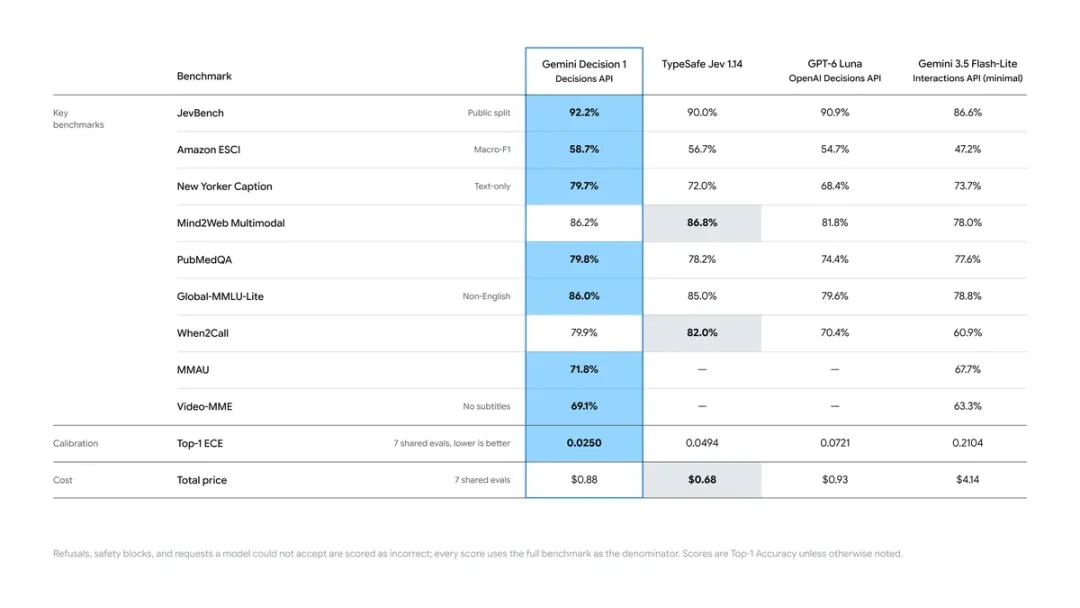
通常新模型会拉一群通用大模型来比,这次谷歌挑的三个对手都是同一路的:OpenAI Decisions API 上的 GPT-6 Luna、专做分类决策的 TypeSafe Jev 1.14,以及自家的 Gemini 3.5 Flash-Lite。
| 评测 | Decision 1 | TypeSafe Jev 1.14 | GPT-6 Luna | Flash-Lite |
|---|---|---|---|---|
| JevBench | 92.2% | 90.0% | 90.9% | 86.6% |
| Amazon ESCI(Macro-F1) | 58.7% | 56.7% | 54.7% | 47.2% |
| New Yorker Caption | 79.7% | 72.0% | 68.4% | 73.7% |
| Mind2Web Multimodal | 86.2% | 86.8% | 81.8% | 78.0% |
| PubMedQA | 79.8% | 78.2% | 74.4% | 77.6% |
| Global-MMLU-Lite(非英语) | 86.0% | 85.0% | 79.6% | 78.8% |
| When2Call | 79.9% | 82.0% | 70.4% | 60.9% |
| MMAU(音频) | 71.8% | — | — | 67.7% |
| Video-MME(无字幕) | 69.1% | — | — | 63.3% |
| Top-1 ECE(越低越好) | 0.0250 | 0.0494 | 0.0721 | 0.2104 |
| 7 项共同评测总价 | $0.88 | $0.68 | $0.93 | $4.14 |
9 项里 Decision 1 拿了 7 项第一,校准也排第一,但有两项和总价上,对手更好。
先看赢的。JevBench 上它是 92.2%,比 GPT-6 Luna 高 1.3 个百分点。商品搜索相关性的 Amazon ESCI 上,它比 Luna 高 4 个百分点,比 Flash-Lite 高 11.5 个百分点。
差距最大的是 New Yorker Caption:给漫画挑配文,考的是读懂语境、在候选里做判断。Decision 1 79.7%,Luna 68.4%,差了 11.3 个百分点。医学问答 PubMedQA 上它 79.8%,Luna 74.4%;多语言的 Global-MMLU-Lite 上它 86.0%,Luna 79.6%。
音频理解 MMAU 和视频理解 Video-MME 只有它和 Flash-Lite 有成绩,它分别是 71.8% 和 69.1%,都比 Flash-Lite 高。
Mind2Web Multimodal 上,TypeSafe Jev 86.8% 排第一,Decision 1 86.2%,差 0.6 个百分点。
When2Call 上 Jev 的优势更明显:82.0% 对 79.9%。这一项考的是该不该调工具、什么时候调,恰恰是谷歌主推的 Agent 场景,专做决策的 Jev 还是赢了。
总价也不是它最低。7 项共同评测跑下来,Decision 1 花了 $0.88,Jev 只要 $0.68。“便宜近 5 倍”比的是 Flash-Lite 的 $4.14。
另外表下有一行小字:拒答、被安全拦截、模型接不了的请求都按答错算,分母是完整测试集。
谷歌这次专门强调的是概率校准。Top-1 ECE(预期校准误差)上,Decision 1 是 0.0250,Jev 0.0494,Luna 0.0721,Flash-Lite 0.2104。算下来,它的校准误差比 Luna 低约 65%,比 Flash-Lite 低约 88%。
这个指标对 Agent 尤其重要。比如让 Agent 判断一段代码有没有安全漏洞,模型不光答“有”或“没有”,还给一个概率。如果模型说九成把握的时候真的十次对九次,系统就可以放心地按概率划线:高于线的自动处理,低于线的交给人工复核。校准差的模型,这条线很难划准。
不少新模型只放跑分,谷歌这次还讲了 Decisions API 在自家产品里的四个用法。
Gemini Notebook:实时模型路由。 这是最值得看的一个。每条请求进来,先用 Decisions API 判断它有多复杂,再决定交给哪一档模型、开多深的思考。日常的简单问题走更便宜、更快的模型,复杂推理再交给强模型。谷歌说,这样日常查询的延迟最多降了 40%。
这和现在 Agent 的走向是一致的。一个 Agent 干活时要不停地做小决定:用哪个工具,调哪个模型,要不要叫人来看。每个简单决定都交给大型生成模型,延迟和成本就一直往上堆。专门的决策模型给了另一种分工:选项明确的判断交给低延迟模型,复杂的活留给通用大模型。
Stitch:几秒出一套线框图。 Stitch 新推出的 Rapid Canvas 实验功能用 Decisions API 在几秒钟内生成能点的产品流程线框图,用户用语音或点击改,几乎立刻响应。方向定了,一键把页面转进完整的 Stitch 里接着打磨。Sundar 帖子里那段演示就是它。
CC:从 200 多个 Emoji 里挑表情。 Google Labs 的 CC 用它在一瞬间从 200 多个 Emoji 里选出合适的表情回应,不给对话添延迟。
Google Search:MCP 工具的安全层。 Search 内部用 Decisions API 给 MCP 工具加了一层安全检测,在延迟预算之内识别对抗性的行为和内容。
在 Google AI Studio 拿一个 API key 就能用,有免费层可以做原型。谷歌放了 Doorstep Parcels、Speed Sketch、Find the Zoo Keeper 三个演示应用,文档里有 Python、JavaScript 和 REST 的接入指南。
除了 google-genai SDK,OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit 和 OpenCode 的集成也在陆续上线,Google Cloud 上的 Gemini 之后也会支持。
所有模型都按官方 API 价计量。不会意外扣费,随时取消。