全部模型
每个模型的 ID、最低档位,以及在 Go、Plus、Pro 上的月额度。
两周前刚发 Argon,转头又甩出 Carbon:发布当天拿下两个榜单第一,现在开放给所有付费开发者,价格和 Argon 一样。但谷歌自己说,大多数活儿还是交给 Argon。Carbon 强在哪、短在哪,同价为什么账单更厚,什么时候该切过去。
10 月 28 日,Gemini 4 Carbon 发布。当天,Artificial Analysis 智能指数第一、Arena 文本榜第一,都换成了谷歌的名字。离上一个模型 Gemini 4 Argon 发布,才过去两周。
发布时它只开放给一小批网络安全防御方,跑分看得见,模型摸不着。11 月 10 日,谷歌把 API 开放给了所有付费开发者,价格一分没涨:和 Argon 一样,每百万 token 输入 $2、输出 $10。
同价还更强,那还用想?谷歌自己先泼了盆冷水。开放公告里写得很直白:大多数软件工程和知识类工作,Argon 仍然是更合适的选择。Carbon 是留给难题的,它会花比 Argon 多得多的 token 去探索、推理、反复验证。
一句话:Carbon 是给难题准备的,不是 Argon 的升级替换。跨模块重构、找不到原因的 bug、要连续跑很久的 Agent 任务,切到 Carbon;日常改代码、写测试,继续用 Argon。Carbon 单价不贵,但想得久、输出多,一个任务算下来并不便宜,12 月 1 日起单价还要翻倍。CodingPass 的 Go、Plus、Pro 都能用。
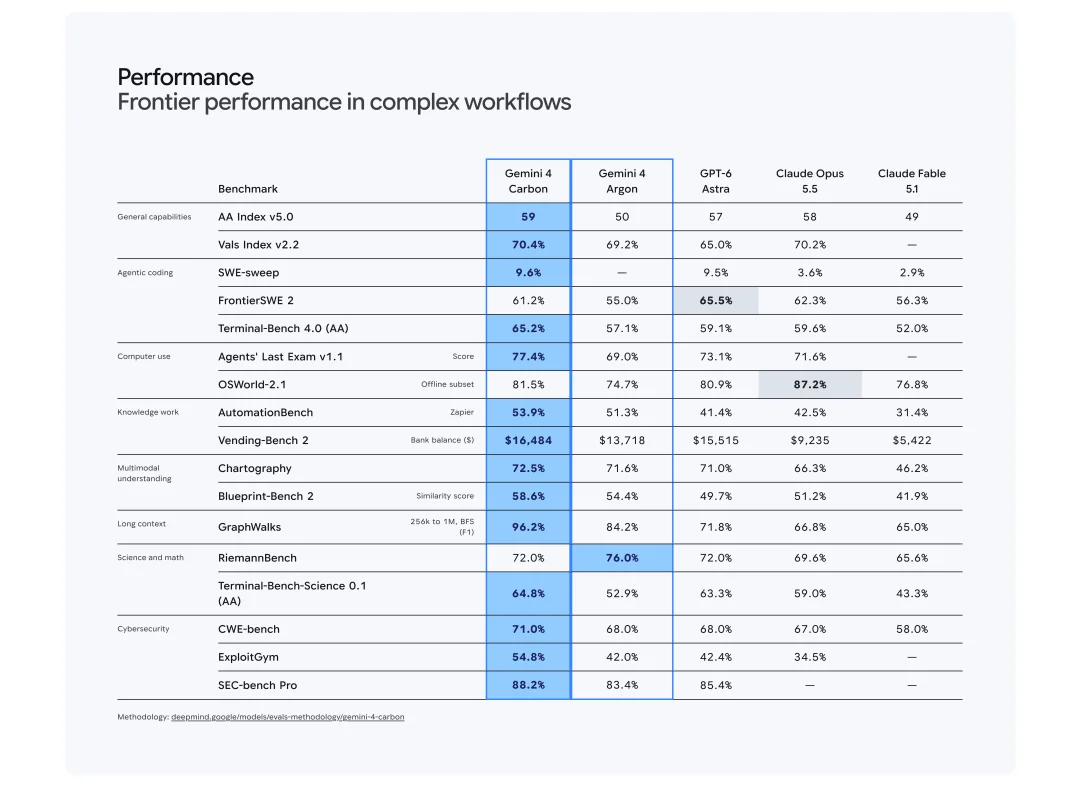
写代码的人最该看三行。
终端里的 Agent 编程:Terminal-Bench 4.0 跑到 65.2%,压过 Opus 5.5 5.6 个百分点,比自家 Argon 高出约 8 个百分点。和 Argon 拉开最大差距的就是这一项。
长上下文:GraphWalks(256k 到 1M)96.2%。Argon 84.2%,Opus 5.5 只有 66.8%。在大仓库里来回翻、跨文件找关联,几乎不掉链子。
网络安全:找漏洞、验证漏洞、修漏洞,三项全是第一。这是谷歌这次最想秀的肌肉,不过这几项是在不加防护的条件下测的,完整的网络安全能力要通过 Fairwind 计划申请。
但它不是全能的。修真实仓库的 FrontierSWE 2 上,GPT-6 Astra(65.5%)和 Opus 5.5(62.3%)都比它的 61.2% 高;OSWorld 电脑操作上,Opus 5.5 领先近 6 个百分点;RiemannBench 上,Carbon 甚至输给了自家的 Argon。
而这个第一,只坐了两周。11 月 10 日 Claude Fable 5.2 发布,Artificial Analysis 智能指数榜上 Fable 5.2 拿了 65,Carbon 是 60。
比跑分更接近日常用法的,是 Arena 的 Agent 榜:它看的是真实用户的 Agent 会话里,问题最后到底解决没有。
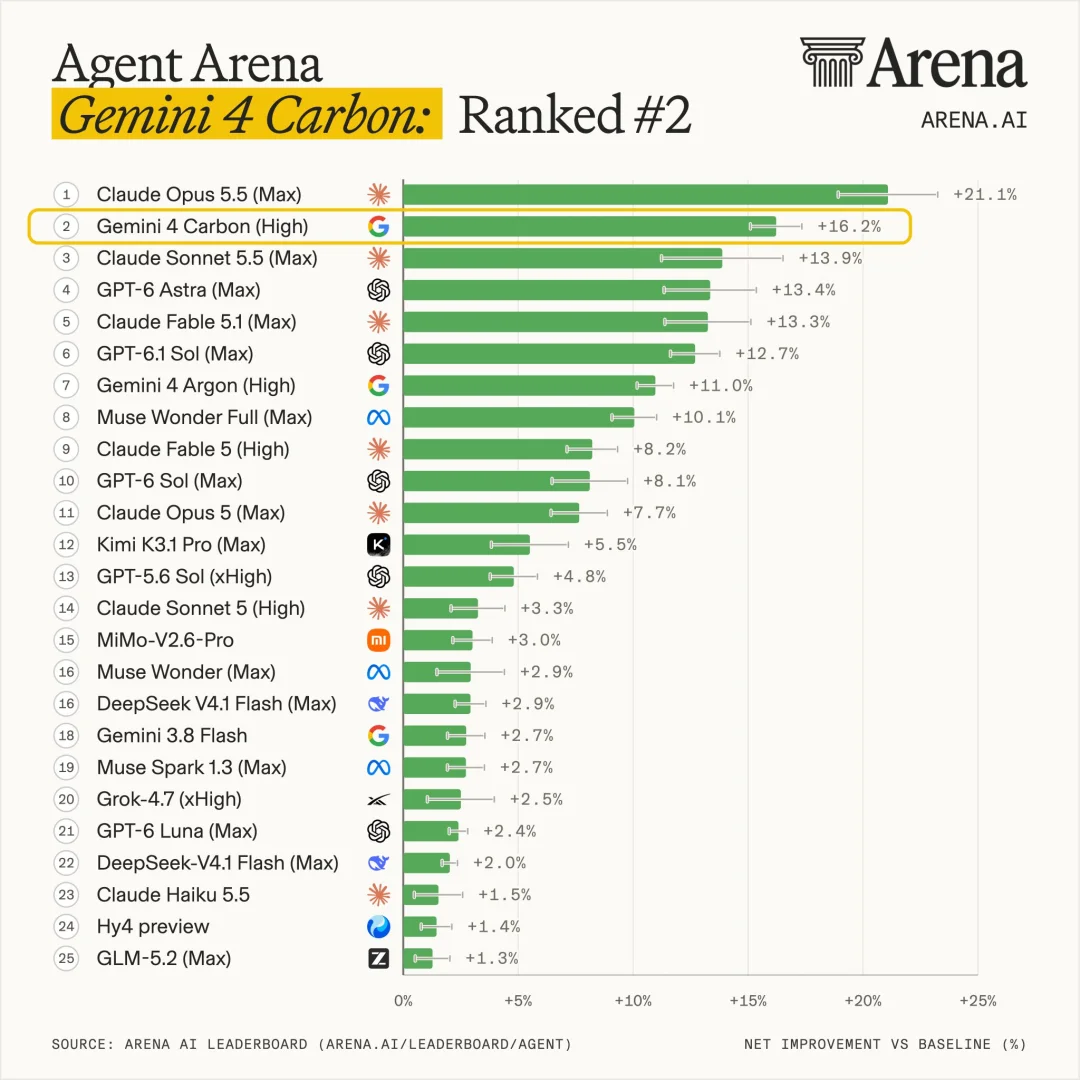
Carbon 排第二,只在 Opus 5.5 Max 之后;Argon 排第七。Arena 还单独点了一项:用户中途改需求、提出反对时,模型能不能听进去、及时掉头。这一项 Carbon 全场第一。
Arena 的评测负责人 Peter Gostev 发布前就上手用过,他的原话是:Carbon 用起来比 Argon 好得多,这次谷歌是来真的。
代价也很一致:慢。评测博主 Lumina 在 Arena 上拿 Carbon 做 3D 场景,结论是比 Argon 明显强,但慢得离谱,看任务要慢 2 到 4 倍。
Carbon 和 Argon 单价一样,差别全在 token 数上。
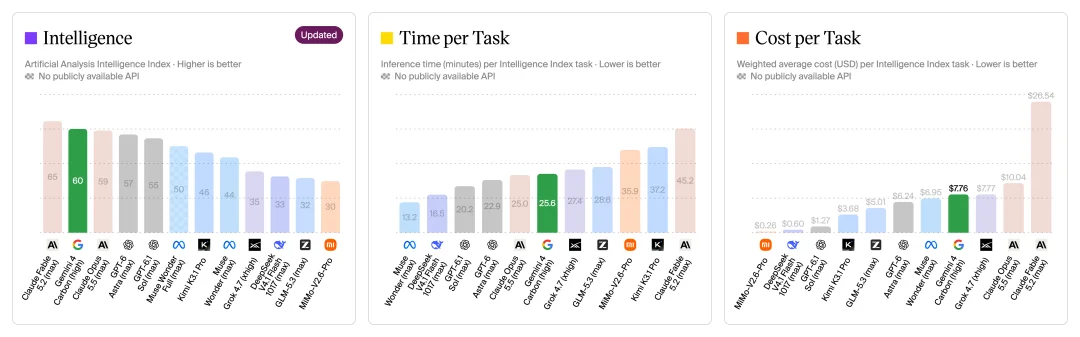
Artificial Analysis 跑完整套智能指数,Carbon 输出了 2.05 亿个 token,同档模型的中位数是 7280 万,差不多 2.8 倍。每个任务平均要 25.6 分钟,中位数只要 12.6 分钟。
谷歌的价格页也没藏着:同样的任务,Argon 每轮用的 token 更少、回得更快。token 多了,钱就多了,等的时间也长了。Arena 说 Carbon 的单任务成本比 Opus 5.5 Max 低 72%,这话没错,但比的是最贵的那一档,不是 Argon。
$2 / $10 只是引入期价格。谷歌的价格页写明:12 月 1 日起,Carbon 和 Argon 都涨到每百万 token 输入 $4、输出 $20,缓存读取从 $0.10 涨到 $0.20。
Artificial Analysis 那 $7.76 一个任务,已经是按新价算的。
CodingPass 上的 Carbon 有 low、medium、high 三档推理强度,思考关不掉:
reasoning_effort(Chat Completions)、reasoning.effort(Responses)或 output_config.effort(Messages),就按你选的档位跑。none,或 thinking 设为 disabled),会按最低的 low 跑。建议先从 medium 开始。Carbon 的长处是啃难题时不松口,但大部分请求用不上 high 那一大段长思考,卡住了再往上调。
curl https://codingpass.ai/v1/chat/completions \ -H "Authorization: Bearer $CODINGPASS_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "gemini-4-carbon", "reasoning_effort": "medium", "messages": [{"role": "user", "content": "Find the root cause of the flaky test in tests/sync.test.ts"}] }'OpenCode、Cline 等 OpenAI 兼容的工具,把 gemini-4-carbon 加进模型列表就能用。
日常还是 Argon。 谷歌自己这么说,token 账也这么算。Argon 快,同样的额度能干更多活。
卡住了再上 Carbon。 跨多个模块的改动、追了半天找不到原因的 bug、要让 Agent 一口气跑很久的任务,值得多等一会儿、多花一点额度。
重活儿赶在 11 月跑。 CodingPass 按官方 API 价计量,12 月 1 日单价翻倍后,同一份额度能跑的 token 也跟着减半。
Go、Plus、Pro 都含 Carbon,按官方 API 价计量。不会意外扣费,随时取消。