Alle Modelle
Die ID jedes Modells, der Mindesttarif und das Monatskontingent in Go, Plus und Pro.
Googles viertes Gemini-4-Modell in sieben Wochen schließt die Lücke zwischen Carbon und Hydrogen. Offizielle Benchmarks, Kosten und Laufzeiten pro Thinking-Stufe von Artificial Analysis, der Preisvergleich mit Carbon, geschätzte Monatsrechnungen und die noch ausstehenden Teile der Model Card.
Am 18. November hat Google mit Gemini 4 Neon sein viertes Gemini-4-Modell innerhalb von sieben Wochen veröffentlicht. Neon basiert auf Carbon und füllt die Lücke zwischen dem leistungsstärksten Modell Carbon und dem schnellen Hydrogen.
Zum Start erreicht Neon im Artificial Analysis Intelligence Index 61 Punkte und belegt damit Platz drei – einen Punkt vor Carbon. Im Vals Index landet es mit 70,9 % auf Rang zwei. Die API-Preise liegen bei $3 pro Million Input-Token, $15 pro Million Output-Token und $0.15 für Cache-Reads bei einem Kontextfenster von 1 Million Token.
Kurz gesagt: Auf der Standardstufe high erreicht Neon denselben AA-Index-Wert wie Carbon, kostet pro Aufgabe aber weniger als die Hälfte und läuft mehr als doppelt so schnell – damit eignet es sich für Multi-File-Debugging, Refactorings und lange Agent-Läufe. Die Stufe xhigh bringt nur einen Punkt mehr, verteuert die Aufgabe jedoch um rund 70 %. Bis zum 30. November gilt für Carbon noch der Einführungspreis von $2 / $10, sodass Neon pro Token in diesem Zeitraum teurer ist. Auf CodingPass steht Neon in Go, Plus und Pro bereit.
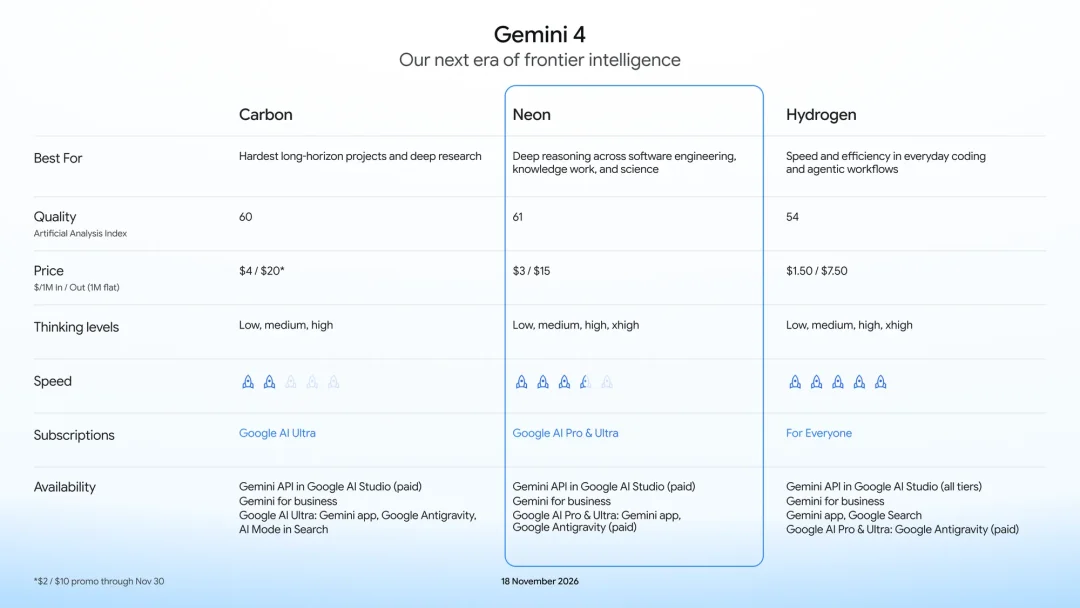
Die Aufgabenverteilung innerhalb der Serie ist klar getrennt: Carbon übernimmt die schwersten Langläufer, Hydrogen erledigt schnelle Alltagsaufgaben, und Neon bedient komplexe Code- und Agent-Workflows, bei denen Carbon zu langsam und zu teuer wäre.
| Carbon | Neon | Hydrogen | |
|---|---|---|---|
| Einsatzzweck | Schwierigste Langzeitprojekte und tiefe Forschung | Komplexe Programmierung, Wissensarbeit und wissenschaftliches Reasoning | Alltägliche Programmierung und schnelle, günstige Agent-Workflows |
| AA Intelligence Index | 60 | 61 | 54 |
| API-Preis (Input / Output pro 1 Mio. Token) | $4 / $20 (bis 30. Nov. $2 / $10) | $3 / $15 | $1.50 / $7.50 |
| Thinking-Stufen | low, medium, high | low, medium, high, xhigh | low, medium, high, xhigh |
| Gemini-App-Abo | Google AI Ultra | Google AI Pro und Ultra | Alle Nutzer |
Technisch verarbeitet Neon Text, Bilder, Videos, Audio und PDFs und gibt ausschließlich Text aus. Das Kontextfenster umfasst 1.048.576 Token; die synchrone Ausgabe ist standardmäßig auf 65.536 Token begrenzt und lässt sich per Long Decode auf 1 Million erweitern. Unterstützt werden Computer Use, Code-Ausführung, Dateisuche, Function Calling, strukturierte Ausgaben sowie Grounding über Google Search und Maps. Bild- und Audiogenerierung sowie die Live API fehlen. Der Wissensstand reicht bis März 2026.
Argon taucht in der Grafik nicht mehr auf. In der Modellauswahl der Gemini-App stehen jetzt Auto, Hydrogen, Neon und Carbon; Gemini 3.1 Pro und Argon wurden entfernt – viele Pro-Abonnenten bemerkten das erst beim Öffnen der App. Auf der API-Preisseite bleibt Argon zum selben Tarif wie Carbon gelistet.
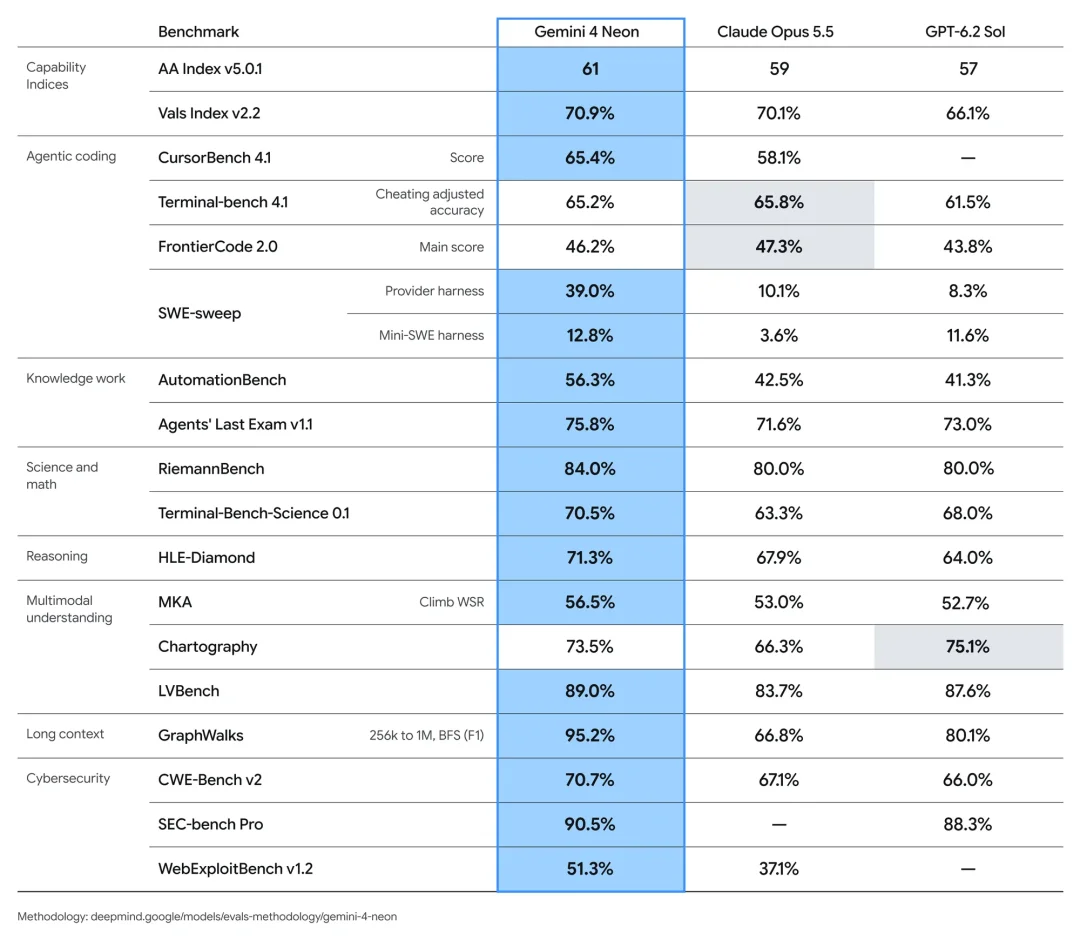
Als Vergleichsgegner nennt die Tabelle lediglich Claude Opus 5.5 und GPT-6.2 Sol. Die im AA Intelligence Index vor Neon platzierten Modelle GPT-6.2 Astra (62) und Claude Fable 5.2 (65) fehlen. Google begründet das damit, dass Neon vergleichbare Modelle anführt und nur hinter größeren, langsameren Modellen zurückbleibt. Laut Artificial Analysis erledigt GPT-6.2 Astra (Max) eine Aufgabe allerdings in 11,5 Minuten für $4.00 und ist damit günstiger und schneller als Neon auf xhigh ($6.44, 22,6 Minuten).
Zwei der drei Niederlagen entfallen auf Coding-Benchmarks:
Am deutlichsten fällt der Vorsprung bei langem Kontext und Automatisierung aus: Auf GraphWalks (256k bis 1M) erzielt Neon 95,2 % gegenüber 66,8 % bei Opus 5.5 und 80,1 % bei Sol. In Zapiers AutomationBench liegt Neon bei 56,3 %, die beiden Konkurrenten bewegen sich um 42 %.
Weitere Ergebnisse aus unabhängigen Ranglisten:
Eigene Messungen von Artificial Analysis zur Wissensarbeit:
Neon ist gezielt auf lange Agent-Läufe abgestimmt: Es bricht bei dichter Tool-Nutzung seltener ab, liest Dateien seltener doppelt, meldet Zwischenstände und komprimiert den Kontext in langen Sessions zuverlässiger. Bei Änderungen über mehrere Dateien hinweg arbeitet es laut Google mit gezielten, minimalinvasiven Eingriffen („targeted, surgical edits“) statt ungefragter Umbauten. In internen Google-Antigravity-Tests erzielte es die bisher niedrigste Halluzinationsrate („lowest fabrication rate“) aller Gemini-4-Modelle.
Die Ergebnisse in den Coding-Benchmarks:
Die 39,0 % auf SWE-sweep stammen allerdings aus Google Antigravity. Im einheitlichen mini-SWE-Harness fällt Neon auf 12,8 % zurück, knapp vor Sol mit 11,6 %. Google räumt selbst ein, dass der hohe Wert zeigt, was das Antigravity-Harness herausholt – außerhalb von Antigravity spiegeln die 12,8 % die Basisstärke besser wider.
In der von Vals selbst durchgeführten Terminal-Bench 4.0 erreicht Neon 61,62 % (Platz 7 von 69 Modellen).
In Antigravity ist zudem ein Zusammenspiel aus großem und kleinem Modell vorgesehen: Neon plant und steuert als Orchestrator, während Hydrogen als Sub-Agent Routineänderungen, Dependency-Updates und Tests abarbeitet und bei Blockaden wieder an Neon übergibt.
Wer von Argon wechselt, sollte in den ersten Tagen den Output-Verbrauch beobachten: In eigenen Generierungstests verbrauchten Carbon, Hydrogen und Neon jeweils das Drei- bis Vierfache der Output-Token von Argon. Das deckt sich mit den Messungen von Artificial Analysis, wonach Neon pro Aufgabe noch mehr Output-Token erzeugt als Carbon.
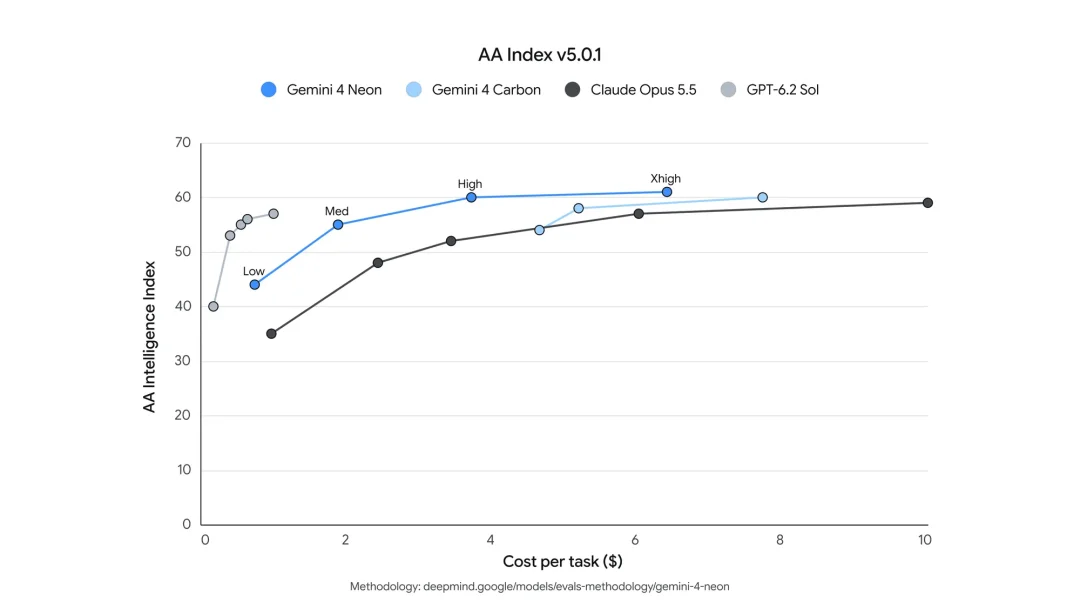
Neon bietet die vier Stufen low, medium, high und xhigh, wobei high der Standard ist. Da Argon standardmäßig auf medium läuft, empfiehlt sich beim Umstieg auf Neon ein explizites medium, wenn Laufzeit und Verbrauch stabil bleiben sollen.
Artificial Analysis hat alle vier Stufen durchgemessen:
| Modell (Stufe) | AA Intelligence Index | Kosten / Aufgabe | Zeit / Aufgabe |
|---|---|---|---|
| Gemini 4 Neon (low) | 44 | $0.75 | 3,7 Min. |
| Gemini 4 Neon (medium) | 55 | $1.90 | 8,3 Min. |
| Gemini 4 Neon (high, Standard) | 60 | $3.74 | 14,8 Min. |
| Gemini 4 Neon (xhigh) | 61 | $6.44 | 22,6 Min. |
| Gemini 4 Carbon (high) | 60 | $7.76 | 34,2 Min. |
| Gemini 4 Hydrogen (xhigh) | 54 | $3.16 | 14,9 Min. |
| GPT-6.2 Sol (Max) | 57 | $1.01 | 7,9 Min. |
| GPT-6.2 Astra (Max) | 62 | $4.00 | 11,5 Min. |
| Claude Opus 5.5 (Max) | 59 | $10.04 | 24,5 Min. |
| Claude Fable 5.2 (Max) | 65 | $26.54 | 41,1 Min. |
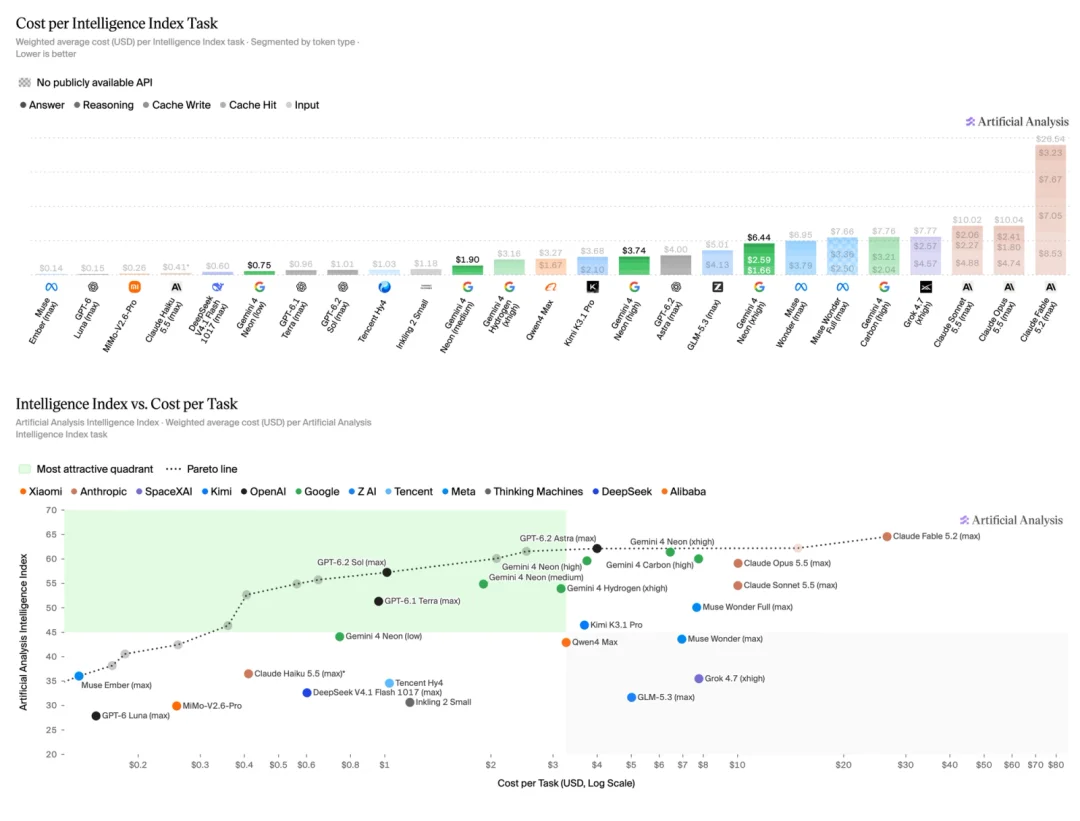
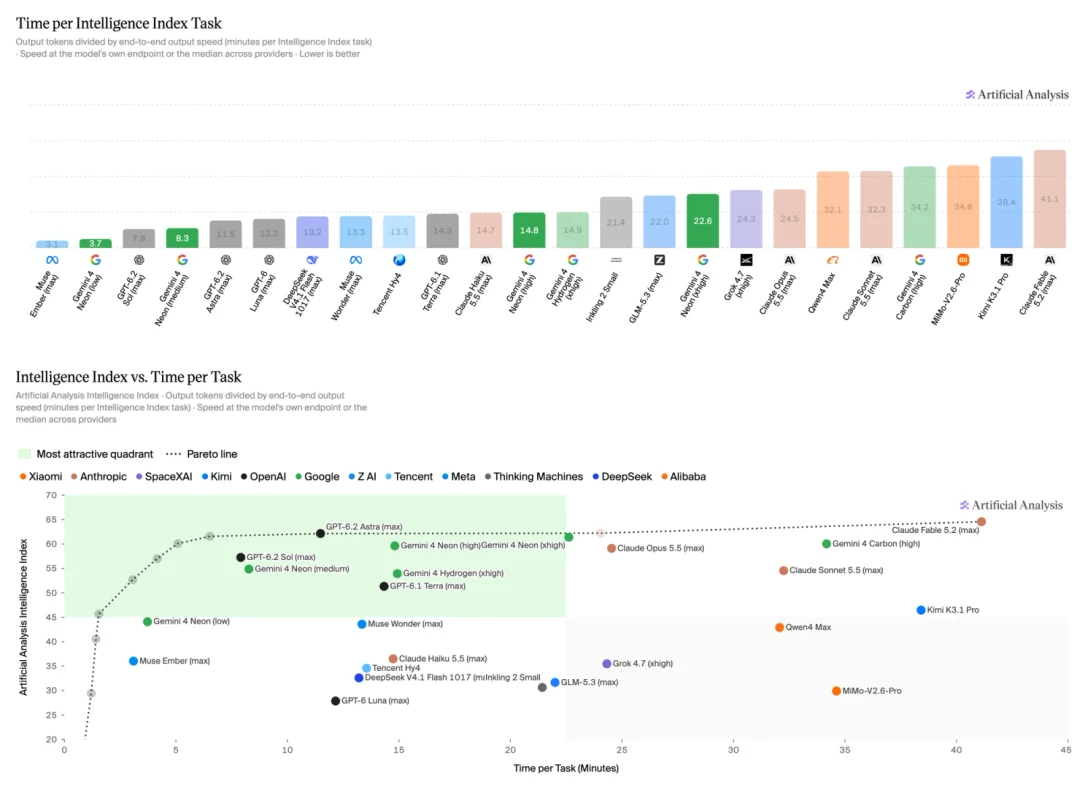
Die Stufe high trifft das beste Verhältnis: Sie zieht beim Intelligence Index mit Carbon (high) gleich und halbiert Kosten sowie Laufzeit. Auf xhigh steigen die Kosten um über 70 % für einen einzigen Zusatzpunkt, und auf GDP.pdf fällt das Ergebnis sogar von 33,4 % auf 28,0 % ab.
Die Ersparnis kommt vom Token-Preis. Laut AA gibt Neon rund 15 % mehr Output-Token pro Aufgabe aus als Carbon. Günstiger wird es nur durch die um 25 % niedrigeren Token-Preise, schneller durch den höheren Durchsatz von etwa 110 Token pro Sekunde gegenüber rund 57 bei Carbon.
Carbons $7.76 gelten ab dem 1. Dezember. Bis Ende November greift noch der halbe Einführungspreis, was rechnerisch rund $3.88 pro Aufgabe entspricht – günstiger als Neon auf xhigh und auf dem Niveau von Neon high.
Darunter ist Sol noch günstiger. GPT-6.2 Sol (Max) erreicht 57 Punkte für $1.01 und 7,9 Minuten pro Aufgabe, während Neon auf medium bei 55 Punkten und $1.90 liegt.
Google nennt im eigenen Blog weitere Vergleichswerte: Auf high liege Neon um 32 % unter Carbons Task-Kosten und auf Vals sowie Agent Arena 50 % bis 80 % unter konkurrierenden Top-Modellen; xhigh sei noch immer mindestens 36 % günstiger als die Höchststufen der Konkurrenz.
Je nach Benchmark kann sich die Reihenfolge jedoch umkehren. In Plotlys Datenanalyse-Benchmark über 43 Aufgaben erhielten alle vier Gemini-4-Modelle die Note A, die Gesamtkosten lagen aber bei $6 für Hydrogen, $11 für Carbon, $13 für Argon und $17 für Neon. Grund sind einerseits die noch laufenden Einführungspreise für Carbon und Argon, andererseits liefert das Test-Harness so viel Führung im Prompt, dass das Ergebnis überall stimmt und allein die standardmäßig erzeugten Denk- und Output-Token den Preis treiben – dort ist Neon mit Standardstufe high im Nachteil.
| Modell | Input | Output (inkl. Thinking-Token) | Cache-Reads |
|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 |
| Gemini 4 Carbon / Argon (bis 30. Nov.) | $2.00 | $10.00 | $0.10 |
| Gemini 4 Carbon / Argon (ab 1. Dez.) | $4.00 | $20.00 | $0.20 |
Für Neon gibt es keinen Free Tier; Denk-Token werden zum Output-Preis abgerechnet. Beim Caching steht nur implizites Caching bereit (automatischer Treffer ab einem gemeinsamen Präfix von 4.096 Token zu 5 % des Input-Preises); explizites Caching wird nicht unterstützt.
Im Vergleich zur eigenen Familie kostet Neon pro Token doppelt so viel wie Hydrogen. Gegenüber Carbon und Argon ist es bis zum 30. November 50 % teurer und ab dem 1. Dezember 25 % günstiger.
Die Kosten einer einzelnen Anfrage berechnen sich wie folgt:
Kosten pro Anfrage = neuer Input × Input-Preis + Cache-Treffer × Cache-Preis + Output × Output-PreisBei angenommenen 20.000 Input-Token pro Anfrage (davon die Hälfte aus dem Cache) und 2.000 Output-Token ergibt sich folgende geschätzte Monatsrechnung:
| Modell | Pro Anfrage | 10.000 Anfragen | 100.000 Anfragen | 1 Mio. Anfragen |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $0.031 | $308 | $3,075 | $30,750 |
| Gemini 4 Neon | $0.062 | $615 | $6,150 | $61,500 |
| Gemini 4 Carbon (bis 30. Nov.) | $0.041 | $410 | $4,100 | $41,000 |
| Gemini 4 Carbon (ab 1. Dez.) | $0.082 | $820 | $8,200 | $82,000 |
Diese Schätzung rechnet mit festen 2.000 Output-Token. Auf höheren Thinking-Stufen wächst der Output-Anteil deutlich und bestimmt stärker die Gesamtrechnung.
CodingPass rechnet zu Googles offiziellen API-Preisen ab. Neon ist ab Go verfügbar, Carbon erst ab Plus.
| Modell | Mindesttarif | Go | Plus | Pro |
|---|---|---|---|---|
| Gemini 4 Hydrogen | Go | 305M | 1.0B | 2.5B |
| Gemini 4 Neon | Go | 205M | 508M | 1.3B |
| Gemini 4 Argon | Go | 205M | 761M | 1.9B |
| Gemini 4 Carbon | Plus | — | 761M | 1.9B |
In Go liegt das Monatskontingent für Neon bei $60, das entspricht rund 2,050 Anfragen und einem 5-Stunden-Limit von etwa 342 Anfragen. Nach der Preiserhöhung für Carbon und Argon am 1. Dezember halbiert sich deren Token-Reichweite im selben Kontingent.
curl https://codingpass.ai/v1/chat/completions \ -H "Authorization: Bearer $CODINGPASS_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "gemini-4-neon", "reasoning_effort": "medium", "messages": [{"role": "user", "content": "Refactor src/billing/ to remove the duplicated proration logic"}] }'In Claude Code startest du das Modell mit claude --model gemini-4-neon; in OpenCode, Cline und anderen OpenAI-kompatiblen Tools trägst du gemini-4-neon in die Modellliste ein.
Mit Gemini 4 Neon for cyber stellt Google eine spezialisierte Variante für sichere Code-Generierung, Schwachstellensuche, Exploit-Prüfung und Patching vor. Das Modell ist nicht über die reguläre API verfügbar, sondern öffnet in den kommenden Tagen über das Fairwind Program für zugelassene Verteidiger.
Bei sicherem Code, Penetrationstests und Schwachstellensuche beansprucht Google jeweils Platz eins: Auf AutoBaxBench schlägt Neon das größere Carbon in den Stufen leicht, mittel und schwer; auf WebExploitBench v1.2 und SEC-bench Pro liegen die Kosten rund halb so hoch wie bei vergleichbaren großen Modellen.
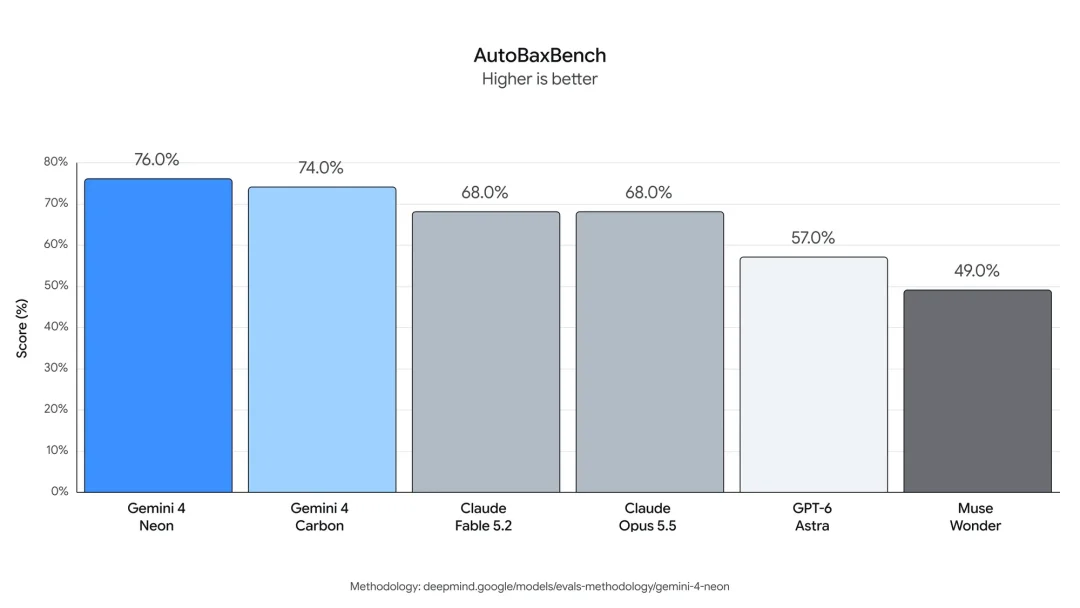
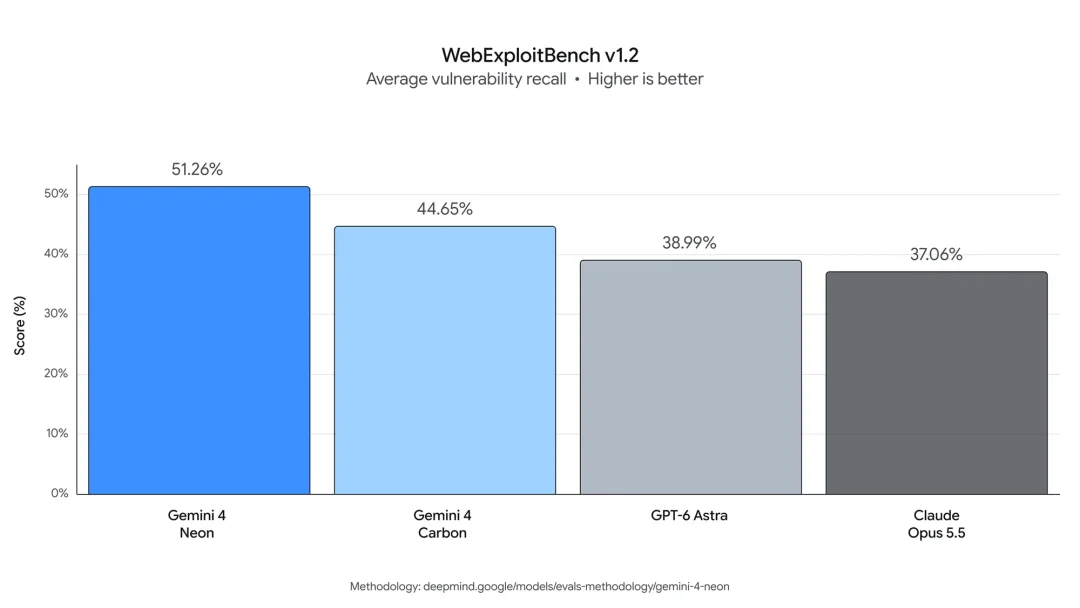
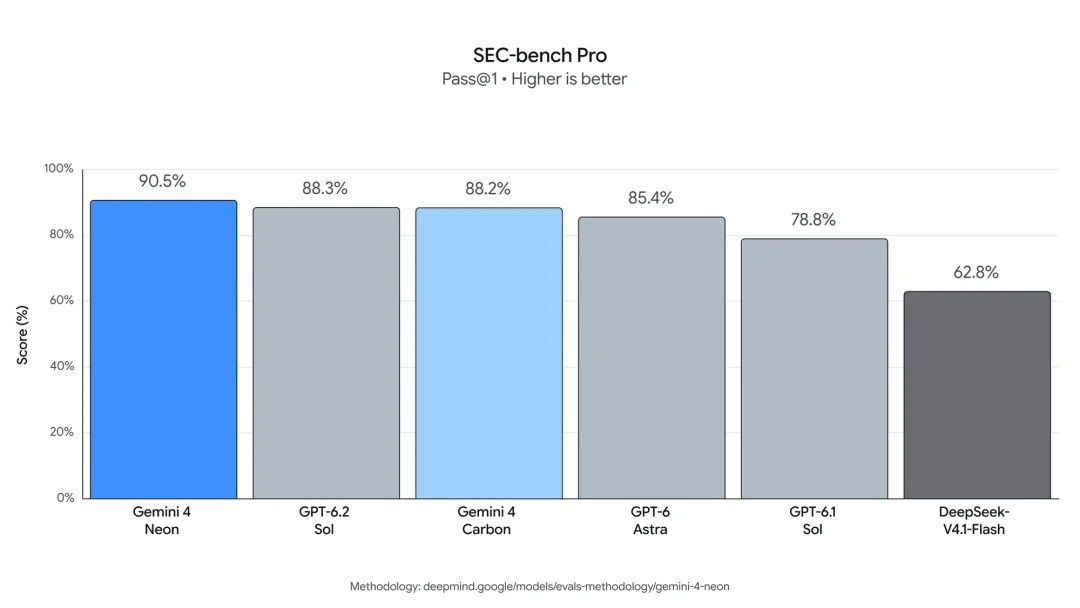
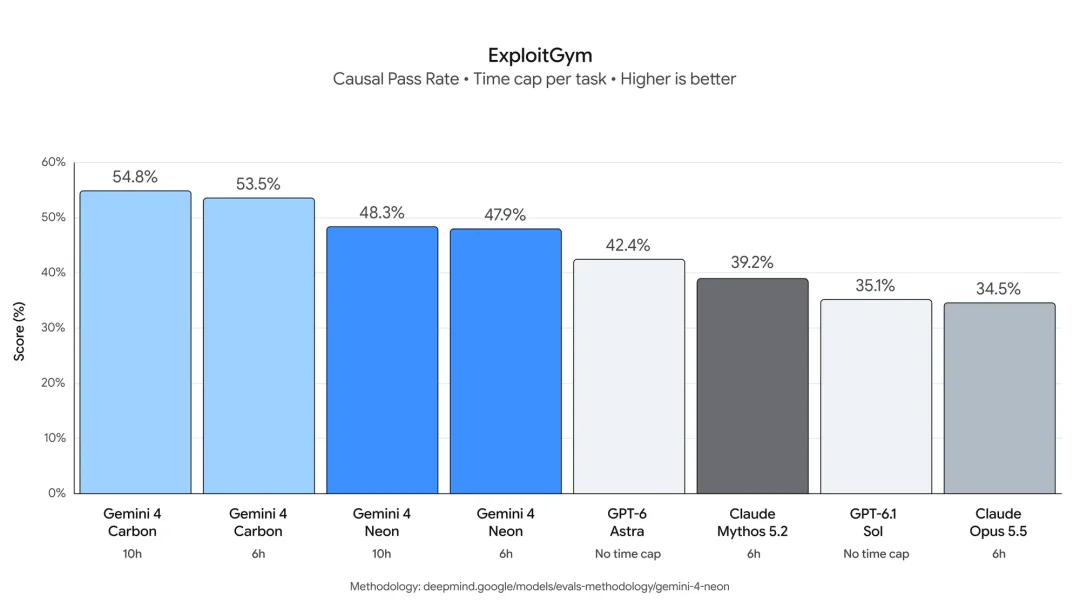
In zwei Disziplinen reicht es nicht für Platz eins. Bei ExploitGym, das die Ausnutzbarkeit von Schwachstellen prüft, landet Neon hinter Carbon, verbraucht laut Google aber nur halb so viele Token.
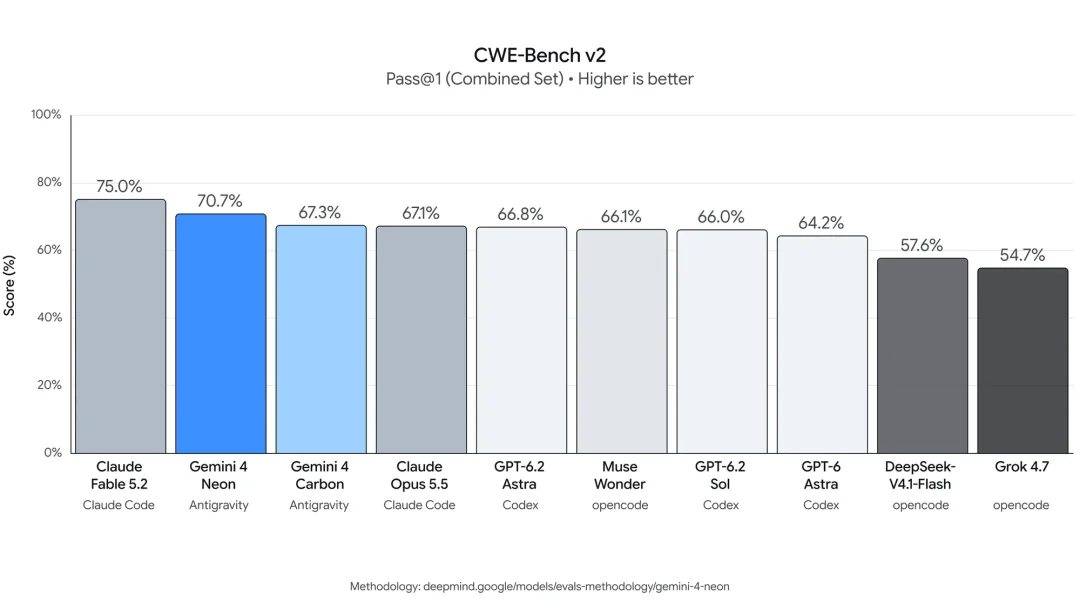
Beim Patchen von Sicherheitslücken auf CWE-Bench v2 liegt Neon 3,4 Prozentpunkte vor Carbon, hinter dem Spitzenreiter Claude Fable 5.2. In der offiziellen Model-Card-Tabelle führt Google in dieser Zeile nur Opus 5.5 und Sol als Vergleich.
Bei den Schutzmechanismen übernimmt Neon das Niveau von Carbon, lehnt legitime Anfragen aber deutlich seltener fälschlich ab: Auf Terminal-Bench 4.0 liegt die Ablehnungsrate bei 1,98 %, auf Terminal-Bench-Science bei 0 %.
Weitere Kennzahlen zum Agent-Verhalten:
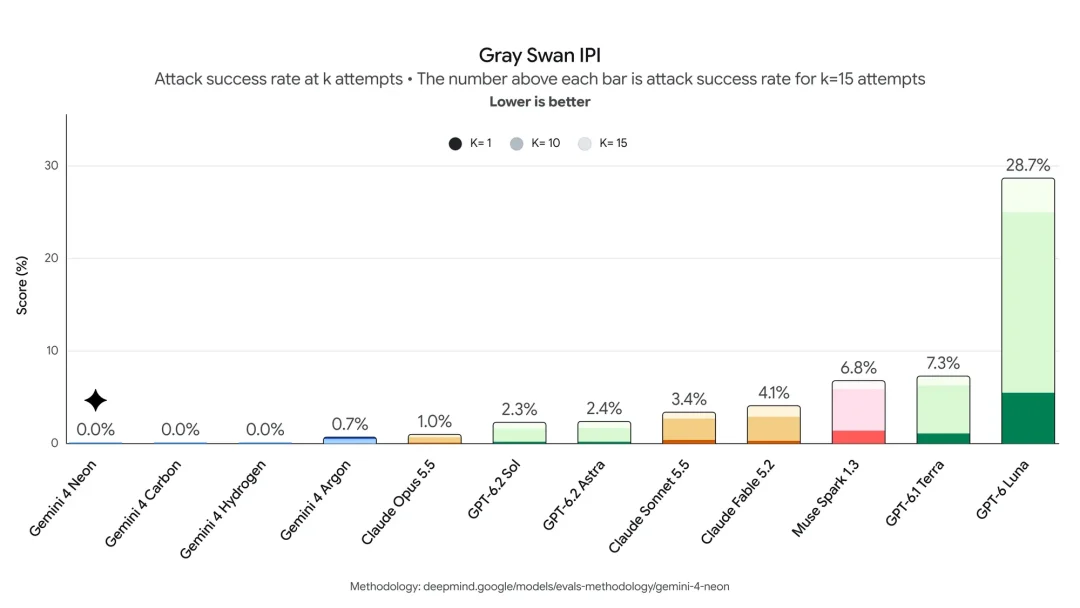
Beim Gray-Swan-Test für indirekte Prompt Injections werden bösartige Anweisungen in Webseiten, E-Mails, Dokumenten und Code versteckt. Auf der höchsten Thinking-Stufe und mit aktiven Echtzeit-Schutzfiltern erreicht Neon eine Angriffserfolgsrate von 0,0 %.
Die meisten Zahlen dieses Abschnitts stammen aus Googles internen Tests. Laut Model Card erscheint der vollständige Safety & Security Report erst in den kommenden Tagen. Eine neue Bewertung kritischer Fähigkeiten nach dem Frontier Safety Framework wurde nicht durchgeführt; stattdessen übernimmt Google die Einstufungen von Argon, weil Neons Leistungszuwachs unterhalb der Schwelle für eine Neubewertung (Material Capability Change) geblieben sei. Unter „Known Limitations“ steht lediglich der Standardsatz, dass das Modell halluzinieren könne – genauere Grenzen werden sich erst mit dem vollständigen Sicherheitsbericht zeigen.
In der Gemini-App ist Neon für Google-AI-Pro- und -Ultra-Abonnenten über den Punkt „Deeper analysis“ in der Modellauswahl erreichbar. Google hebt drei Einsatzbereiche hervor:
Weitere Kanäle:
Ob vergünstigte oder Studenten-Abos von Google AI Pro Neon in Antigravity direkt zum Start auswählen können, war am Veröffentlichungstag uneinheitlich: Einige Nutzer erhielten bereits Zugriff, andere sahen den Hinweis auf zahlende Pro- und Ultra-Abos.
| Workload | Empfehlung | Begründung und Kompromiss |
|---|---|---|
| Alltägliche Code-Änderungen, Tests, Doku | Hydrogen oder Neon auf medium | Neon medium liegt bei 55 Punkten und $1.90 pro Aufgabe; Hydrogen kostet pro Token die Hälfte |
| Multi-File-Debugging, Repo-Refactorings, lange Agent-Läufe | Neon auf high | Gleicher Index-Wert wie Carbon high bei weniger als halben Task-Kosten und 14,8 statt 34,2 Minuten Laufzeit |
| Hartnäckig blockierte Aufgaben | Neon auf xhigh oder Carbon | xhigh bringt 1 Punkt mehr bei 70 % höheren Kosten; bis 30. November ist Carbon günstiger |
| Finanzen, Recht, Tabellen und Diagramme | Neon auf high | Platz 1 im Vals Finance und Legal Index; bei AA GDP.pdf schlägt high xhigh |
| Hohes Volumen einfacher, preissensibler Aufrufe | Hydrogen oder GPT-6.2 Sol | Sol (Max) erreicht im AA-Test 57 Punkte bei $1.01 pro Aufgabe |
| Schwachstellensuche und Penetrationstests | Fairwind Program beantragen | Neon for cyber ist nur Programmmitgliedern vorbehalten, nicht in der regulären API |
Für den Einstieg bietet sich ein klares Muster an: Bestehende Argon- oder Carbon-Workloads auf Neon mit Stufe high umstellen, bei knappem Kontingent auf medium zurückgehen und xhigh für Fälle reservieren, die auf high steckenbleiben.
ANTHROPIC_BASE_URL auf CodingPass startest du es mit claude --model gemini-4-neon. Konfigurationsbeispiele für weitere Tools findest du auf der Modellseite.gemini-4-argon auf CodingPass verfügbar. Entfernt wurde es lediglich aus der Modellauswahl der Gemini-App.Go, Plus und Pro enthalten Neon, abgerechnet zu offiziellen API-Preisen. Keine Überraschungskosten, jederzeit kündbar.