Todos los modelos
ID de cada modelo, plan mínimo y cuota mensual en Go, Plus y Pro.
Todos siguen compitiendo por producir más tokens y razonar más fuerte. Google lanzó un modelo que no escribe ninguna respuesta: dale una entrada y unas pocas opciones, y calcula una vez, te dice cuál elegir y cuánta confianza tiene. 92.2% de precisión en JevBench, $0.10 por millón de tokens de entrada y cero cobro por salida.
La industria sigue compitiendo por producir más tokens y razonar más fuerte. El último lanzamiento de Google va en dirección contraria: el modelo ni siquiera escribe su respuesta.
El 11 de noviembre, Google lanzó Gemini Decision 1 y la Gemini Decisions API que impulsa. Este modelo solo toma decisiones. Tú listas las respuestas candidatas, ejecuta una sola pasada hacia adelante, puntúa cada candidata y se detiene.
En resumen: Decision 1 no escribe texto. Dale unas pocas opciones y te dice cuál elegir. Clasificación, enrutamiento, selección de herramientas y comprobaciones de políticas —las tareas que solo necesitan un resultado— corren más rápido y más barato aquí, y cada respuesta trae una puntuación de confianza. Aun así, no sirve para todo: en When2Call, que prueba si y cuándo llamar a una herramienta, no queda primero.
El CEO de Google, Sundar Pichai, lo presentó en una publicación en X.
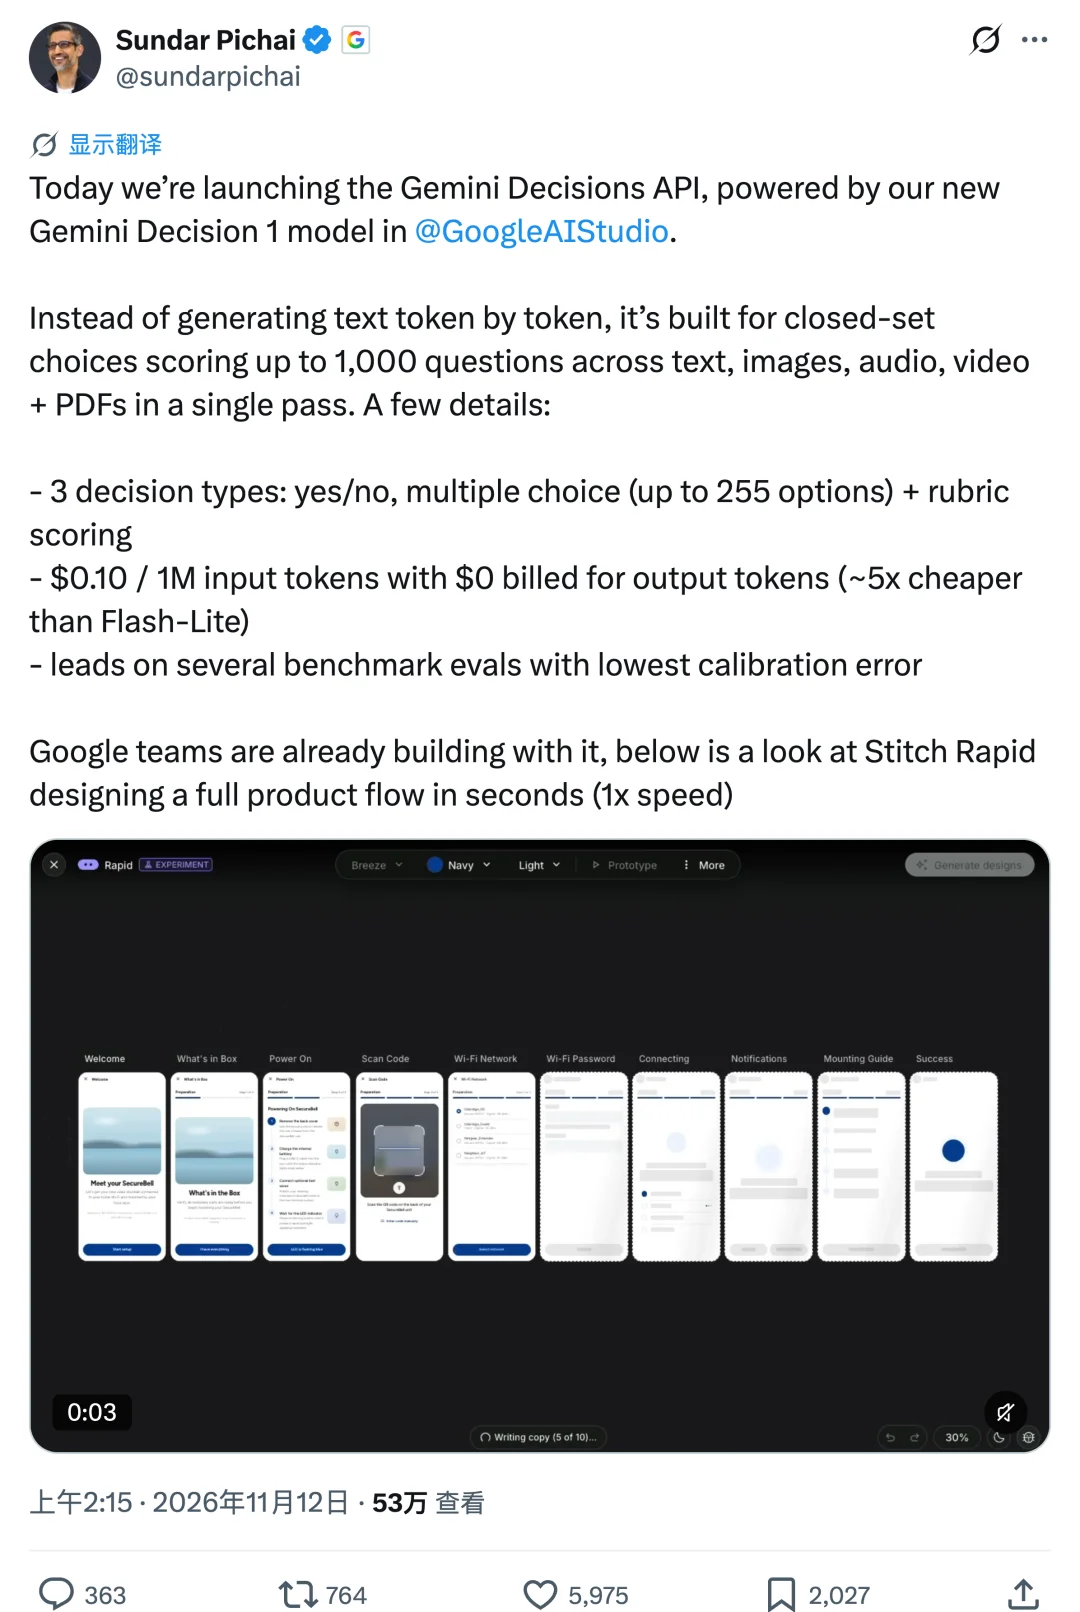
En la publicación destacó tres detalles:
También dijo que los equipos internos de Google ya lo están usando y compartió una demo a velocidad 1× de Stitch Rapid: un flujo completo de producto diseñado en segundos. Para verlo en la práctica, mira este vídeo:
Para que una IA decida si un correo es spam o a qué agente debe ir una tarea, normalmente llamas a un modelo generativo, esperas a que redacte texto y luego extraes el resultado de ese texto. Decision 1 se salta por completo la decodificación token a token. Le pasas la entrada, las preguntas y las opciones candidatas, lo que Google llama opciones de conjunto cerrado. Puntúa todas las candidatas en una sola pasada hacia adelante y devuelve la opción elegida junto con una probabilidad y una puntuación de confianza para cada una.
Las tareas que solo necesitan una clasificación, una puntuación o una selección ya no tienen que pasar por una generación completa de texto.
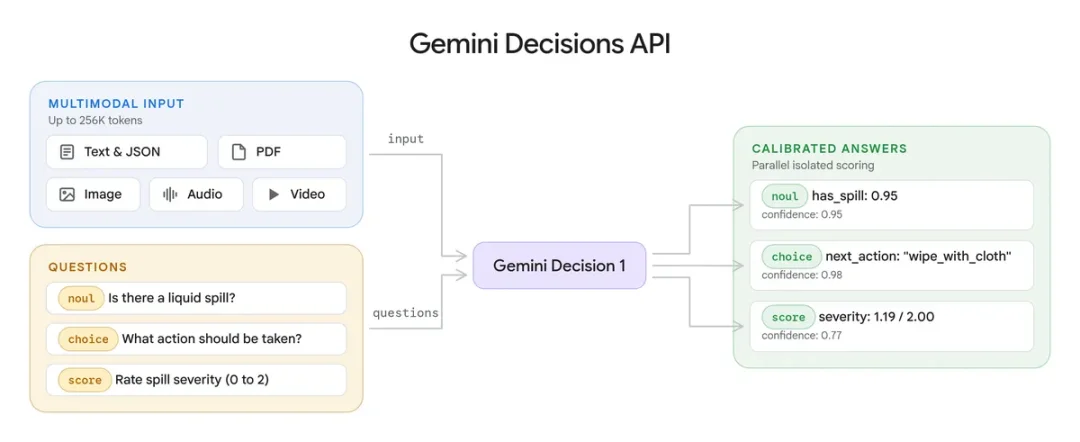
Según las cifras de Google, una sola solicitud puede hacer hasta 1,000 preguntas independientes. La entrada puede ser texto, imágenes, audio, vídeo o PDF, con una latencia de extremo a extremo de 150 a 250 ms.
El precio también es agresivo: $0.10 por millón de tokens de entrada, sin cobro por salida. En la batería compartida de benchmarks de Google, resulta casi 5 veces más barato que Gemini 3.5 Flash-Lite llamado a través de la Interactions API.
Google no planea limitarlo a preguntas de opción múltiple. Enrutamiento de modelos, selección de herramientas para agentes, diseño de producto y detección de seguridad ya están en uso dentro de Google, que lo posiciona como la capa de un sistema de IA que toma la decisión.
Decision 1 ofrece tres tipos de pregunta:
| Tipo | Nombre en la API | Qué hace | Devuelve |
|---|---|---|---|
| Sí / no | noul | Si una foto muestra un riesgo de seguridad, o si un texto incumple una política | Probabilidad de que la condición se cumpla |
| Opción múltiple | choice | Elige la mejor opción entre 2 y 255 candidatas | La opción ganadora y una probabilidad normalizada para cada opción |
| Rúbrica ordenada | score | Evalúa según tu escala, empezando en 0 | Una puntuación ponderada continua y una probabilidad por cada nivel |
Los tres tipos pueden mezclarse en una misma solicitud.
El ejemplo de Google es la foto de una encimera de oficina con una nota de texto corta, haciendo tres preguntas a la vez: si hay un derrame de líquido sin limpiar, qué acción de limpieza corresponde y qué gravedad tiene el desorden.
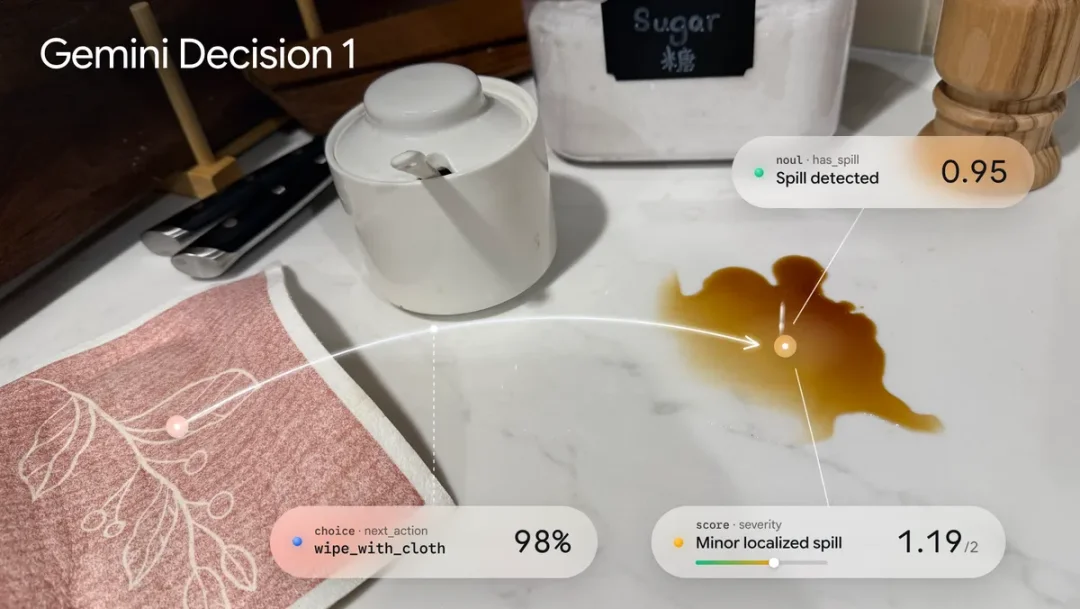
Antes esto exigía varios clasificadores o varios prompts lanzados por separado contra un modelo generativo. Ahora lleva una sola solicitud.
El contexto de entrada llega hasta 256K tokens y las modalidades pueden combinarse. En una empresa, eso significa evaluar la grabación de una llamada junto con metadatos de la cuenta, o revisar un expediente de siniestro de seguro junto con fotos de los daños.
Cada respuesta lleva una puntuación de confianza de 0 a 1. Los casos dudosos pueden enviarse a otro modelo o a revisión humana.
Velocidad y coste son sus otros puntos fuertes. Con un contexto dentro de 16K tokens, la latencia mediana de cómputo del modelo es de 50 a 100 ms, o 150 a 250 ms de extremo a extremo. Pasar de 1 pregunta a 100 en una solicitud casi no añade latencia. La entrada compartida se factura una vez por solicitud; cada pregunta adicional solo suma los tokens de sus propias instrucciones y opciones.
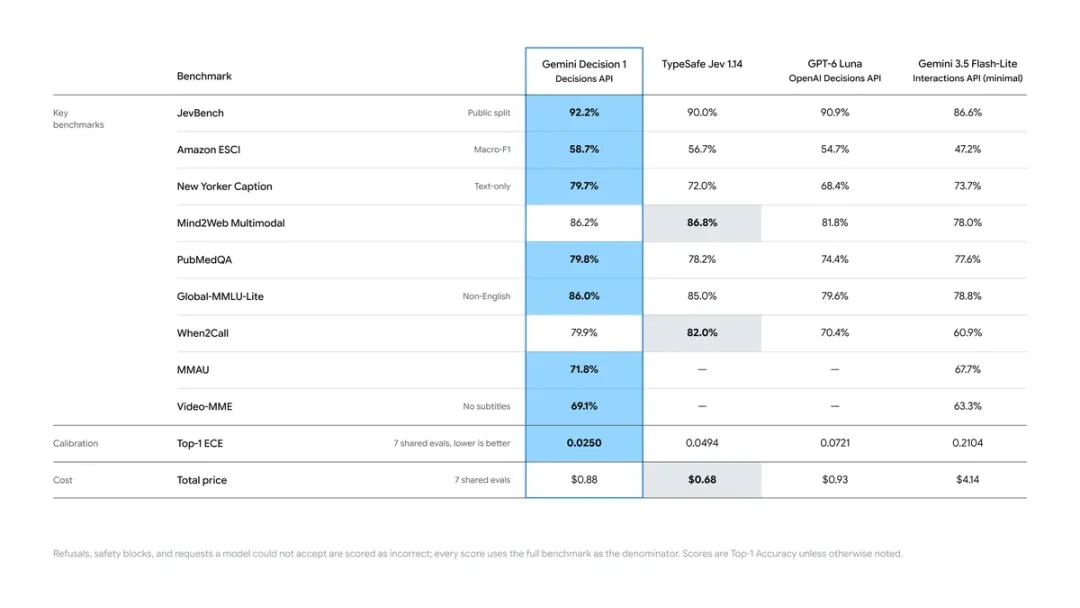
Google también publicó una tabla de resultados que merece mirarse de cerca.
Normalmente un modelo nuevo se compara contra un grupo de LLMs de propósito general. Esta vez Google eligió tres rivales de la misma categoría: GPT-6 Luna en la Decisions API de OpenAI, TypeSafe Jev 1.14, diseñado para decisiones de clasificación, y su propio Gemini 3.5 Flash-Lite.
| Benchmark | Decision 1 | TypeSafe Jev 1.14 | GPT-6 Luna | Flash-Lite |
|---|---|---|---|---|
| JevBench | 92.2% | 90.0% | 90.9% | 86.6% |
| Amazon ESCI (Macro-F1) | 58.7% | 56.7% | 54.7% | 47.2% |
| New Yorker Caption | 79.7% | 72.0% | 68.4% | 73.7% |
| Mind2Web Multimodal | 86.2% | 86.8% | 81.8% | 78.0% |
| PubMedQA | 79.8% | 78.2% | 74.4% | 77.6% |
| Global-MMLU-Lite (no inglés) | 86.0% | 85.0% | 79.6% | 78.8% |
| When2Call | 79.9% | 82.0% | 70.4% | 60.9% |
| MMAU (audio) | 71.8% | — | — | 67.7% |
| Video-MME (sin subtítulos) | 69.1% | — | — | 63.3% |
| Top-1 ECE (menor es mejor) | 0.0250 | 0.0494 | 0.0721 | 0.2104 |
| Coste total, 7 benchmarks compartidos | $0.88 | $0.68 | $0.93 | $4.14 |
Decision 1 quedó primero en 7 de los 9 benchmarks y también tuvo el menor error de calibración. En dos de los nueve benchmarks, y en coste total, un rival lo hizo mejor.
Empecemos por las victorias. En JevBench puntúa 92.2%, 1.3 puntos por encima de GPT-6 Luna. En Amazon ESCI, un benchmark de relevancia en búsqueda de productos, supera a Luna por 4 puntos y a Flash-Lite por 11.5 puntos.
La mayor brecha aparece en New Yorker Caption, que pide al modelo elegir el pie de foto que encaja con una viñeta: leer contexto y escoger entre candidatas. Decision 1 puntúa 79.7% y Luna 68.4%, una diferencia de 11.3 puntos. En PubMedQA, un benchmark de preguntas médicas, marca 79.8% frente a 74.4% de Luna. En el multilingüe Global-MMLU-Lite puntúa 86.0% frente a 79.6% de Luna.
Solo Decision 1 y Flash-Lite tienen resultados en el benchmark de audio MMAU y el de vídeo Video-MME. Decision 1 puntúa 71.8% y 69.1%, ambos por encima de Flash-Lite.
En Mind2Web Multimodal, TypeSafe Jev lidera con 86.8% y Decision 1 puntúa 86.2%, una diferencia de 0.6 puntos.
En When2Call, la ventaja de Jev es mayor: 82.0% frente a 79.9%. El benchmark evalúa si llamar a una herramienta y cuándo hacerlo, que es justo el escenario agéntico que Google destaca, y Jev, construido para decisiones, sigue saliendo por delante.
El coste total tampoco es el más bajo. En los 7 benchmarks compartidos, Decision 1 costó $0.88 y Jev $0.68. La cifra de “casi 5 veces más barato” se mide frente a los $4.14 de Flash-Lite.
La nota al pie de la tabla cuenta como incorrectos los rechazos, bloqueos de seguridad y solicitudes que el modelo no pudo manejar, y el denominador es todo el conjunto de pruebas.
Google puso especial énfasis en la calibración de probabilidades. En Top-1 ECE (error esperado de calibración), Decision 1 marca 0.0250, Jev 0.0494, Luna 0.0721 y Flash-Lite 0.2104. Con esas cifras, su error de calibración es un 65% menor que el de Luna y un 88% menor que el de Flash-Lite.
Esta métrica es la que más importa para agentes. Imagina un agente que revisa un fragmento de código en busca de fallos de seguridad. Un modelo que responde sí o no y además da una probabilidad permite fijar un umbral: actuar en automático por encima y enviar a revisión humana por debajo. Si el modelo acierta nueve de cada diez veces cuando dice estar seguro al 90%, ese umbral se puede fijar con precisión. Un modelo mal calibrado lo vuelve difícil.
Muchos modelos nuevos solo publican benchmarks. Google también describió cuatro formas en que la Decisions API se usa en sus propios productos.
Gemini Notebook: enrutamiento de modelos en tiempo real. Es el ejemplo más útil. Para cada solicitud entrante, la Decisions API juzga primero qué tan compleja es y luego elige un nivel de modelo y cuánto razonamiento usar. Las consultas cotidianas van a modelos más rápidos y baratos, y el razonamiento complejo va a modelos fuertes. Google dice que esto redujo la latencia en consultas diarias hasta un 40%.
Esto encaja con hacia dónde van los agentes. Un agente toma muchas decisiones pequeñas mientras trabaja: qué herramienta usar, a qué modelo llamar, si una persona debe revisar el resultado. Si cada decisión simple va a un modelo generativo grande, la latencia y el coste se acumulan. Un modelo de decisión dedicado divide el trabajo: los juicios claros van a un modelo de baja latencia y el trabajo complejo se queda en un LLM general.
Stitch: wireframes interactivos en segundos. El nuevo experimento Rapid Canvas en Stitch usa la Decisions API para generar wireframes interactivos de un flujo de producto en segundos y aplica casi al instante cambios hechos por voz o toque. Cuando la dirección es correcta, un clic lleva las pantallas a la experiencia completa de Stitch para seguir diseñando. La demo en la publicación de Sundar Pichai muestra esta función.
CC: elegir un emoji entre más de 200 opciones. CC de Google Labs lo usa para elegir la reacción emoji adecuada entre más de 200 opciones en una fracción de segundo, de modo que las reacciones aparecen sin añadir latencia.
Google Search: una capa de seguridad para herramientas MCP. Search usa la Decisions API para añadir una capa de seguridad a herramientas MCP, detectando comportamiento y contenido adversarial dentro del presupuesto de latencia.
Obtén una clave API en Google AI Studio para empezar. Hay un nivel gratuito para prototipos. Google ofrece tres apps de demostración —Doorstep Parcels, Speed Sketch y Find the Zoo Keeper— y la documentación incluye guías para Python, JavaScript y REST.
Además del SDK google-genai, están llegando integraciones con OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit y OpenCode, y pronto llegará soporte para Gemini en Google Cloud.
Todos los modelos se tarifican a precios oficiales de API. Sin cargos sorpresa, cancela cuando quieras.