Ya salió Claude Fable 5.2: benchmarks, precios y nuestra opinión
Benchmarks oficiales de Fable 5.2, los nuevos precios más bajos, qué nivel de esfuerzo usar y cómo cambiar a él en CodingPass Pro.
Casi todos los gráficos oficiales de OpenAI ponen el coste por tarea en el eje horizontal. El ahorro es real: en Agents' Last Exam, Astra cuesta apenas el 5% que Fable 5.2. Pero en programación no avanza, alucina más y su poca claridad al redactar planes ya genera quejas. Aquí cruzamos las cifras de OpenAI, Artificial Analysis y las primeras pruebas reales.
OpenAI ha lanzado GPT-6.2 Astra y GPT-6.2 Sol. Astra ocupa el lugar de modelo insignia para los “proyectos más exigentes”, mientras que Sol queda como caballo de batalla diario. Llegan el mismo día a ChatGPT, Codex y la API bajo los ID gpt-6.2-astra y gpt-6.2-sol.
Desde principios de noviembre ya se veían pruebas limitadas de GPT-6.2 Sol en ChatGPT, y el despliegue general tardó casi veinte días en llegar. El argumento principal de esta generación es uno: el precio. Casi todas las gráficas de la página de lanzamiento de OpenAI miden el rendimiento frente al coste por tarea; Astra recorta su tarifa oficial un 20% y deja la factura por ejecución en una fracción de la de sus rivales.
Al juntar las cifras oficiales con las mediciones independientes de Artificial Analysis (AA) y las primeras pruebas de desarrolladores, el balance es menos favorable. En código no hay salto, la tasa de alucinación empeora y la redacción de planes sigue siendo confusa. Al día siguiente del lanzamiento, parte de la comunidad ya había vuelto a Claude.
En resumen: GPT-6.2 recorta de verdad la factura, pero solo mejora con claridad en investigación científica, 3D y análisis legal. En el AA Coding Agent Index, Astra empata con GPT-6 Astra (53) y Sol cae 3 puntos frente a GPT-6.1 Sol; la tasa de alucinación de Astra sube del 50% al 59%. En tareas largas, las quejas se repiten: se queda dando vueltas sin avanzar y no sabe explicar qué ha hecho. Para escribir código conviene seguir con Claude; para revisión de código, GPT-6.2 Sol es hoy la opción más rentable.
Mientras la página oficial presume de curvas de coste, la recepción técnica en Hacker News y X dio un giro en menos de veinticuatro horas. Las críticas hacia Astra superan a los elogios y apuntan a los mismos fallos.
Bloqueos en tareas largas. El testimonio más viral llegó de Theo, creador de T3 Code, quien publicó el 17 de noviembre la carta abierta que había enviado a OpenAI durante las pruebas previas bajo el título “Why I hate GPT-6.2 Astra” —más de 1.75 millones de visualizaciones en un día. Puso a prueba el modelo en una reescritura en Rust del compilador de TypeScript: modelos anteriores de OpenAI habían consumido más de $300,000 en tokens sin avances reales, mientras que Opus cerró el trabajo en menos de dos semanas por unos $20,000. Al pasar a GPT-6.2 Astra, el modelo estuvo siete días seguidos sin lograr una sola mejora, empeñado en reducir el tamaño del binario hasta volver el compilador un 56% más lento; al pedirle centrarse en rendimiento, corrió cuatro días más sin cambios. En otra tarea se detuvo a las dos horas para preguntarle cómo nombrar un archivo interno intermedio.
Incapaz de resumir su propio trabajo. El mismo defecto que aparece luego al redactar planes técnicos. Theo ya aplica una rutina fija: cuando Astra termina una ejecución larga, le pasa la salida a Opus 5.5 para que la resuma. Al preguntar por qué un worktree iba más lento en una máquina que en otras tres, Astra soltó cuatro párrafos sobre la caché de pnpm; Opus 5.5 respondió en una línea: el SSD es lento. Cambiar el prompt del sistema para pedirle explicaciones sencillas tampoco resolvió el problema.
Supervisión constante. En Hacker News, varios desarrolladores coinciden en que Astra es capaz, pero exige una vigilancia continua y prompts muy medidos que Opus 5.5 no necesita. Otros señalan que Sol sigue tendiendo a la sobreingeniería y que la calidad del código de Astra no justifica su tarifa. Incluso en revisiones puede inflar hallazgos: en una prueba sobre código en producción, Astra marcó 12 incidencias —8 de ellas P2—, pero tras contrastarlas con Fable 5.2 solo quedaron 8 de nivel P3.
Misma velocidad. Las mediciones independientes sitúan a ambos modelos entre 20 y 80 tokens por segundo, igual que la generación anterior y unas cinco veces más lentos que los modelos de Anthropic. Varios usuarios reconocen haber regresado directamente a Opus 5.5.
Los elogios existen y coinciden justo con los puntos fuertes de los benchmarks: el propio Theo reconoce que Astra es un gran revisor de código, líder en 3D y videojuegos, y muy sólido en uso de ordenador. En HN también hay quien prefiere Sol frente a Opus 5.5 y destaca que, por primera vez, el diseño de interfaces alcanza a Claude.
En nuestra opinión, la brecha entre los gráficos y la experiencia real está en lo que las pruebas automáticas no miden: si un agente sabe salir de un atasco en sesiones largas y explicar con claridad lo que hizo. Las curvas de coste calculan una ejecución aislada, pero dejan fuera el tiempo humano de supervisión o el gasto de llamar a otro modelo para traducir la respuesta.
Astra rebaja un 20% tanto la entrada como la salida, y recorta la lectura de caché de $1 a $0.40 por millón de tokens. Sol mantiene intactas sus tarifas. Con $8 / $40, Astra calca el precio oficial de Fable 5.2 tras su última rebaja, igual que ocurrió cuando GPT-6 Astra se alineó con Fable 5.
| Modelo | Entrada | Lectura de caché | Escritura en caché | Salida | Corte de conocimiento |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $40 | 2026-05-18 |
| GPT-6 Astra | $10 | $1 | $12.50 | $50 | 2026-04-30 |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $10 | 2026-06-01 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $10 | 2026-04-30 |
Ambos modelos ofrecen una ventana de contexto de 1,050,000 tokens y un máximo de 128,000 tokens de salida. Conviene leer la letra pequeña de la documentación oficial de OpenAI antes de lanzar agentes largos:
La fecha de corte de conocimiento avanza entre dos semanas y un mes. Durante las pruebas previas, la comunidad distinguía las versiones sin conexión preguntando si conocían Fable 5: ni GPT-6 Astra ni GPT-6.1 Sol sabían de su existencia.
La prueba estrella de OpenAI para este lanzamiento es Agents' Last Exam, centrada en tareas profesionales largas de varios pasos. Con nivel de razonamiento xhigh, Astra alcanza un 78.3% a $2.89 por tarea; Fable 5.2 en Max marca un 72.8% a $60.05. OpenAI lo resume como “5.5 puntos más por el 5% del coste”.
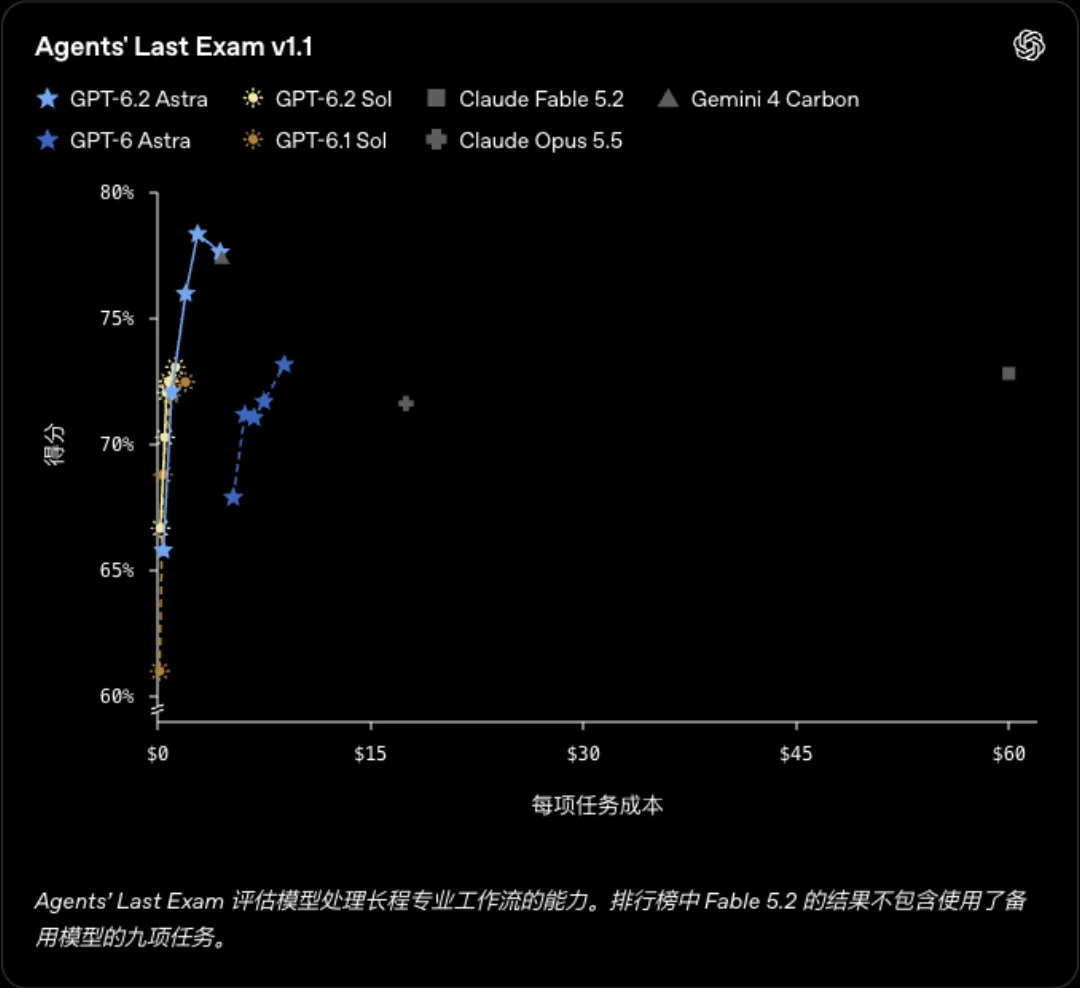
El gráfico deja tres detalles relevantes al mirarlo de cerca:
high, Carbon obtiene un 77.4% a $4.60, a solo 0.9 puntos de la mejor marca de Astra. Además, cuando Astra sube a Max baja al 77.6% y sube a $4.47, quedando al mismo nivel que Carbon. El texto de OpenAI solo compara con Fable 5.2 y GPT-6 Astra, y omite a Carbon.Max logra un 73.0% a $1.32, empatando con el anterior buque insignia GPT-6 Astra (73.1%, $8.99) por una séptima parte del coste.Resumen de las demás pruebas publicadas por OpenAI, tomando la mejor configuración de cada modelo:
| Benchmark | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | Claude Fable 5.2 |
|---|---|---|---|---|
| Agents' Last Exam | 78.3% ($2.89) | 73.0% ($1.32) | 73.1% ($8.99) | 72.8% ($60.05) |
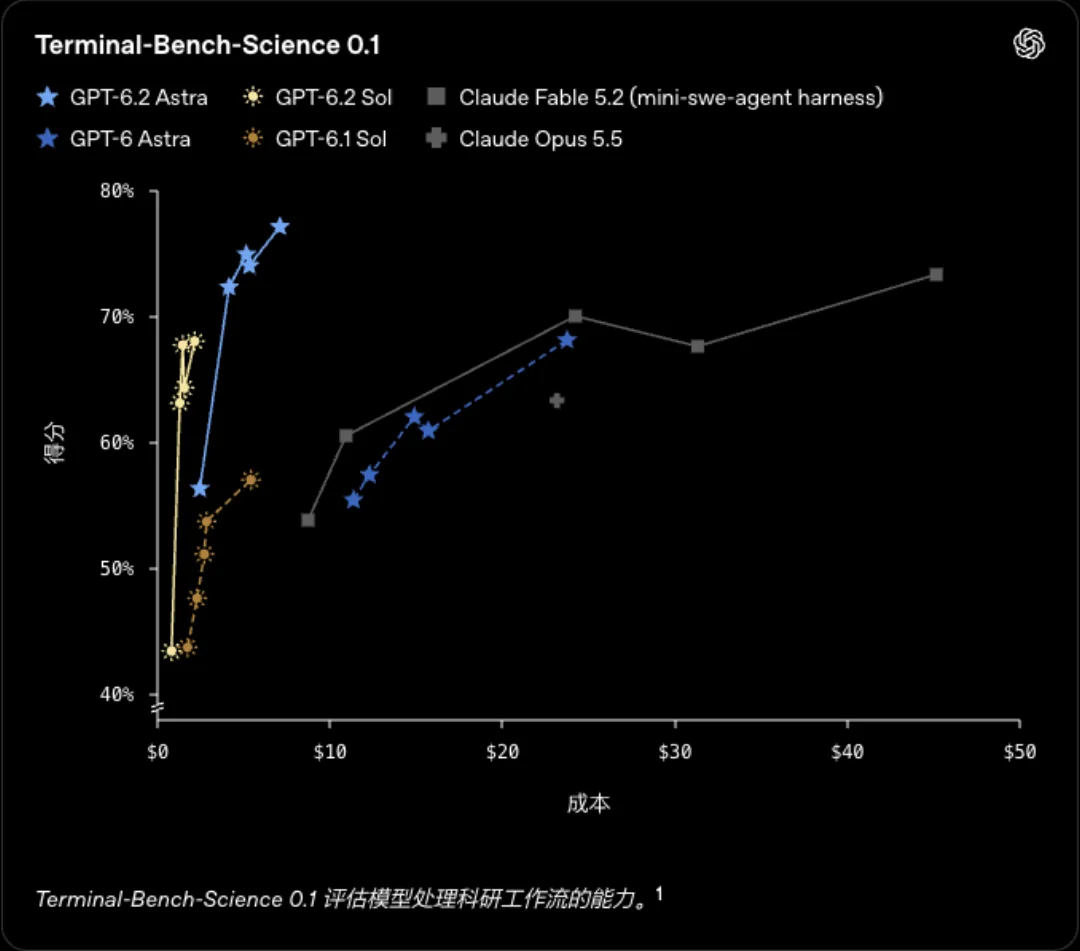
| Terminal-Bench-Science 0.1 | 77.1% ($7.15) | 68.0% ($2.21) | 68.1% ($23.80) | 73.3% ($45.21)* |
| FrontierCode 2.0 | 44.2% ($5.97) | 43.8% ($1.29) | 42.8% ($6.68) | 49.1% ($14.19) |
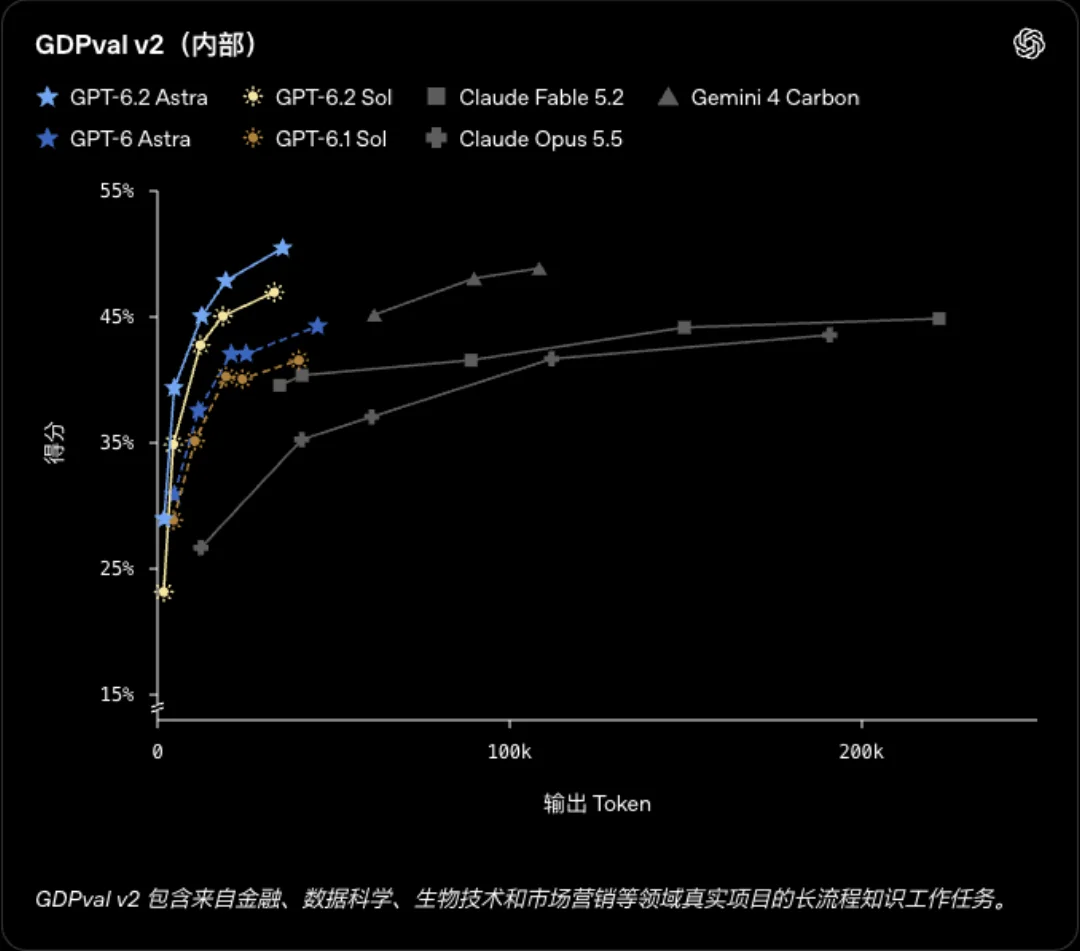
| GDPval v2 (interno de OpenAI) | 50.4% | 46.9% | 44.2% | 44.8% |
| Harvey LAB-AA v1.1 | 15.0% ($6.35) | 11.1% ($1.92) | 8.6% ($13.67) | 7.2% ($39.84) |
| LifeVal | 86.1% ($4.23) | 83.8% ($1.27) | 79.8% ($9.04) | — |
* La cifra de Fable 5.2 en Terminal-Bench-Science procede de AA usando el marco mini-swe-agent. En la nota al pie, la propia OpenAI recuerda que Anthropic reporta un 74.6% para Fable 5.2 en Max dentro de Claude Code.
La ciencia es su mayor baza. Terminal-Bench-Science evalúa investigación científica desde la terminal; ahí Astra saca 9 puntos a GPT-6 Astra con menos de un tercio del coste. Con ese dato, OpenAI lo presenta como “el mejor modelo del mundo para científicos” y lidera también el Vals Science Index. Quienes ya usaban GPT para investigación amplían aquí su margen.
GDPval v2 y tareas legales. GDPval v2 es una prueba interna de OpenAI con flujos reales de consultoría, finanzas y diseño. Astra sube 6.2 puntos respecto a GPT-6 Astra generando un 22% menos de tokens de salida, y Sol supera en 5.3 puntos a GPT-6.1 Sol. En la prueba legal Harvey LAB-AA, Astra duplica con creces la tasa de éxito de Fable 5.2 por una sexta parte del gasto, aunque conviene no perder de vista la escala: solo aprueba si cumple todos los requisitos sin alucinaciones relevantes, y un 15% implica que el 85% de los entregables siguen suspendiendo.
Fuerte caída en razonamiento bajo. LifeVal evalúa gestiones cotidianas como comparar guarderías, buscar piso o planificar menús. En Max, Sol llega al 83.8% costando siete veces menos que GPT-6 Astra. Sin embargo, al bajar a low, Sol se desploma al 25.3% frente al 66.8% que lograba GPT-6.1 Sol en ese mismo ajuste; Astra también cae del 67.5% al 46.3%. Ahorrar bajando el nivel de razonamiento sale mucho peor en esta versión.
OpenAI afirma que Astra escribe código “más limpio” y maneja mejor los cambios complejos en repositorios existentes. Pero sus propios gráficos de FrontierCode 2.0 cuentan otra historia.
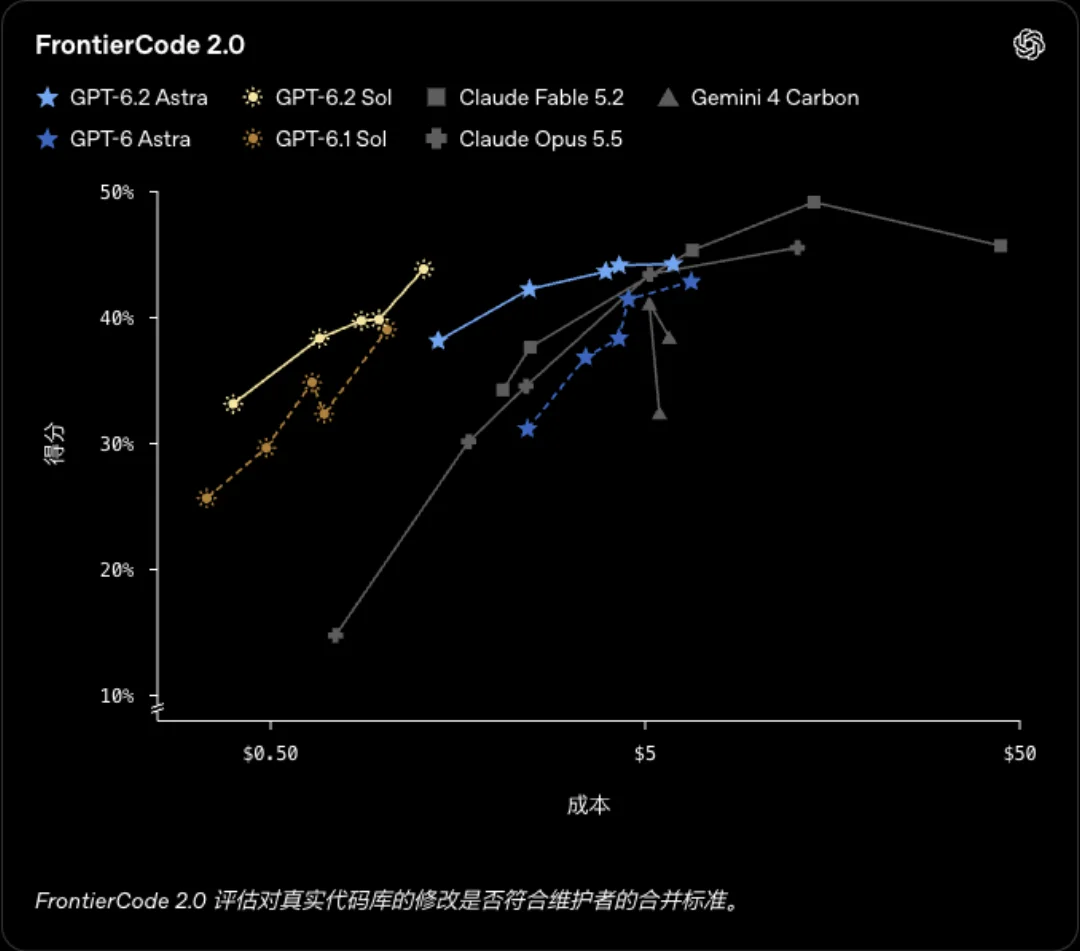
FrontierCode 2.0 mide si un parche cumple el criterio de aceptación de los mantenedores. El techo de Astra es 44.2%, por debajo del 49.1% de Fable 5.2 e incluso del 45.5% de Claude Opus 5.5; frente a GPT-6 Astra apenas suma 1.4 puntos. Por eso OpenAI destaca otro dato en su texto: que Sol queda a menos de medio punto de Astra costando una quinta parte.
La evaluación independiente de Artificial Analysis es todavía más tajante. En el AA Coding Agent Index (ejecutado sobre Codex en nivel Max), GPT-6.2 Astra obtiene 53 puntos, exactamente los mismos que GPT-6 Astra; GPT-6.2 Sol cae a 49, tres puntos menos que GPT-6.1 Sol. En Claude Code, tanto Fable 5.2 como Opus 5.5 marcan 58.
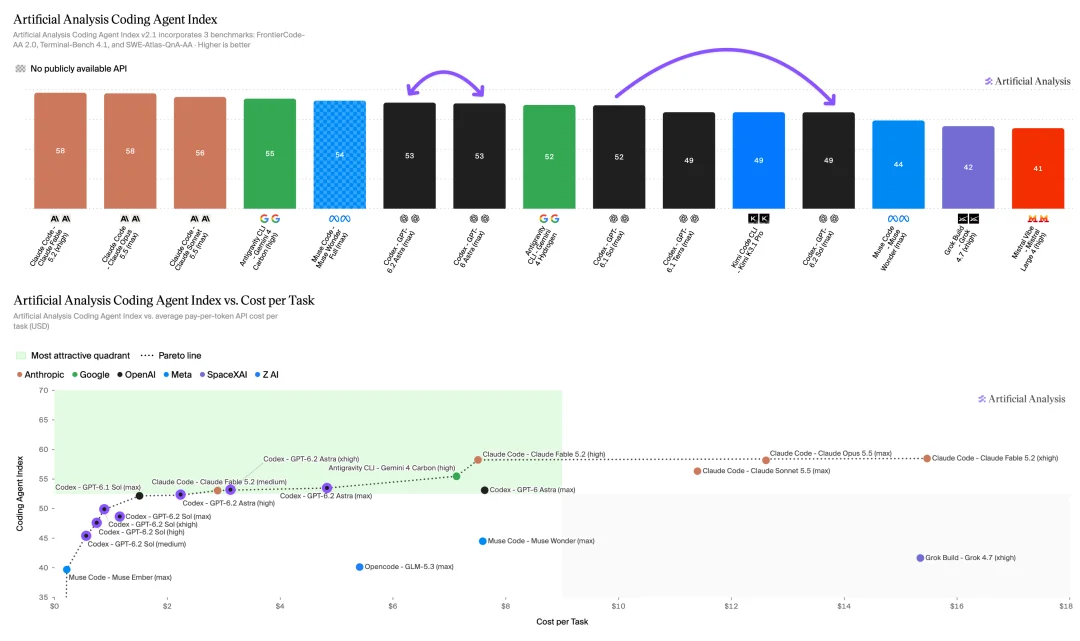
AA explica el retroceso por la caída de 14 puntos de Sol en SWE-Atlas-QnA-AA: omite datos clave con más frecuencia que su predecesor. Al mismo tiempo, confirma que en coste por tarea varios niveles de razonamiento de Astra y Sol se sitúan en la frontera de Pareto; el ahorro no está en discusión.
El AA Intelligence Index v5 combina nueve benchmarks. GPT-6.2 Astra en Max suma 62 puntos (+5 frente a GPT-6 Astra), adelanta a Gemini 4 Carbon (60) y Claude Opus 5.5 (59), y queda segundo tras Claude Fable 5.2 (65). GPT-6.2 Sol llega a 57 (+2 sobre GPT-6.1 Sol), igualando a GPT-6 Astra por cerca del 15% de su coste por tarea.
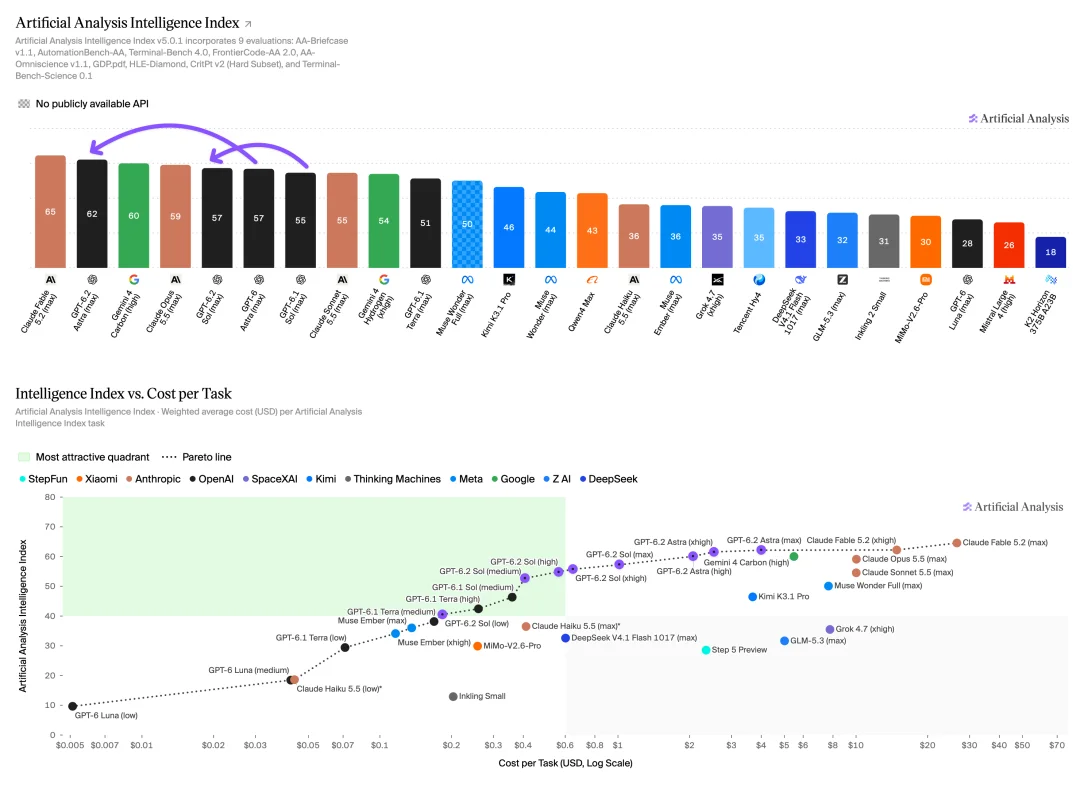
Durante las pruebas previas circuló el rumor de que GPT-6.2 Sol marcaba 60 puntos y empataba en cabeza. La medición final lo deja en 57, tres puntos por debajo.
La clave del ahorro está en la brevedad. AA midió el promedio de tokens de salida por tarea en el Intelligence Index:
| Modelo (nivel) | Tokens de salida / tarea | Precio salida (1M) | Coste salida / tarea |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 40K | $10 | $0.40 |
| GPT-6.2 Astra (Max) | 41K | $40 | $1.64 |
| GPT-6 Astra (Max) | 52K | $50 | $2.60 |
| Gemini 4 Carbon (High) | 123K | $10 | $1.23 |
| Claude Fable 5.2 (Max) | 274K | $40 | $10.96 |
Aunque Fable 5.2 y Astra comparten tarifa por millón de tokens, Fable 5.2 genera 6.7 veces más tokens de salida en la misma tarea, lo que multiplica la factura final por un orden de magnitud. En ChatGPT Pro ($200/mes), un desarrollador comprobó que 4 casos de vídeo y 3D, 2 propuestas grandes y casi un centenar de revisiones de código con Astra consumieron apenas el 6% de su límite semanal; con Fable 5.2, 10 casos similares habían gastado casi el 30%.
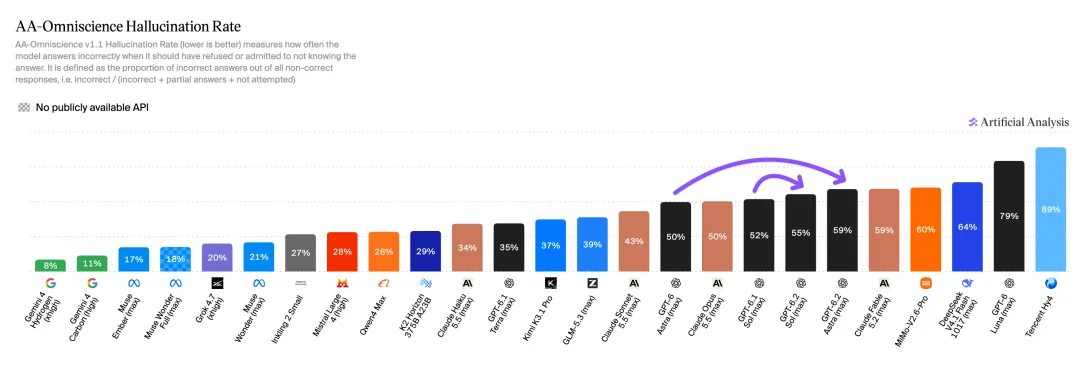
Recortar tokens tiene un peaje. En AA-Omniscience, que mide con qué frecuencia inventa datos cuando desconoce la respuesta, la tasa de alucinación de GPT-6.2 Astra sube del 50% al 59%, y la de Sol pasa del 52% al 55%. Gemini 4 Carbon se mantiene en el 11%.
Las pruebas sobre proyectos reales confirman las tablas anteriores: lo que ya hacía bien mejora, y sus carencias siguen intactas.
Gran salto en revisión de código. Escribir con Claude y pasar el resultado por GPT hasta tres rondas se ha vuelto un flujo habitual. En un conjunto propio de pruebas con nivel xhigh, GPT-6.1 Sol detectó el 65% de los fallos, GPT-6.2 Sol subió al 84% y GPT-6.2 Astra llegó al 96%. Astra tarda el doble y cuesta cuatro veces más que Sol para cazar una decena extra de errores, por lo que GPT-6.2 Sol en xhigh queda como opción predeterminada para revisar código.
Planes poco claros. Al pedir una sección de comentarios de bajo coste y conforme a normativa para una web de noticias mantenida por una sola persona, Gemini 4 Carbon entregó en 5 minutos una propuesta estructurada: primero requisitos legales (verificación, moderación previa), luego diseño mínimo (sin apodos personalizados ni hilos anidados) reutilizando el agente automático del sitio, y una comparativa final. GPT-6.2 Astra tardó 24 minutos en devolver un texto breve pero enrevesado, sugiriendo moderación manual inicial —poco viable para un proyecto unipersonal. En legibilidad e iniciativa, queda incluso por detrás de las primeras versiones de GPT-6 Astra.
Estética desigual, 3D sobresaliente. Con el mismo prompt para un vídeo animado por el cuarto aniversario de ChatGPT, Fable 5.2 y Gemini 4 Carbon entregaron piezas aprovechables, mientras que el resultado de Astra dejó mudo al evaluador. En 3D ocurre lo contrario: un juego de parkour en primera persona, una estación rural de otoño en Three.js y la reconstrucción de una polis griega a partir de una imagen superaron lo esperado, con más de una hora de ejecución en el último caso.
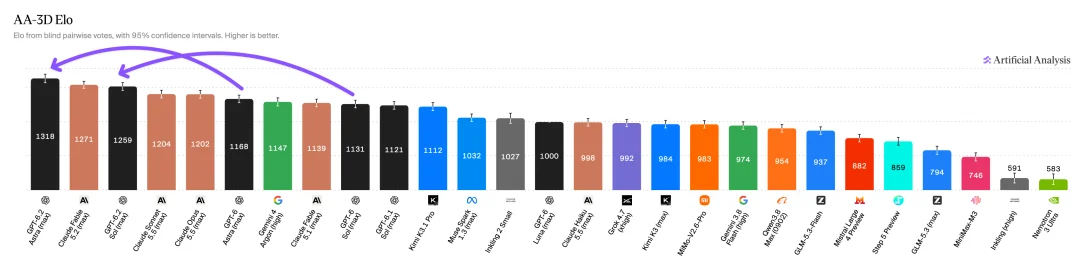
Los datos de AA-3D respaldan esa impresión. En votación ciega por pares con evaluadores humanos, GPT-6.2 Astra lidera con 1,318 puntos Elo, frente a 1,271 de Fable 5.2 y 1,259 de GPT-6.2 Sol. En el avance de AA-Robotics, Astra marca 79 y Sol 78, por encima del 75 de Fable 5.2.
La página oficial suma otros ejemplos de Astra: un libro editable de valoración financiera (8% de descuento y 3% de crecimiento perpetuo), una presentación de 19 diapositivas fiel a la plantilla corporativa, modelado pieza por pieza en CAD de un buggy teledirigido y un motor de seis cilindros en línea, y el juego jugable Meridian Sound Racing. En AA-AnalystAgent, Astra resuelve bien las cinco repeticiones independientes en el 62.5% de los casos.
La propia compañía documenta tres limitaciones en el lanzamiento y en la ficha del sistema de GPT-6.2:
Como el precio por millón de tokens no refleja el gasto real, la siguiente tabla proyecta 100 y 1,000 ejecuciones a partir del coste por tarea de OpenAI en Agents' Last Exam. La columna “Coste por acierto” divide ese importe entre la puntuación —sin contar el tiempo humano de corrección.
| Modelo (nivel) | Puntuación | Por tarea | 100 tareas | 1,000 tareas | Coste por acierto |
|---|---|---|---|---|---|
| GPT-6.2 Sol (Max) | 73.0% | $1.32 | $132 | $1,320 | $1.81 |
| GPT-6.2 Astra (xhigh) | 78.3% | $2.89 | $289 | $2,890 | $3.69 |
| Gemini 4 Carbon (High) | 77.4% | $4.60 | $460 | $4,600 | $5.94 |
| GPT-6 Astra (Max) | 73.1% | $8.99 | $899 | $8,990 | $12.30 |
| Claude Opus 5.5 (Max) | 71.6% | $17.57 | $1,757 | $17,570 | $24.54 |
| Claude Fable 5.2 (Max) | 72.8% | $60.05 | $6,005 | $60,050 | $82.49 |
El cálculo de Gemini 4 Carbon usa su tarifa de lanzamiento; a partir del 1 de diciembre su precio por token se duplica.
En programación con FrontierCode 2.0, el coste por parche válido (coste por tarea dividido entre la puntuación) queda así: $2.95 en GPT-6.2 Sol, $13.51 en GPT-6.2 Astra, $28.18 en Claude Opus 5.5 y $28.90 en Claude Fable 5.2. En nuestra opinión, esa tabla resume el papel real de esta generación: Sol alcanza casi el 90% de la puntuación de Fable 5.2 por una décima parte de la factura, mientras que Astra queda en terreno de nadie: cuesta 4.6 veces más que Sol por apenas 0.4 puntos extra en código.
| Carga de trabajo | Recomendación | Motivo o peaje |
|---|---|---|
| Programación y refactorizaciones grandes | Claude Fable 5.2 / Opus 5.5 | Lideran FrontierCode y AA Coding Agent Index; Fable 5.2 consume muchos tokens |
| Revisión de código y búsqueda de bugs | GPT-6.2 Sol (xhigh) | 84% de detección en pruebas reales por un cuarto del precio de Astra; sube a Astra si buscas el 96% |
| Ciencia, análisis de datos y experimentos en terminal | GPT-6.2 Astra | Primero en Terminal-Bench-Science por una sexta parte del coste de Fable 5.2 |
| 3D, Three.js y prototipos de juegos | GPT-6.2 Astra | Primero en AA-3D; flojo en vídeo y animación |
| Planificación técnica y redacción | Gemini 4 Carbon / Claude | GPT-6.2 resulta lento y poco claro |
| Verificación de datos y citas precisas | Gemini 4 Carbon | GPT-6.2 alucina entre un 55% y un 59%, frente al 11% de Carbon |
| Agentes en volumen a bajo coste | GPT-6.2 Sol (medium o superior) | Evita el nivel low: en LifeVal cae al 25.3% |
Una combinación habitual consiste en dejar que Claude o Gemini tracen el plan y escriban el código, y pasar a GPT-6.2 la ejecución de subtareas estrictas y la revisión. La familia GPT sigue siendo metódica, obediente y densa en información —ideal para ciencia o algoritmos—, pero sigue sin destacar cuando toca tomar la iniciativa o explicar con claridad.
GPT-6.2 Sol está incluido en Plus ($30 al mes), Pro y Team Pass, con un máximo mensual de $200 en Plus. GPT-6.2 Astra está disponible en Pro ($100 al mes) y Team Pass, hasta $500 al mes en Pro. El consumo se tarifica a precios oficiales de API de OpenAI, incluida la lectura de caché.
codex -m gpt-6.2-sol # Revisión de código y agentes diarioscodex -m gpt-6.2-astra # Ciencia y 3DLos pasos de configuración están en la guía de Codex; en OpenCode o Cline basta con usar el mismo ID de modelo. Si solo escribes código y no necesitas las funciones científicas o 3D de GPT, no hace falta subir de plan: Claude Sonnet 5.5 en Go y Opus 5.5 en Plus siguen siendo más fiables programando que GPT-6.2.
Cambia de modelo con una sola clave, tarificada a precios oficiales de API. Sin cargos sorpresa, cancela cuando quieras.