Todos los modelos
ID de cada modelo, plan mínimo y cuota mensual en Go, Plus y Pro.
Alibaba presenta su modelo insignia propietario Qwen4-Max: 2.4T parámetros con 71B activos por token, primer puesto en 4 de los 16 benchmarks oficiales y acierto de caché desde CNY 0.5 por millón de tokens en China continental ($0.075/M internacional). Repasamos las pruebas oficiales y de terceros, los precios nacionales e internacionales, dos facturas reales recalculadas al detalle y qué nivel de esfuerzo elegir según la tarea.
El 16 de noviembre, Alibaba presentó su nuevo modelo insignia Qwen4-Max. Construido sobre la nueva arquitectura de mezcla de expertos (MoE) de la generación Qwen4, cuenta con 2.4T parámetros en el modelo troncal, activa 71B por cada token procesado y añade 328B parámetros adicionales en una capa de N-gram Embedding. Admite una ventana de contexto de 1 millón de tokens y entrada visual nativa, y se ofrece como modelo propietario disponible únicamente mediante API en la nube y aplicaciones oficiales.
Una semana antes de su presentación formal, una versión preliminar empezó a probarse de forma anónima dentro del entorno de programación Qoder y poco después pasó a llamarse Qwen4-Max-Preview. Con el lanzamiento del 16 de noviembre ya están disponibles los resultados completos de benchmarks, los detalles de arquitectura y las tarifas de API. A continuación desglosamos las pruebas oficiales, los rankings independientes, la tabla de precios y las facturas medidas por la comunidad.
En resumen: Qwen4-Max brilla en tareas de agente de largo recorrido, reparación de repositorios de código (75.7 en DeepSWE) y un precio por acierto de caché muy reducido (CNY 0.5 por millón de tokens en China continental y $0.075/M en la API internacional, lo que recorta un 62% el coste por tarea en Work360 frente a la generación previa). En cambio, se queda atrás en ejecución de comandos de terminal (48.5 en Terminal-Bench 4.0), recreación de software de caja negra (31.5 en ProgramBench) y velocidad de respuesta con esfuerzo de razonamiento alto (32.1 minutos de media por tarea en Artificial Analysis). Resulta adecuado para flujos de ingeniería y documentación con contexto largo y múltiples iteraciones; en el trabajo diario conviene mantener el nivel predeterminado high y reservar xhigh para desarrollo full-stack complejo o programación en terminal.
Qwen4-Max introduce tres cambios sobre su arquitectura MoE dispersa (sparse MoE) para rebajar el coste de inferencia en secuencias largas y activar menos parámetros en cada paso:
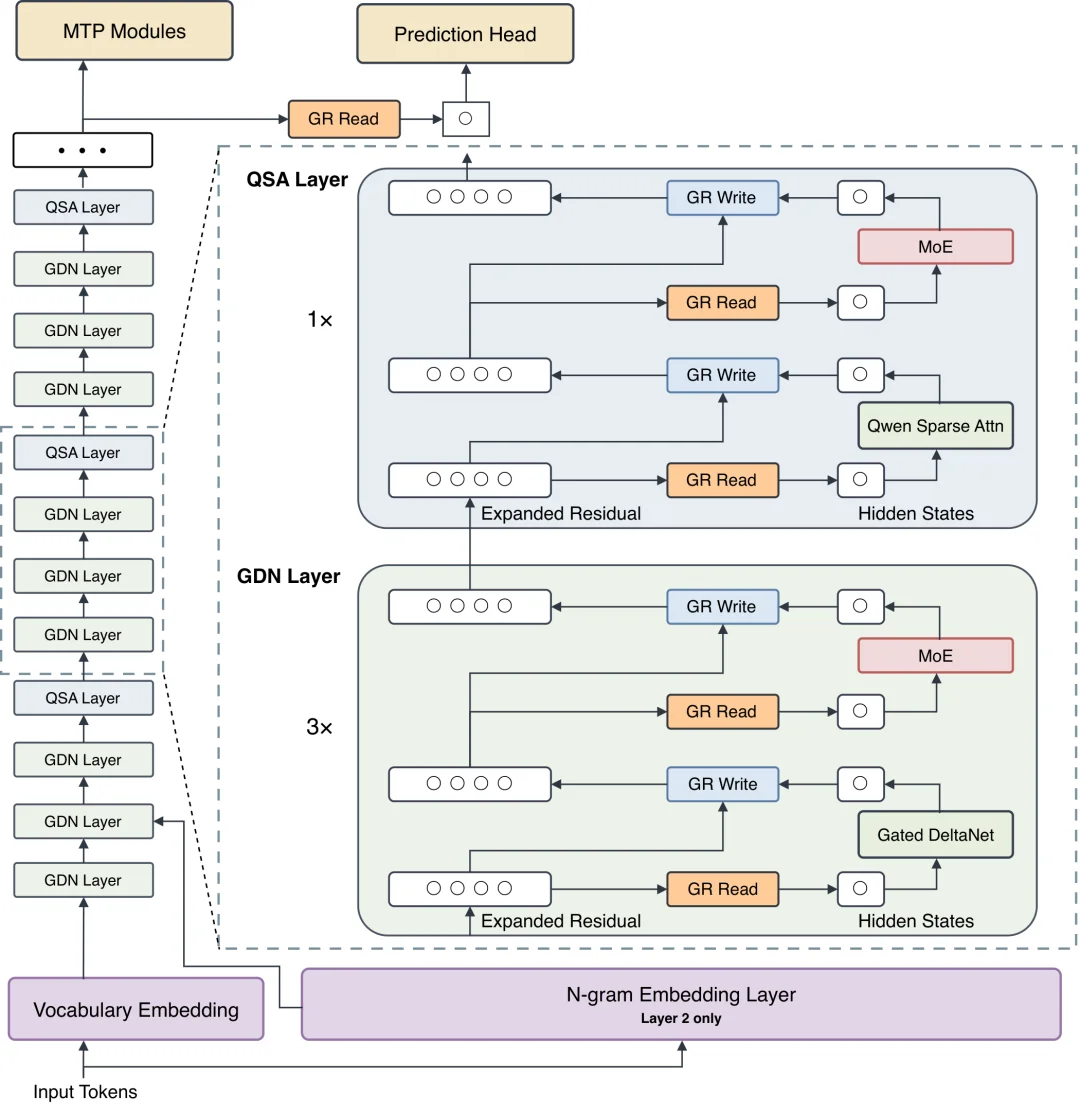
Con este diseño, Qwen4-Max activa 71B parámetros por token —alrededor de un 25% menos que los 95B de Qwen3.8-Max— y completó el preentrenamiento a escala de 2.4T sin picos de pérdida (no loss spikes) en toda la ejecución. En las pruebas internas de modelo base de Qwen sobre conocimiento (Knowledge), código (Code), preguntas y respuestas (QA) y STEM, Qwen4-Max-Base registró la tasa más baja de bits por byte (BPB, donde menos es mejor) entre los 5 checkpoints evaluados, reduciéndola entre un 5% y un 13% respecto a Qwen3.8-Max-Base. Una nota al pie del informe oficial aclara que GLM-5.3 y Kimi-K3.1-Pro incluidos en esa misma gráfica son checkpoints con postentrenamiento (post-trained checkpoints), lo que puede influir en la comparación directa frente a modelos base.
El calendario previo al lanzamiento se desarrolló en apenas diez días: el 6 de noviembre, la cuenta oficial de Qwen en X publicó el adelanto “The becoming begins.”; el 7 de noviembre, el IDE de programación Qoder activó un modelo anónimo llamado Qoduck, gratuito por tiempo limitado para usuarios individuales y actualizado a diario durante los 4 días que permaneció sin nombre; el 11 de noviembre, Qoder desveló su identidad y lo actualizó a Qwen4-Max-Preview (una publicación que superó los 5.4 millones de visualizaciones); y el 16 de noviembre se lanzó la versión definitiva.
Actualmente, Qwen4-Max (ID de modelo qwen4-max) está disponible en modalidad de pago por uso a través de Alibaba Cloud Model Studio en China continental y de QwenCloud en su versión internacional, además de integrarse en la suscripción Token Plan de la región de Singapur. En el apartado de aplicaciones, se puede elegir directamente en QwenWork, Qoder, la app de Qwen y Qwen Studio.
Qwen4-Max no publica sus pesos abiertos. El anuncio oficial se limita a señalar en el último párrafo que los modelos de tamaño pequeño y mediano de la familia Qwen4 se liberarán más adelante como modelos de pesos abiertos, sin concretar número de parámetros ni fechas. En las respuestas al anuncio, la comunidad llenó el hilo con el mensaje “Qwen-4 27B > GTA VI” pidiendo las versiones compactas.
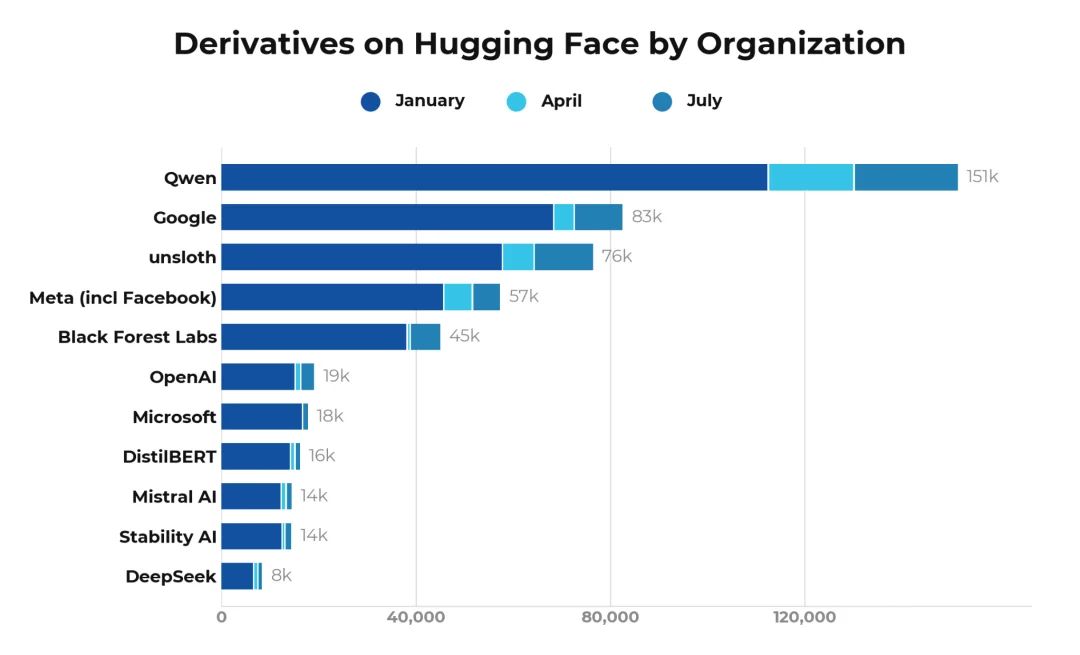
El interés por esas versiones menores se explica porque los modelos de pesos abiertos de Qwen son la base más extendida para despliegues locales y en servidor propio. Según el informe de modelos abiertos de verano de 2026 de Hugging Face, entre enero y agosto de 2026 la familia Qwen acumuló 2,045 millones de descargas en Hugging Face (más de 3,000 millones sumando todas las plataformas, según cifras de Alibaba) y generó 151,448 modelos derivados: 2.6 veces los de Meta y más que Google (82,506) y Meta juntos.
Esa adopción también llega a grandes empresas. En una entrevista en octubre de 2025, el CEO de Airbnb, Brian Chesky, explicó que la atención al cliente con IA de Airbnb se apoya en gran medida en Qwen porque es muy bueno, además de rápido y barato.
Con todo, el modelo propietario más grande no supera automáticamente a sus hermanos abiertos en cualquier carga de trabajo. El usuario chriddyp comentó en Hacker News que, al pasar Qwen4-Max por el benchmark interno de análisis de datos de ciclo corto de su equipo, obtuvo varios puntos menos que Qwen3.8 27B —el modelo de pesos abiertos lanzado en agosto que cabe en hardware de escritorio— y salió algo más caro por ejecución.
El equipo de Qwen publicó 16 benchmarks que cubren programación, trabajo de oficina, investigación científica y capacidades multimodales, comparando Qwen4-Max frente a Qwen3.8-Max-0902, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra y Kimi K3.1.
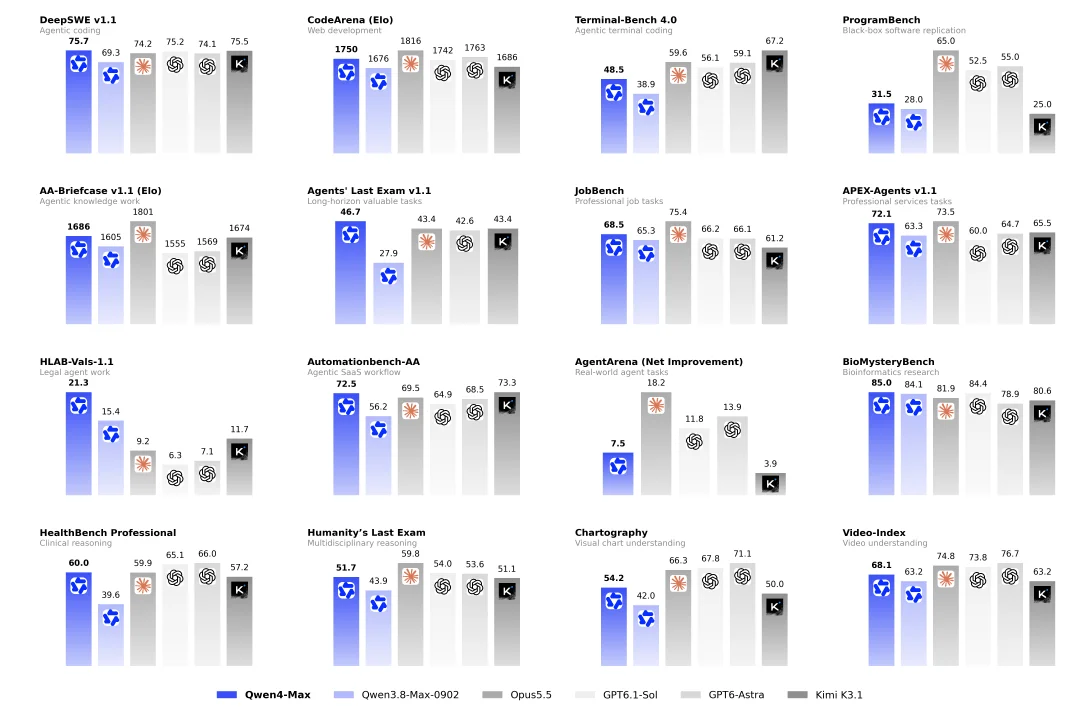
La tabla siguiente recoge las 16 puntuaciones completas del gráfico (en negrita, la nota más alta de cada fila):
| Benchmark | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 (GPT, único dato en el gráfico) | — | 43.4 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | 11.8 | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
La propia gráfica de Qwen incluye tanto las pruebas donde lidera como aquellas en las que queda por detrás:
En el ranking a ciegas de desarrollo web CodeArena: WebDev (datos del 14 de noviembre de 2026, con 159 modelos y más de 1 millón de votos), Qwen4-Max (xHigh) ocupa el 6.º puesto mundial con 1,750 puntos Elo, lo que lo sitúa como el modelo chino mejor clasificado de la tabla (el siguiente es Kimi K3.1 Pro en el puesto 13 con 1,686). Queda justo por detrás de GPT-6 Astra (1,763) y por delante de Claude Fable 5.1 (1,743), GPT-6.1 Sol (1,742) y Claude Sonnet 5.5 configurado en High (10.º con 1,716). Conviene tener presentes dos matices: primero, Sonnet 5.5 en nivel xHigh sube hasta 1,772 puntos (3.º puesto); segundo, Qwen4-Max suma por ahora 1,814 votos, por lo que aparece con la etiqueta Preliminary (resultado preliminar) y un margen de error de ±15 puntos, equivalente a una horquilla de puestos entre el 3 y el 9.
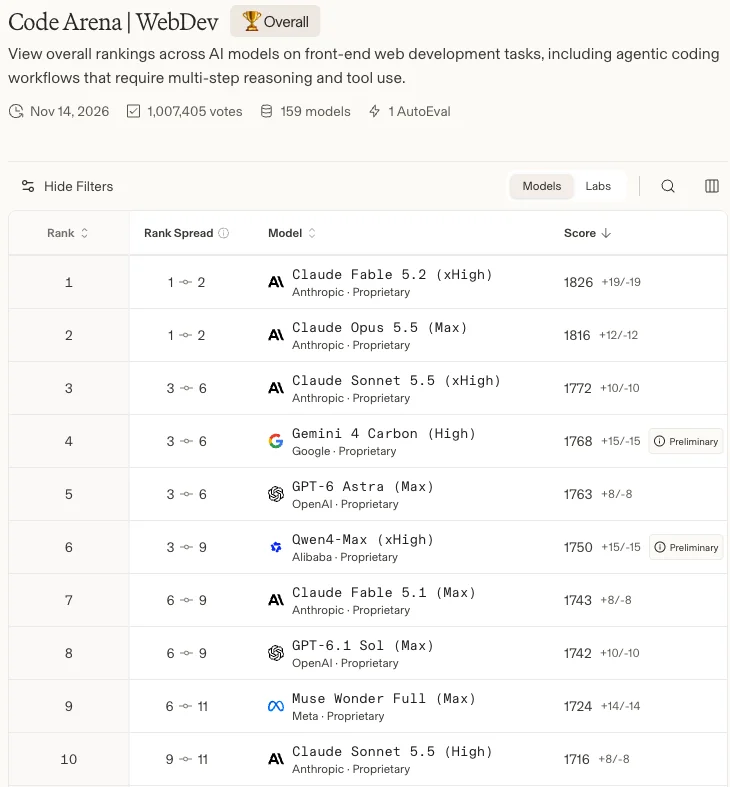
| Puesto | Modelo | Puntuación Elo | Notas |
|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 ±19 | — |
| 2 | Claude Opus 5.5 (Max) | 1816 ±12 | — |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 ±10 | — |
| 4 | Gemini 4 Carbon (High) | 1768 ±15 | Preliminary |
| 5 | GPT-6 Astra (Max) | 1763 ±8 | — |
| 6 | Qwen4-Max (xHigh) | 1750 ±15 | Preliminary; horquilla de puestos 3–9; 1,814 votos; coste/tarea P50 $4.18 |
| 7 | Claude Fable 5.1 (Max) | 1743 ±8 | — |
| 8 | GPT-6.1 Sol (Max) | 1742 ±10 | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 ±8 | — |
| 13 | Kimi K3.1 Pro (Max) | 1686 ±9 | Siguiente modelo chino |
| 16 | Qwen3.8-Max (0902) | 1676 ±6 | Generación anterior |
| 19 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 ±7 | Modelo de referencia en las pruebas de consumo de tokens más abajo |
Por su parte, la evaluación independiente de Artificial Analysis (capturada el 17 de noviembre de 2026) le otorga 43 puntos en el Intelligence Index v5.0.1 —que agrega 9 pruebas—, situándolo en el puesto 38 de 81 modelos (la mediana de modelos comparables es 41). Dentro de la misma tabla, GPT-6.1 Sol (max) alcanza 55 puntos con un coste medio de solo $1.27 por tarea, es decir, 12 puntos por encima de Qwen4-Max ($3.27) y un 61% más barato por tarea; Kimi K3.1 Pro obtiene 46 puntos con un coste de $3.68 por tarea.
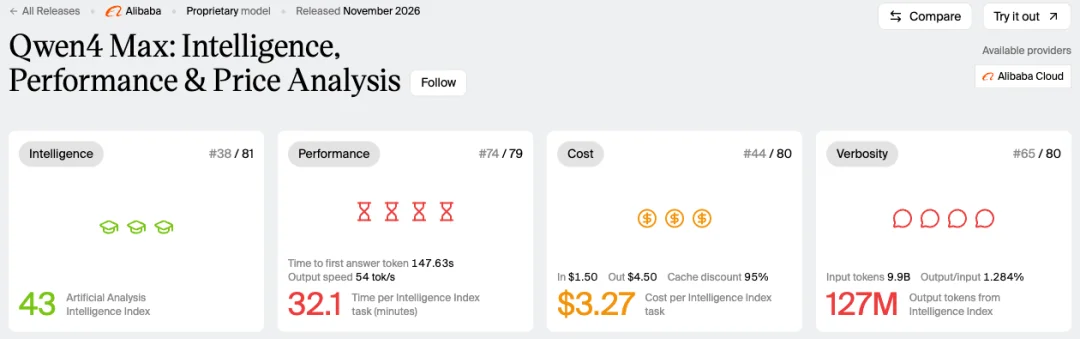
| Modelo | Intelligence Index | Tiempo por tarea (min) | Coste por tarea |
|---|---|---|---|
| Claude Fable 5.2 (max) | 65 | 40.8 | $26.54 |
| Gemini 4 Carbon (high) | 60 | 31.1 | $5.48 |
| Claude Opus 5.5 (max) | 59 | 24.6 | $10.04 |
| GPT-6 Astra (max) | 57 | 20.4 | $6.24 |
| GPT-6.1 Sol (max) | 55 | 23.0 | $1.27 |
| Kimi K3.1 Pro | 46 | 38.8 | $3.68 |
| Qwen4-Max | 43 | 32.1 | $3.27 |
| Grok 4.7 (xhigh) | 35 | 24.6 | $7.77 |
Frente a la generación anterior Qwen3.8-Max, las cifras oficiales muestran que en Work360 el consumo de tokens por tarea de Qwen4-Max cae aproximadamente un 24% en xhigh y un 35% en high. En Terminal-Bench 4.0, el gasto medio por tarea en xhigh pasa de unos 289K a unos 151K tokens (un 48% menos) mientras la puntuación sube de 38.9 a 48.5, y en high el consumo también se reduce cerca de un 49%.
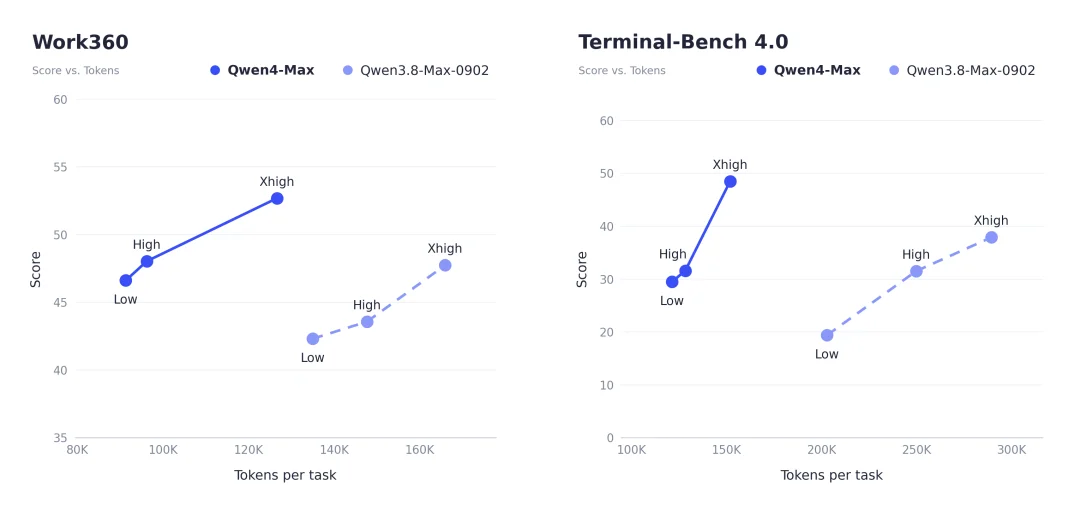
Durante la fase preliminar, varios desarrolladores publicaron pruebas comparativas con el mismo prompt:
Qwen4-Max-Preview a DeepSeek-v4.1-flash-1017: Qwen gastó menos tokens en 87 de las 103 pruebas, con una media de unos 77K tokens por tarea frente a unos 115K en DeepSeek (alrededor de un 33% menos).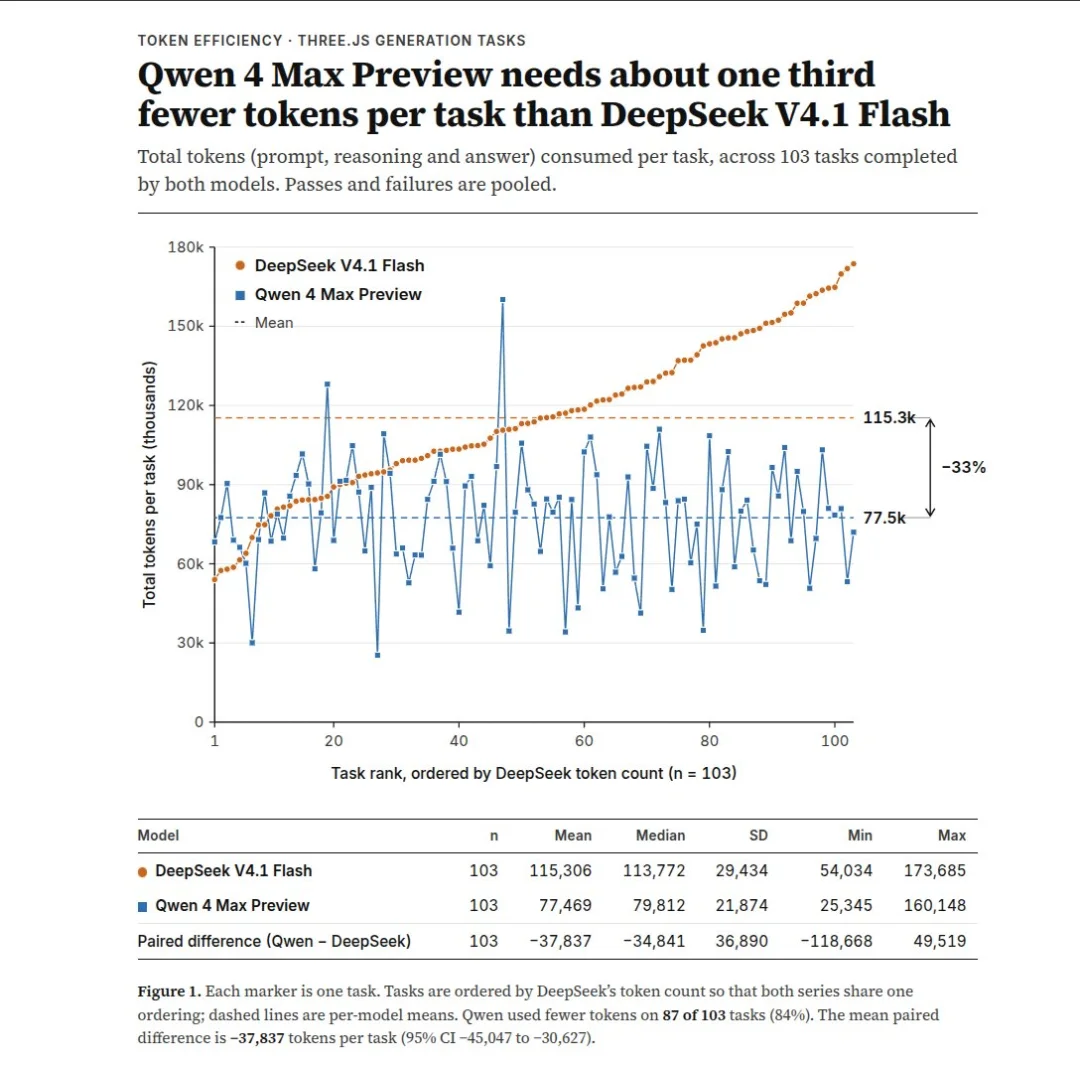
En ambos experimentos de la comunidad se probó la versión preliminar frente a DeepSeek V4.1 Flash. Aunque Qwen ahorró entre un tercio y la mitad de los tokens por tarea, la tarifa de API de DeepSeek V4.1 Flash es de apenas $0.15 / $0.60 por millón de tokens de entrada y salida: diez veces más barata en entrada que Qwen4-Max ($1.50 / $4.50) y unas siete veces más barata en salida. Como señaló el propio @ItsmeAjayKV en su publicación, al meter en la ecuación el precio por token y el tamaño del modelo, deepseek-v4.1-flash gana con claridad.
Por otro lado, en la comparativa de Artificial Analysis, Qwen4-Max generó un total de 127 millones de tokens de salida para completar el Intelligence Index, muy por encima de la mediana de los modelos comparables (78.6 millones), recibiendo la etiqueta “very verbose” (muy prolijo). Además, necesitó 32.1 minutos de media por tarea (mediana de 13.3 minutos), tardó 147.63 segundos hasta el primer token de respuesta y registró una velocidad de salida de 54 tok/s.
| Escenario de prueba | Referencia comparada | Qwen4-Max | Referencia | Observaciones |
|---|---|---|---|---|
| Work360 (xHigh / High) | Qwen3.8-Max-0902 | ≈127K / ≈96K | ≈166K / ≈148K | Usa aprox. un 24% / 35% menos que la generación anterior |
| Terminal-Bench 4.0 (xHigh / High) | Qwen3.8-Max-0902 | ≈151K / ≈129K | ≈289K / ≈250K | Usa aprox. un 48% / 49% menos que la generación anterior |
| 103 tareas en Three.js (preview) | DeepSeek V4.1 Flash | 77.5K / tarea | 115.3K / tarea | 33% menos tokens, pero el precio unitario de DeepSeek es un orden de magnitud inferior |
| Salida total y tiempo por tarea en AA Intelligence Index | Mediana de modelos de frontera comparables | 127M / 32.1 min | 78.6M / 13.3 min | Etiquetado como “very verbose” en AA; tarda unas 2.4 veces la mediana |
En nuestra opinión, el recorte de tokens de Qwen4-Max es palpable cuando se mide contra su antecesor Qwen3.8-Max o frente a DeepSeek V4.1 Flash, pero puesto al lado del conjunto de modelos de frontera actuales, en niveles altos de esfuerzo sigue siendo un modelo lento y extenso en sus respuestas.
Según la documentación de Alibaba Cloud Model Studio, el parámetro de esfuerzo de razonamiento reasoning_effort de Qwen4-Max ofrece tres niveles: low, high y xhigh (el valor predeterminado es high, con un presupuesto máximo de cadena de pensamiento por defecto thinking_budget=131072; si se envían los valores minimal, medium o max, se asignan respectivamente a low, high y xhigh).
Las curvas oficiales de eficiencia en Work360 y Terminal-Bench 4.0 arrojan las siguientes puntuaciones y consumos aproximados por tarea en cada nivel:
| Benchmark | Low | High (predeterminado en versión final) | Xhigh | Diferencia entre High y Xhigh |
|---|---|---|---|---|
| Work360 (tareas de oficina y sectoriales) | ≈46.6 pts (≈91K) | ≈48.0 pts (≈96K) | 52.69 pts (≈127K) | High puntúa 4.7 pts menos y ahorra aprox. un 24% de tokens |
| Terminal-Bench 4.0 (programación en terminal) | ≈29.5 pts (≈122K) | ≈31.5 pts (≈129K) | 48.5 pts (≈151K) | High puntúa 17.0 pts menos y solo ahorra aprox. un 15% de tokens |
Cuando salió la versión preliminar, el nivel predeterminado venía fijado en xhigh, lo que disparaba los tiempos de espera en tareas sencillas. @SrinivasValekar recogió una prueba de generación de una aldea con ambos modelos en xhigh: Gemini 4 Hydrogen terminó en 12 minutos por unos $1.7, mientras que Qwen4-Max tardó 1 hora y 15 minutos con un coste de unos $0.9. Es una única prueba, pero la brecha de tiempo es considerable.
El canal de YouTube The Dark Factory probó qwen4-max-preview dentro de Claude Code mediante Token Plan y comparó el resultado de crear la misma aplicación de presupuesto cambiando el nivel de esfuerzo: al bajar de xhigh (el ajuste por defecto en la preview) directamente a low, el tiempo cayó de 24 a 9 minutos, la lectura de contexto bajó de 4.4M a 1.1M de tokens (-75%), la salida se redujo de 83K a 31K (-63%) y la nota otorgada a ciegas por Codex (GPT-6.1 Sol) subió de 8/10 a 9/10.
| Nivel de esfuerzo | Tokens de salida | Tokens leídos | Tiempo | Evaluación a ciegas (juez GPT-6.1 Sol) |
|---|---|---|---|---|
| Predeterminado en preview (xHigh) | 83K | 4.4M | 24 min | 8 / 10 |
| low | 31K (-63%) | 1.1M (-75%) | 9 min | 9 / 10 |
El experimento de The Dark Factory corresponde a una sola ejecución sobre una app frontend evaluada por un único juez de IA. Cruzando ese dato con las curvas oficiales, en nuestra opinión el ajuste predeterminado high de la versión final basta para ofimática, frontend habitual y consultas generales; en cambio, cuando la tarea implica desarrollo full-stack complejo o agentes de línea de comandos en terminal (el terreno de Terminal-Bench), donde hay 17 puntos de diferencia entre high y xhigh, sigue siendo necesario subir manualmente a xhigh.
Este es el ejemplo mínimo para elegir el nivel de esfuerzo en la Responses API compatible con OpenAI de QwenCloud (internacional):
from openai import OpenAIimport os client = OpenAI( api_key=os.getenv("DASHSCOPE_API_KEY"), base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",) resp = client.responses.create( model="qwen4-max", input="Añade pruebas unitarias para esta función", reasoning={"effort": "high"}, # low / high / xhigh, por defecto high)print(resp.output_text)Las tarifas oficiales de la API se dividen entre China continental (Alibaba Cloud Model Studio) y el servicio internacional (QwenCloud en Singapur). En China continental, la entrada estándar cuesta CNY 10 por millón de tokens y la salida CNY 30 por millón, lo que supone una rebaja de alrededor del 16.7% frente a qwen3.8-max (CNY 12 / 36); el precio por acierto de caché baja a CNY 0.5 por millón de tokens ($0.075 por millón en la API internacional), apenas un 5% de la tarifa de entrada estándar. Sumado al menor consumo de tokens por tarea, el coste total medio por tarea en el benchmark oficial Work360 cae de los $4.43 de la generación anterior a $1.67, un 62% menos.
| Concepto de facturación | China continental (Model Studio) | Internacional (QwenCloud, Singapur) |
|---|---|---|
| Entrada estándar (0 < tokens ≤ 1M, mismo precio con o sin razonamiento) | CNY 10 / millón | $1.5 / millón |
| Salida (tokens de razonamiento + respuesta) | CNY 30 / millón | $4.5 / millón |
| Acierto de caché (explícita / implícita) | CNY 0.5 / millón | $0.075 / millón |
| Creación de caché explícita (TTL de 5 min) | CNY 12.5 / millón | $1.875 / millón |
| Creación de caché explícita (TTL de 1 hora) | CNY 20 / millón | $3 / millón |
| Cuota gratuita para nuevos usuarios | 1 millón de tokens (90 días) | — |
Según la documentación de facturación de Alibaba Cloud Model Studio, las reglas de caché funcionan así: la caché implícita viene activada por defecto sin tocar el código, pero no garantiza el acierto en cada solicitud; la caché explícita exige un prefijo mínimo de 1,024 tokens, permite elegir un tiempo de vida (TTL) de 5 minutos (por defecto) o 1 hora y se renueva automáticamente al acertar; la caché solo se reutiliza entre solicitudes de una misma cuenta; y los tokens de salida (incluidos los tokens de razonamiento) se cobran siempre a la tarifa íntegra de salida.
Tomando los datos de consumo real publicados por @superalesha al generar un puesto de ramen bajo la lluvia nocturna de Tokio en Blender —donde ejecutó el mismo prompt con la versión preliminar en nivel xhigh sobre dos entornos distintos, DeepSeek Harness (DSH) y Qwen Code—, recalculamos la factura con las tarifas públicas de la versión final (coste = entrada sin caché × tarifa de entrada + acierto de caché × tarifa de caché + salida × tarifa de salida):
| Entorno de ejecución (mismo prompt, xHigh) | Entrada total (acierto de caché / sin caché) | Salida | Factura total China continental (con caché) | China continental (suponiendo 0 caché) | Factura total internacional (con caché) | Internacional (suponiendo 0 caché) |
|---|---|---|---|---|---|---|
| DeepSeek Harness | 11.96M (11.59M / 0.37M) | 130K | 3.70 + 5.80 + 3.90 = CNY 13.40 | CNY 123.50 | $2.01 | $18.53 |
| Qwen Code | 3.02M (2.85M / 0.17M) | 62K | 1.70 + 1.43 + 1.86 = CNY 4.99 | CNY 32.06 | $0.75 | $4.81 |
Este desglose deja tres conclusiones prácticas:
Aprovechando el millón de tokens de contexto, la visión nativa y la llamada a herramientas, tanto el blog oficial como la comunidad han mostrado varias tareas autónomas de largo recorrido.
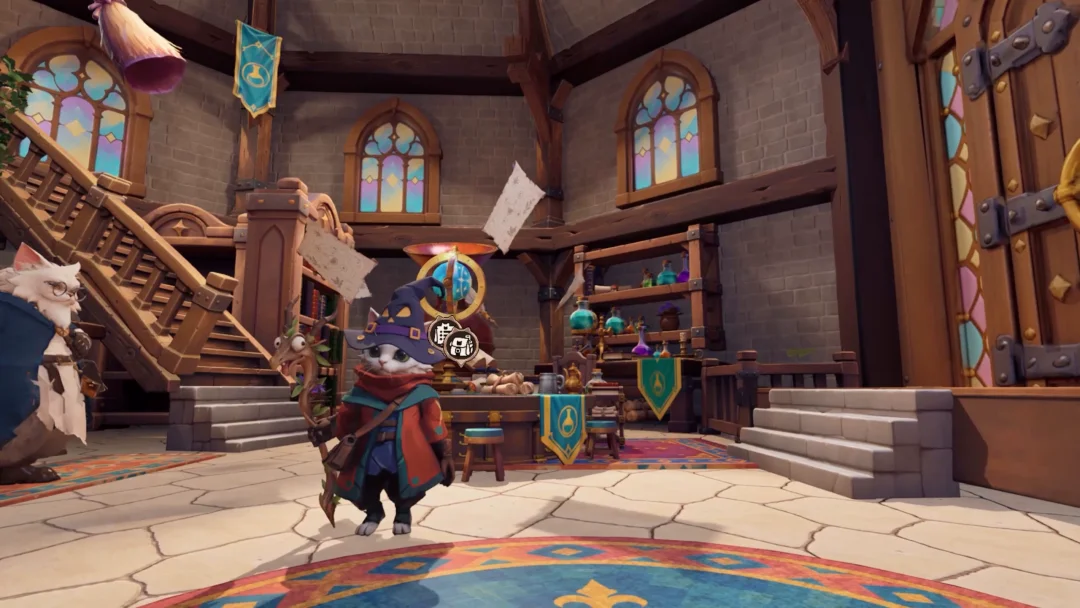
En modelado 3D y desarrollo de videojuegos, @superalesha pidió al modelo construir desde cero en Blender MCP —escribiendo únicamente scripts de Python y sin importar recursos externos— una escena en miniatura de un puesto de ramen en una noche lluviosa de Tokio. El prompt detallaba cortinas noren, farolillos de papel, cuencos humeantes, una máquina expendedora y charcos reflejando los neones con renderizado en Cycles, haciendo que el propio modelo inspeccionara las imágenes renderizadas para detectar fallos y corregirlos. Por su parte, el equipo de Qwen mostró cómo construye escenas directamente desde instrucciones en lenguaje natural en Unity, Unreal Engine y Godot, programando la lógica de juego, integrando assets externos y ajustando cámaras y sensación de impacto al observar la partida en pantalla; entre los ejemplos figuran el juego 3D de aventuras Meow of Magic en Unreal Engine, la aventura fantástica Yun Guan Xing y el juego móvil de carreras para Android Flying Racer en Unity 6.
Para evitar un problema clásico de las tareas largas con agentes —que el modelo se desvíe a mitad de camino y solo se descubra al terminar—, Qwen4-Max estrena el mecanismo Live Delivery (entrega continua) junto con el plugin de código abierto Qwen-Live-Delivery-Plugin: ante un encargo complejo, el modelo entrega primero una versión inicial funcional en poco tiempo y después la amplía versión a versión apoyándose en los resultados de ejecución y las indicaciones del usuario, permitiendo corregir el rumbo en cualquier momento.
En los sectores industrial, financiero, jurídico, médico y científico, Alibaba presentó además 6 casos realizados junto a socios:
| Sector | Flujo de trabajo | Cifras clave |
|---|---|---|
| Fabricación de automóviles (líneas de SANF y Pacific Union) | Construcción de líneas 3D a partir de planos 2D y parámetros de proceso con puesta en marcha virtual de PLC; diseño a nivel de pieza de conjuntos de puertas y ruedas de fricción, generación de trayectorias de mecanizado y simulación previa para detectar sobrecortes o cortes incompletos | El tiempo de programación manual por pieza baja de unos 475 min a 24 min (reducción de aprox. el 95%) |
| Due diligence legal para salidas a bolsa (IPO) | Limpieza de papeles de trabajo (working papers) entregados por tandas con nombres desordenados, renombrado según su contenido real, clasificación en carpetas e indexado; cruce de registros mercantiles, propiedad intelectual, litigios y crédito para detectar riesgos de cláusulas de restablecimiento (reinstatement clauses) en acuerdos de ajuste de valoración (VAM) | Organiza 198 documentos de trabajo en 14 directorios y genera un informe de 86 páginas y más de 60,000 caracteres que cubre 12 áreas de revisión y 14 cuestiones legales, con citas a los documentos fuente en cada conclusión |
| Análisis financiero (futuros sobre el índice CSI 300) | Extracción de datos de acciones clase A, Hong Kong, EE. UU., bonos, fondos y derivados; cálculo de la base teórica de futuros (theoretical futures basis) y diferenciales de volatilidad combinando costes de financiación, rentabilidad por dividendo y vencimientos, generando hojas de Excel con doble trazabilidad y presentaciones PPT editables | Invoca 90 herramientas MCP; cada celda de Excel enlaza directamente con la fuente de datos original y los gráficos del PPT mantienen correspondencia uno a uno con las hojas de cálculo (chart-to-workbook alignment) |
| Asistencia clínica en cuidados intensivos (UCI) | Lectura en una sola conversación de decenas de analíticas, historiales clínicos de más de diez mil caracteres y múltiples órdenes médicas; división de las imágenes originales en 6 secuencias y coordinación de varios subagentes en paralelo para revisar cientos de cortes de TC torácica | Procesa historiales de más de 10,000 caracteres y 1,433 imágenes médicas, identifica consolidación dependiente bilateral (bilateral dependent consolidation) coincidiendo con el diagnóstico del médico responsable y alinea sus 4 recomendaciones terapéuticas con las órdenes médicas del día |
| Investigación científica de ciclo cerrado seco-húmedo (plataforma Mira de Deep Principle) | Para la refrigeración de centros de datos con chips de alta potencia, ejecuta de forma autónoma el cribado estructural, la predicción de propiedades MPA, cálculos de primeros principios y análisis retrosintético, controlando directamente la estación robótica de laboratorio húmedo para formular, sintetizar, purificar y medir | Opera durante 48 horas seguidas, criba 2.7 millones de moléculas candidatas y tras 4 iteraciones de ciclo cerrado obtiene muestras físicas verificadas experimentalmente de un nuevo líquido refrigerante |
| Planificación de recursos cloud (Alibaba Cloud + MindOpt) | Generación autónoma de algoritmos candidatos e iteración conjunta con el solver propio de Alibaba, MindOpt, para el enrutamiento multimodelo en etiquetado de datos, la asignación online de GPU y la replanificación offline de CPU | Reduce el coste medio de planificación en etiquetado de datos un 10.42%, aumenta un 4.62% el tiempo libre de nodos GPU completos online y multiplica por más de 14.61 la velocidad de resolución óptima en replanificación offline de CPU |
Todos estos casos corresponden a demostraciones seleccionadas por Alibaba y sus socios sin reproducción independiente por terceros hasta la fecha, por lo que los recortes de tiempo y factores de aceleración deben leerse como el techo alcanzable en un flujo de trabajo específico e integrado a medida.
Cuando se le pide generar una página estática a partir de una sola frase, las comparativas de la comunidad coinciden en que el acabado visual de Qwen4-Max queda un peldaño por debajo de los principales modelos de frontera: por ejemplo, en una prueba con el mismo prompt sobre el zodiaco chino frente a GPT-6 Astra y DeepSeek V4.1 Flash, la versión preliminar construyó una estructura completa, pero con iluminación y texturas más planas.
Para sacarle partido en desarrollo frontend e interfaces interactivas conviene detallar los criterios de aceptación dentro del prompt y refinar colores o animaciones en varias pasadas tras el primer borrador. Puedes añadir esta lista de comprobación al final de tus prompts:
Antes de entregar la página frontend, verifica punto por punto:1. Jerarquía visual: márgenes y espacios en blanco claros, contraste tipográfico y jerarquía de color definida; no entregues controles de formulario con el estilo por defecto del navegador.2. Interacción y estados: todos los botones, filtros, modales y formularios deben funcionar e incluir estados hover, de carga (loading) y de datos vacíos (Empty State).3. Repaso del punto más flojo: revisa el resultado completo antes de entregar, identifica la sección más débil en diseño o interacción y dedícale una pasada extra de pulido.4. Comprobación de renderizado: confirma que la página se renderiza íntegra, sin etiquetas sin cerrar, desbordamientos de diseño ni errores en la consola del navegador.A partir de las puntuaciones de benchmarks, los tiempos de respuesta y las facturas desglosadas más arriba, esta tabla resume qué hacer en cada tipo de carga de trabajo:
| Carga de trabajo / escenario | Recomendación | Motivo y contrapartidas |
|---|---|---|
| Agentes multiturno con contexto largo / análisis documental y due diligence | Recomendado | Admite 1M de contexto; lidera en ALE (46.7) y en el benchmark legal HLAB-Vals (21.3); el acierto de caché cuesta solo CNY 0.5/M en China continental ($0.075/M internacional) y el coste por tarea en Work360 baja un 62% ($1.67). En producción conviene activar caché explícita |
| Reparación de código en repositorios reales y desarrollo full-stack habitual | Válido ajustando el nivel de esfuerzo | Alcanza 75.7 en DeepSWE v1.1; deja el nivel predeterminado high para cambios cotidianos y sube a xhigh en tareas full-stack complejas o de línea de comandos (en Terminal-Bench hay 17 puntos de diferencia entre ambos niveles) |
| Ejecución intensiva en terminal / recreación de software de caja negra | Mejor optar por Claude o Kimi | Se queda en 48.5 en Terminal-Bench 4.0 (frente a 67.2 de Kimi K3.1 y 59.6 de Opus 5.5) y en 31.5 en ProgramBench (frente a 65.0 de Opus 5.5) |
| Máxima puntuación en el Intelligence Index controlando el gasto por tarea | Mejor mirar GPT-6.1 Sol | En Artificial Analysis, GPT-6.1 Sol (max) logra 55 puntos en el Intelligence Index a $1.27 por tarea, frente a los 43 puntos y $3.27 por tarea de Qwen4-Max |
| Generación de páginas frontend con un prompt corto | Exige lista de verificación e iteración | Va 6.º en CodeArena WebDev (1,750 ±15), pero en prompts de una sola frase entrega acabados más planos en luces y detalle; requiere especificar jerarquía visual, estados vacíos y pulir en varias rondas |
| Baja latencia al primer token o despliegue local | No recomendable | En AA tarda 147.63 s hasta el primer token de respuesta y 32.1 min de media por tarea; Max solo se ofrece mediante API propietaria y los modelos abiertos pequeños y medianos aún no tienen tamaños ni fecha de salida |
Sí. El plan por suscripción Token Plan de QwenCloud es compatible tanto con el protocolo de OpenAI como con Anthropic Messages, y su lista de herramientas admitidas oficialmente incluye Claude Code, Cursor, Qwen Code, Codex, Qoder y OpenClaw (la prueba de The Dark Factory comentada más arriba se ejecutó precisamente en Claude Code). Al conectarlo por la interfaz Anthropic Messages, el nivel de esfuerzo se envía mediante output_config.effort, donde medium se asigna a high y max a xhigh. Ten en cuenta que Token Plan utiliza un endpoint propio (token-plan.maas.qwencloudapi.com) y claves dedicadas con el prefijo sk-sp-, que no son intercambiables con las claves de pago por uso.
En China continental (Alibaba Cloud Model Studio), la tarifa estándar es de CNY 10 por millón de tokens de entrada, CNY 30 por millón de salida y CNY 0.5 por millón en aciertos de caché, además de una cuota gratuita de 1 millón de tokens válida durante 90 días para cuentas nuevas. En la plataforma internacional (QwenCloud, región de Singapur), la entrada estándar cuesta $1.5 por millón, la salida $4.5 por millón y el acierto de caché $0.075 por millón (el despliegue internacional dentro de Model Studio cuenta además con un tramo de CNY 10.938 / CNY 32.813). Al cambio actual ambas tarifas son muy parecidas; eso sí, la suscripción Token Plan solo se puede contratar y utilizar por ahora en la región de Singapur.
No. Qwen4-Max es un modelo propietario accesible únicamente a través de la API en la nube y de las aplicaciones oficiales de Qwen. En el artículo de presentación, el equipo de Qwen adelantó que más adelante liberarán como modelos de pesos abiertos las versiones pequeñas y medianas de la serie Qwen4 basadas en esta misma arquitectura y metodología de entrenamiento, aunque todavía no han anunciado el número de parámetros ni la fecha de lanzamiento.
CodingPass incluye modelos de Claude, GPT, Gemini y Qwen3.8 Flash, tarificados a precios oficiales de API. Sin cargos sorpresa, cancela cuando quieras.