谷歌用 Gemini 4 Carbon 把第一抢了回来
Carbon 的官方跑分和第三方评测、同价更费 token 的账,以及 12 月 1 日的涨价。
Krypton 为抠细节花掉 Carbon 5.7 倍的思考 token,灰度中的 GPT-6.2 Sol 传出追平第一、单任务只要 $1.19。两款新模型还没正式铺开,泡在模型里的测试者已经先把活儿拆开了:要深度的、跑日常的、写代码的,各归各家。
一张对比帖在开发者圈里传开了:谷歌的 Gemini 4 Krypton 和 OpenAI 的 GPT-6.2 Sol 被摆到同一张桌上,比谁更能干。
热闹看下来,真正值得琢磨的是另一件事:一群天天泡在模型里的测试者,已经按手头的活儿换起模型来了。要深度的交给一个,跑日常的交给另一个,写代码和编排再留给第三个。2026 年这一波密集发布,把“一款模型打天下”的念想冲得差不多了。
一句话:Krypton 肯烧 5 倍多的思考 token 死磕细节,GPT-6.2 Sol 主打追平第一但账单打到一折。不过两款都还在测试或灰度,网传的 Sol 跑分在 AA 官网也还查不到。眼下真能上手干活的,是已经上线的 Carbon、Argon、GPT-6.1 Sol 和 Opus 5.5——怎么按手头的活儿挑,直接看下面的实测账单。
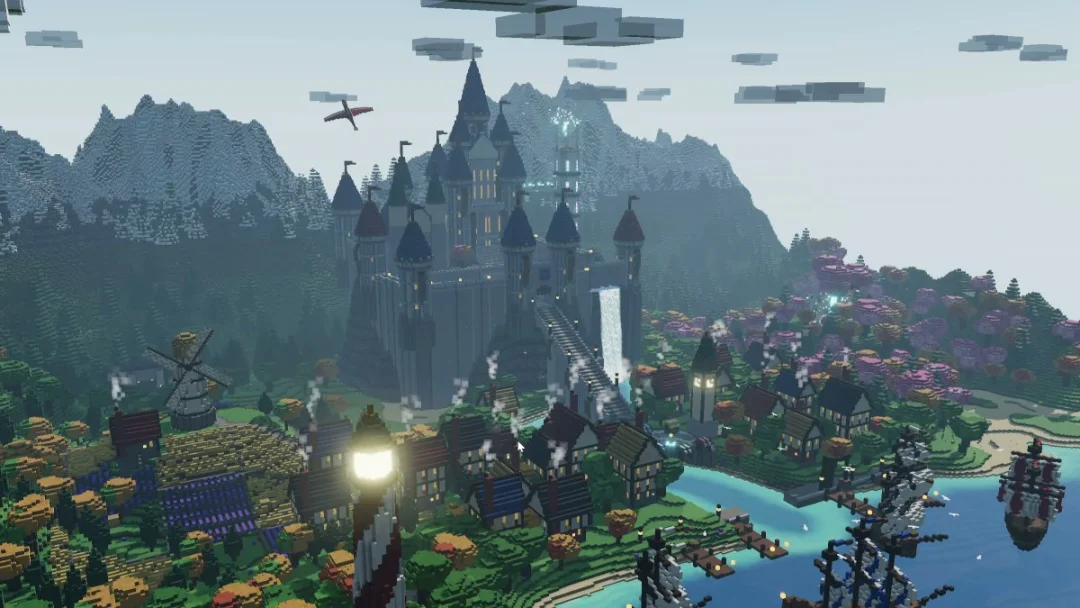
先说 Gemini 4 Krypton。它最出圈的是创意活:给它一句话,能搭出一整座体素小世界,港口、灯塔、樱花树、城堡、帆船一样不少,连水面和灯光都给你安排上。
Krypton(还是很早期的 checkpoint)、Carbon、Argon 三个模型的成片被并排摆了出来,每条四十多秒,画面里都是同款体素港口,细节密度一眼能比出高下。
 X · @lyraxanaGemini 4 Krypton vs Carbon vs Argon在 X 上观看
凭什么抠得这么细?靠的是肯烧思考 token。慢工出细活,模型愿意在落笔前一寸一寸地磨,连 SVG 画的手柄上那个 PlayStation 标志都不肯含糊。
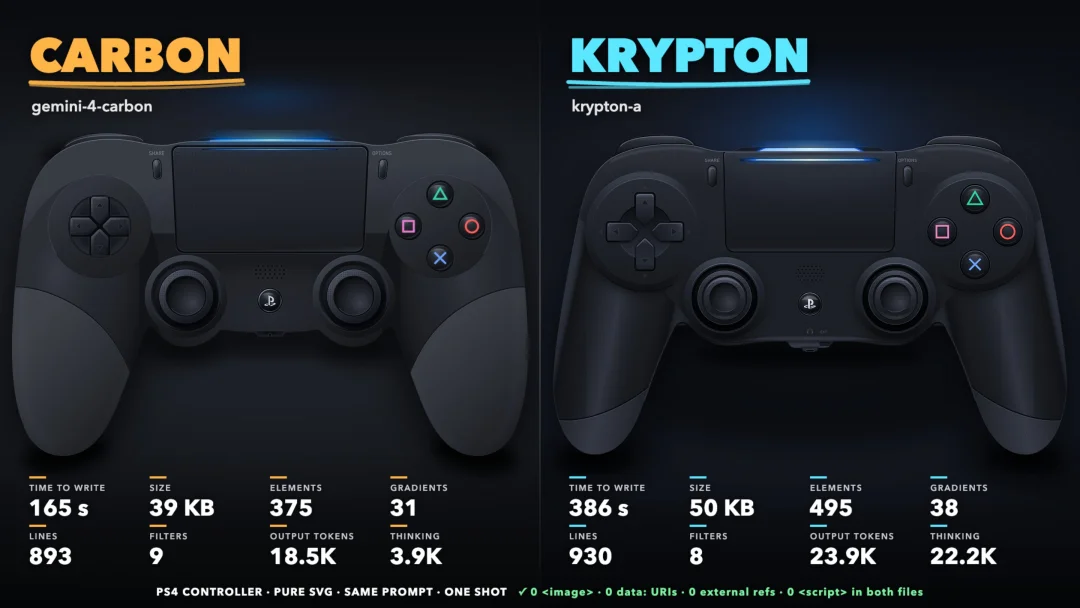
同一个提示词,Krypton 要多花一倍多的时间,换来的是谷歌目前细节最狠的一版,差距看手柄中间那个 PS 标志就知道了。
| 指标 | Gemini 4 Carbon | Krypton | Krypton / Carbon |
|---|---|---|---|
| 生成用时 | 165 秒 | 386 秒 | 2.3 倍 |
| 思考 token | 3.9K | 22.2K | 5.7 倍 |
| 输出 token | 18.5K | 23.9K | 1.3 倍 |
| 文件大小 | 39 KB | 50 KB | 1.3 倍 |
| 代码行数 | 893 | 930 | 1.04 倍 |
耗时翻倍,但最后写出来的代码行数只多了 4%,多出来的全是思考 token——足足是 Carbon 的 5.7 倍。每一处曲线和阴影的细节,都是落笔前硬想出来的,不是靠堆代码行数堆出来的。
这套靠烧思考换细节的路子,在 Gemini 4 家族里一脉相承。Krypton 画的 PS5 手柄矢量图也是同一个路数。谷歌 AI Studio 负责人 Logan Kilpatrick 也说:“Carbon 是个好模型,但团队还在继续往前推。”
代价也直白。有人在谷歌的 Antigravity 里让 Carbon 开高推理档,并行跑了大约 7 小时,周额度从 88% 掉到 23%,一口气吃掉六成多。
思考档位开得越高,成色越好,等待越久,账单上记的 token 也越多。这一条在后面几款模型身上还会反复出现。
再看 GPT-6.2 Sol。这几天社区里传得最凶的,是一张号称来自 Artificial Analysis(AA)的首轮评测截图:
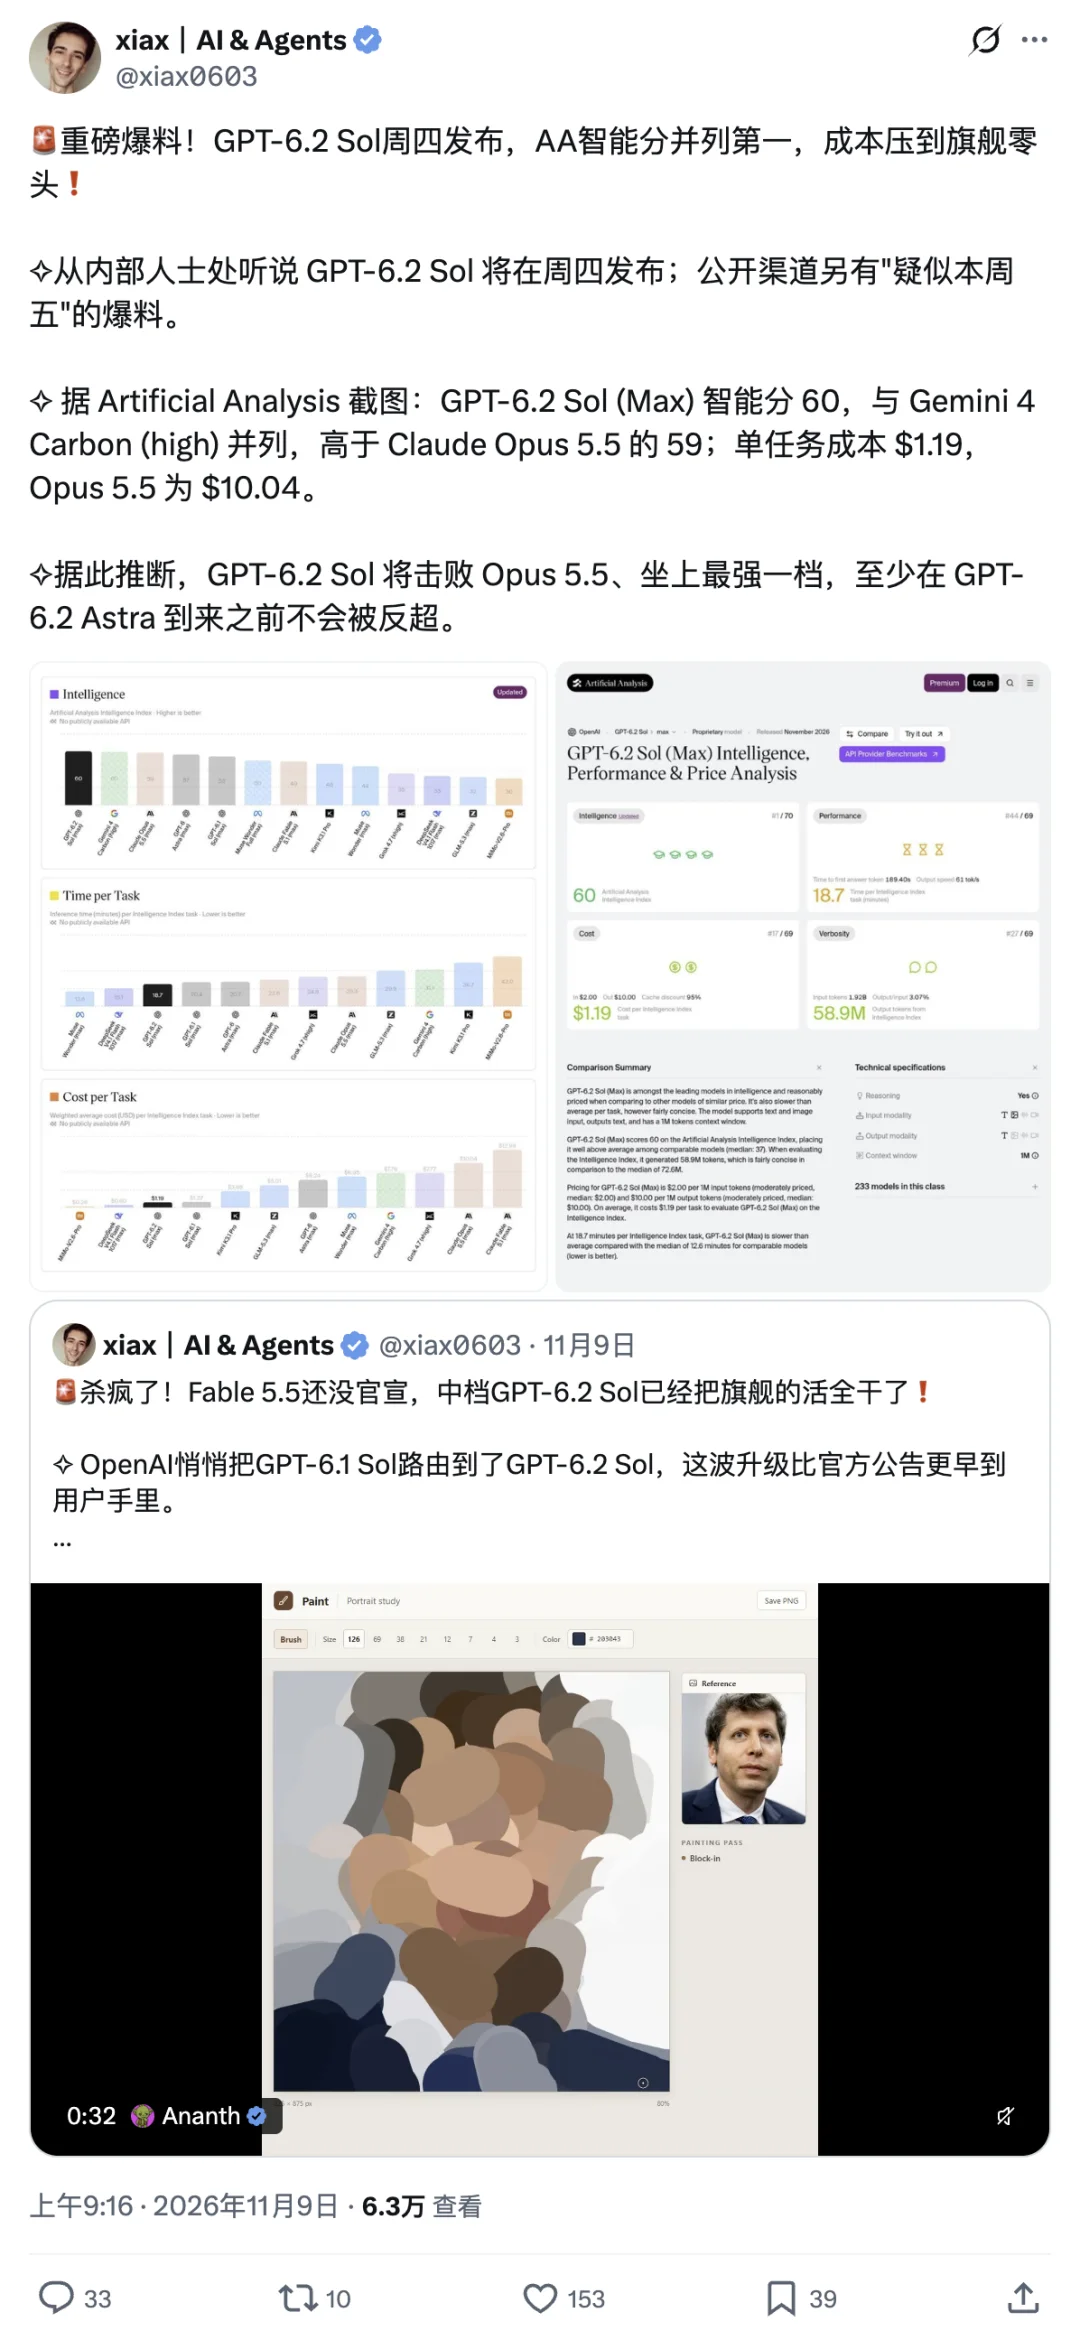
按图里的数字,Sol 智能指数拿到 60 分,追平谷歌 Gemini 4 Carbon 并列第一,略胜 Claude Opus 5.5(59 分),比上一代 GPT-6.1 Sol 高出整整 5 分,连自家的 GPT-6 Astra 也被反超——后来居上,成了头一款把 Opus 5.5 明确比下去的 OpenAI 模型。
工程和成本指标更夸张:复杂任务平均耗时压到 18.7 分钟,单任务成本只要 $1.19,约为 Opus 5.5($10.04)的八分之一。
不过先别急着当成定论。我们去 AA 官网和 OpenAI 文档核对了一圈,截至 11 月 12 日,AA 榜单上还没有 GPT-6.2 Sol,截图里的模型页链接也是 404。把网传数字和 AA 官网上已经上线的几款旗舰摆在一起,能看出不少门道:
| AA 指标 | GPT-6.2 Sol(流传截图) | GPT-6.1 Sol (max) | Claude Opus 5.5 (max) | Gemini 4 Carbon (high) |
|---|---|---|---|---|
| 智能指数 | 60 | 55 | 59 | 60 |
| 每项任务耗时 | 18.7 分钟 | 21.9 分钟 | 25.0 分钟 | 25.7 分钟 |
| 每项任务成本 | $1.19 | $1.27 | $10.04 | $7.76 |
| 跑完指数的输出 token | 5890 万 | 6370 万 | 2.18 亿 | 2.05 亿 |
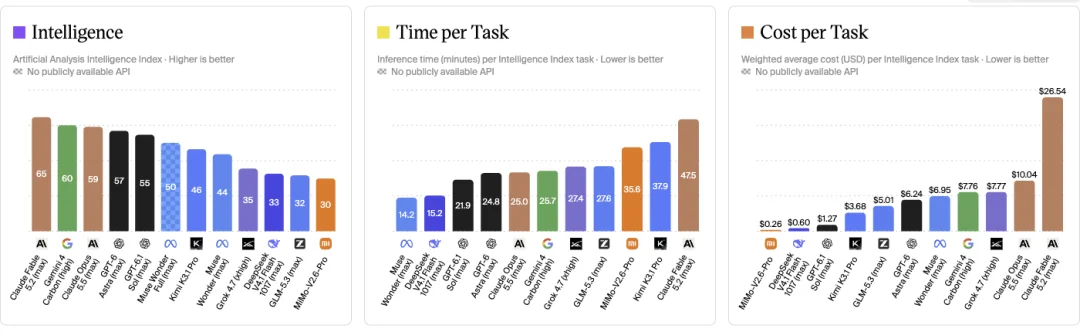
先看耗时。网传的 18.7 分钟比 Opus 5.5(25.0 分钟)和 Carbon(25.7 分钟)都快了四分之一左右,是这几款旗舰里最利索的。但有个前提得说清:AA 同档模型的耗时中位数是 12.8 分钟,它只是旗舰里跑得快,放到整个榜单并不算快。
真正把社区点着的是那笔 $1.19 的账单——只有 Opus 5.5 的八分之一、GPT-6 Astra($6.24)的五分之一。但对照上面的官方数据就能发现:便宜根本不是 6.2 才有的新本事。 早就上线的 GPT-6.1 Sol,单任务成本就是 $1.27,和网传的 $1.19 只差 8 美分。我们觉得,如果你冲着“一折平替”去,现在的 6.1 Sol 已经能拿来算账,不必干等 6.2。
Sol 的挂牌价并不特殊:GPT-6.1 Sol 每百万输入 token 收 $2、输出收 $10,上下文窗口 100 万 token,跟同类基本一个水平。压住账单的关键在“话少”:跑完整套智能指数,6.1 Sol 输出 6370 万 token,Opus 5.5 和 Carbon 都在 2 亿以上,答案比同行精简一截,单任务的花销才落得下来。
这里有个容易踩的坑:无论 OpenAI 还是谷歌,推理产生的思考 token 一律按输出价结算。思考上限要是不设,单次调用的花销能翻到普通问答的好几倍。
演示也跟着刷屏。一条提示词下去,被灰度到的 Sol 能吐出塞进单个 HTML 文件的完整 Three.js 立体画面,不靠 Blender、不挂外部素材,黑洞、帆船、斗兽场一类的画面直接能在浏览器里转起来,被拿来跟 Opus 5.5 同题硬碰。有人连着跑了 3 个小时,做了好几个 Three.js 演示,觉得比 Opus 5.5 好用。
真正让普通用户上心的,是订阅这笔账。对 Plus 用户来说,Sol 可能是这几年最大的一次升级:日常实用性盖过 Opus 5.5,连聊很久也不太烧额度,在 5 小时的用量窗口里都撑得住,20 美元的套餐终于又值了。
不过这类说法大多出自追踪发布前爆料的账号,用的还是将来时。看着很美,没正式发之前,我们觉得先打个问号更稳妥。
想确认自己有没有被灰度到,社区里流传一个土办法:选 GPT-6.1 Sol(开 Max 或 xhigh),关掉联网和记忆,问它知不知道刚出的 Claude Fable 5,答得上来就说明在新模型这一批里。被灰度到的人还提到一个讨喜的变化:回话一改过去那种句句留余地、先把自己摘干净的毛病,干脆了不少。
发布节奏也颇多烟雾弹。11 月 9 日,OpenAI 开发者账号放出一支只有 14 秒、写着“Tomorrow.”的短片,浏览量飙过 240 万,全网都以为新模型第二天要发:
 X · @OpenAIDevsTomorrow.在 X 上观看
结果第二天揭晓是个乌龙——预告指向的是 OpenAI 周边商店上架的一款 Game Boy 风格复古掌机(ModRetro Chromatic)。
至于传闻里“周四发布”的 GPT-6.2 Sol,直到 11 月 12 日(周四),OpenAI 的官方模型文档里依然不见踪影。
这些毕竟还是灰度期的小范围实测,跑分截图出处不明,等正式铺开、AA 自己跑完,还得再看一轮。
Krypton 之外,谷歌这一代常被拉出来比的还有 Carbon 和 Argon,两款的脾气差得挺远。
| 指标 | Gemini 4 Carbon (high) | Gemini 4 Argon (high) | 出处 |
|---|---|---|---|
| 智能指数 | 60 | 50 | AA |
| 输出速度 | 80 token/秒 | 65 token/秒 | AA |
| 首个答案 token | 67 秒 | 37 秒 | AA |
| 每项任务耗时 | 25.7 分钟 | 30.0 分钟 | AA |
| 幻觉率 | 11% | 4% | AA-Omniscience |
| Vibe Code Bench | 89.06% | 91.91% | Vals AI(OpenHands) |
| 上下文窗口 | 100 万 token | 100 万 token | 谷歌 |
| 每百万 token 输入 / 输出 | $2 / $10,12 月 1 日起 $4 / $20 | $2 / $10,12 月 1 日起 $4 / $20 | 谷歌定价页 |
Carbon 智能指数 60,100 万 token 上下文,长材料、网络安全、长时间自主任务是它的主场。短板也扎眼:高推理档下幻觉率 11%,首个答案 token 要等一分多钟。
Argon 分数低一档,智能指数 50,胜在稳:幻觉率压到 4%,轻量写代码的 Vibe Code Bench 拿到 91.91%,比 Carbon 的 89.06% 还高一点,也高过 Opus 5.5 的 90.29%;首个答案 token 只要 37 秒左右。
但要注意,Argon 只是“开口快”,整项任务跑完反而更慢:AA 上它单任务平均耗时 30 分钟,比 Carbon(25.7 分钟)还要多出 4 分多钟。
两款都挂着每百万 token 输入 $2、输出 $10 的尝鲜价,到 11 月 30 日为止,12 月 1 日起回到 $4 和 $20。Carbon 发布时只开放给一小批网络安全防御方,11 月 10 日起已经对所有付费开发者开放 API,但免费层两款都用不了。
慢,也是 Carbon 眼下被吐槽最多的地方。Theo(t3.gg)拿同一个编程任务实测,Opus 5.5 开 high 档 9 分 33 秒跑完,Carbon 开最低的 low 档足足磨了 22 分 21 秒。
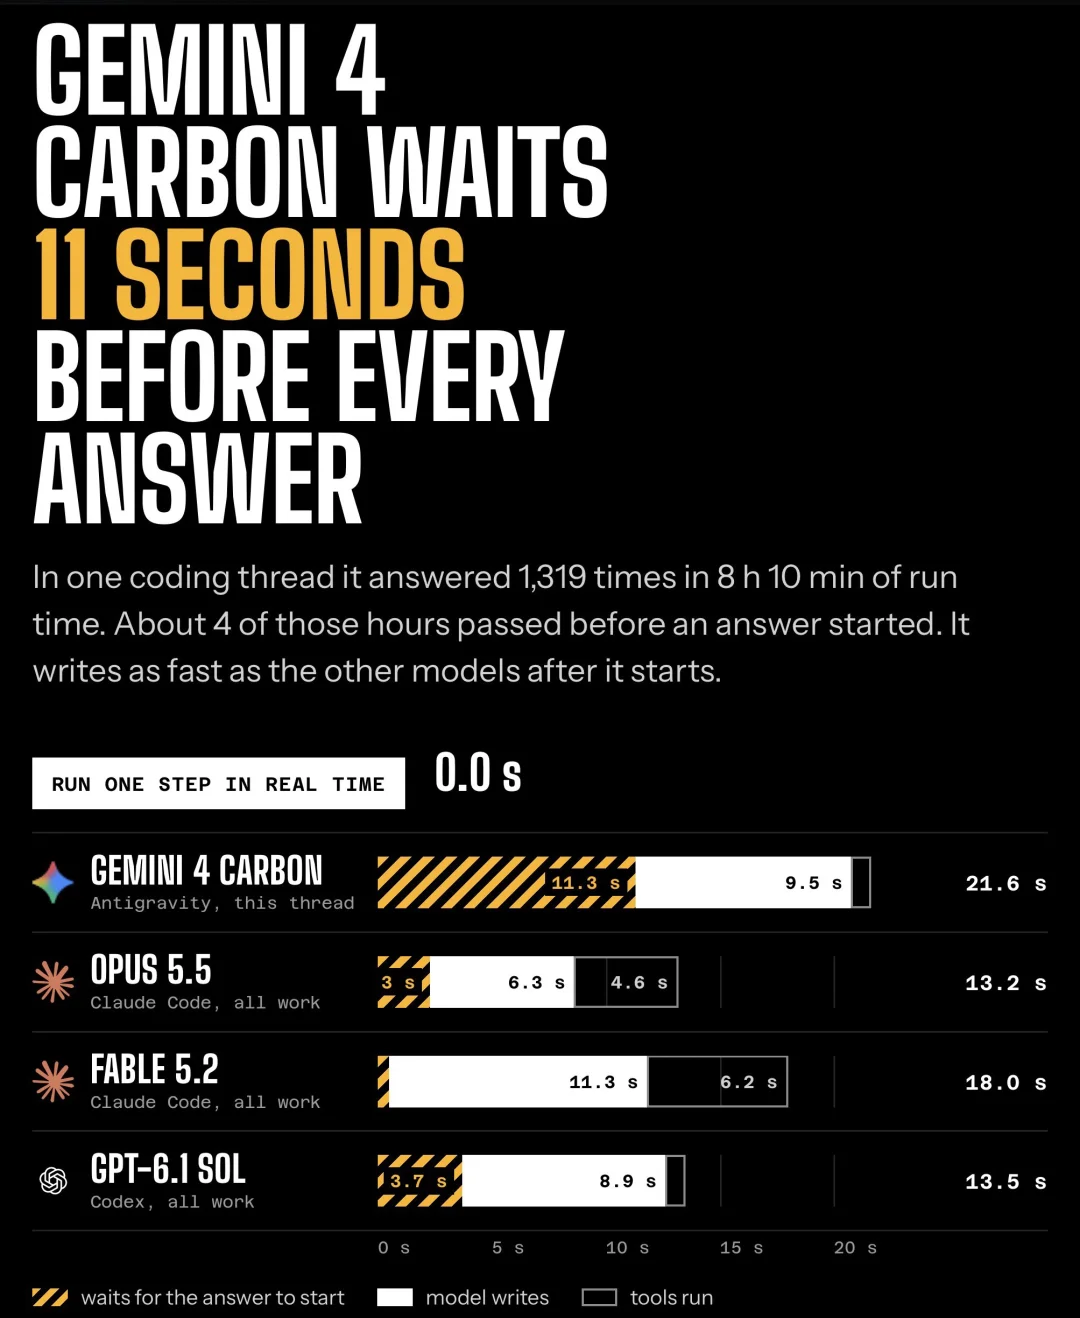
慢在哪儿,拆开一步看就清楚了:Carbon 每次开口前要干等 11 秒多,开口以后写得并不比别家慢。一条 8 小时 10 分钟的会话里它回了 1,319 次,约 4 个小时花在等它开口上。问题主要出在谷歌的服务端,不在模型本身。
除了慢,额度也紧。哪怕订了谷歌每月 200 美元的顶配套餐,分给满血 Gemini 4 的额度也少得可怜,一下就用完。技术领先,消费者那头却还没卖动。
有组数据值得单独摆一摆,都出自 AA 的智能指数口径:跑完整套指数,Carbon 输出 2.05 亿 token,Argon 1.13 亿,GPT-6.1 Sol 6370 万。同一张价目表,账单却不一样:按 AA 的算法,Argon 单任务 $9.95,Carbon $7.76,GPT-6.1 Sol $1.27。差别就在各家肯写多少、肯想多久,前面那笔思考账在这里又对上了一次。
看榜时还得留心模型名后面的小尾巴:AA 测 Carbon 和 Argon 开的是 high 档,测 Opus 5.5 和 Sol 开的是 max 档。各家跑分的档位和 harness 并不统一,横向差个一两分,别当成铁板钉钉的胜负。
量体裁衣,测试者手里那套分工说得最实在:
没有哪款在所有维度都占先。Sol 就算如传闻那样追平了 Carbon,任务耗时仍慢于同类中位数;Carbon 长任务强,却得忍长等待和偏高的幻觉;Argon 稳当,综合分数就低人家一档。至于 Opus 5.5,单价和单任务花销都比 Sol 高出一大截,在 AA 上连首个答案 token 都要等将近 6 分钟,贵且慢,但写代码的口碑依然最稳。榜单上差的一两分,落到自己手里的活儿上,体验完全是两回事。
Krypton 和 GPT-6.2 Sol 还在路上,但上面这套“按活儿分工”现在就能用已上线的四款模型跑起来。在 CodingPass 上,这几家共用同一个 Key,切模型只需要改一下模型 ID(各档位月额度见全部模型):
| 模型 | 模型 ID | 现在能用吗 | CodingPass 最低档位 |
|---|---|---|---|
| Gemini 4 Krypton | — | 谷歌内部测试中 | — |
| GPT-6.2 Sol | — | 少数账号灰度,未发布 | — |
| Gemini 4 Argon | gemini-4-argon | 已上线 | Go |
| Gemini 4 Carbon | gemini-4-carbon | 已上线 | Go |
| GPT-6.1 Sol | gpt-6.1-sol | 已上线 | Plus |
| Claude Opus 5.5 | claude-opus-5-5 | 已上线 | Plus |
给自己的活儿挑模型,先分清楚是“抠细节”还是“跑量”,再定思考档位,比盯着榜单那一两分管用。创意活把档位给足,让它慢慢磨;日常问答压低档位,别为一句寒暄烧一长串自我推演。账单和体验,往往就差在这个开关上。
2026 年这波发布,把挑工具的权利交回了用的人手里。与其干等一款全能王一统江湖,不如把手头的活拆开,哪款顺手就派哪款上。工具一多,会挑比会等更值钱。