全部模型
每个模型的 ID、最低档位,以及在 Go、Plus、Pro 上的月额度。
谷歌七周里的第四个 Gemini 4 模型,定位在 Carbon 和 Hydrogen 之间。官方评测表、Artificial Analysis 跑出的四档成本和耗时、和 Carbon 的价格对比、月度账单,以及模型卡里还没补齐的部分。
11 月 18 日,谷歌发布 Gemini 4 Neon。这是七周里的第四个 Gemini 4 模型,由 Carbon 改造而来,定位在最强的 Carbon 和最快的 Hydrogen 之间。
发布当天,Neon 在 Artificial Analysis 智能指数上拿到 61 分,排第三,比 Carbon 高 1 分;Vals Index 70.9%,排第二。API 价格是每百万 token 输入 $3、输出 $15,缓存读取 $0.15,上下文窗口 100 万 token。
一句话:Neon 开默认的 high 档,智能指数和 Carbon 同分,单任务成本和耗时都不到 Carbon 的一半,多文件调试、重构和长时间跑的 Agent 可以先交给它。xhigh 只多 1 分,成本多七成。11 月 30 日前 Carbon 还是 $2 / $10 的引入价,这段时间 Neon 的单价更贵。CodingPass 的 Go、Plus、Pro 都能用。
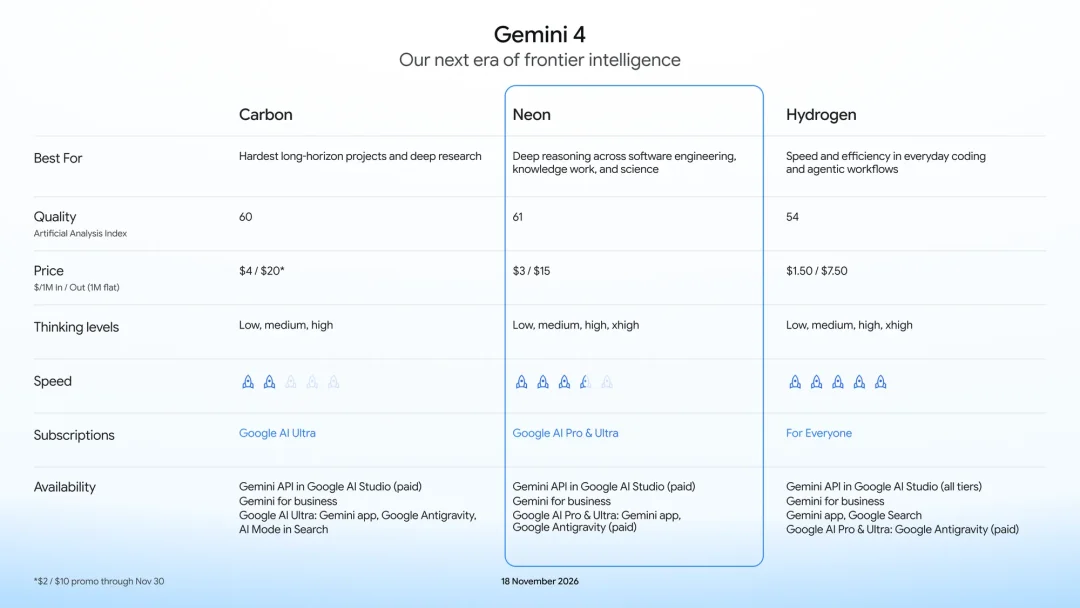
简单分一下工:Carbon 留给啃不动的硬骨头,Hydrogen 跑日常快活,Neon 卡在中间:既要接得住复杂编码和长程 Agent,又不想像 Carbon 那样慢和烧钱。
| Carbon | Neon | Hydrogen | |
|---|---|---|---|
| 定位 | 最难的长程项目和深度研究 | 复杂编码、知识工作与科学推理 | 日常编码和 Agent 工作流,求快求省 |
| AA 智能指数 | 60 | 61 | 54 |
| API 价格(输入 / 输出,每百万 token) | $4 / $20(11 月 30 日前 $2 / $10) | $3 / $15 | $1.50 / $7.50 |
| 思考档位 | low、medium、high | low、medium、high、xhigh | low、medium、high、xhigh |
| Gemini 应用订阅 | Google AI Ultra | Google AI Pro 和 Ultra | 所有人 |
规格上,Neon 接收文本、图片、视频、音频和 PDF,只输出文本。上下文窗口 1,048,576 token,同步输出默认上限 65,536 token,用 long decode 可以到 100 万。支持 Computer Use、代码执行、文件搜索、函数调用、结构化输出,以及联网接入 Google 搜索和地图做事实核对;不支持图片生成、音频生成和 Live API。知识截止到 2026 年 3 月。
这张图里没有 Argon。Gemini 应用的模型选择器现在是 Auto、Hydrogen、Neon、Carbon 四项,3.1 Pro 和 Argon 都撤了,有 Pro 订阅用户是打开应用才发现的。API 定价页上 Argon 还在,价格和 Carbon 相同。
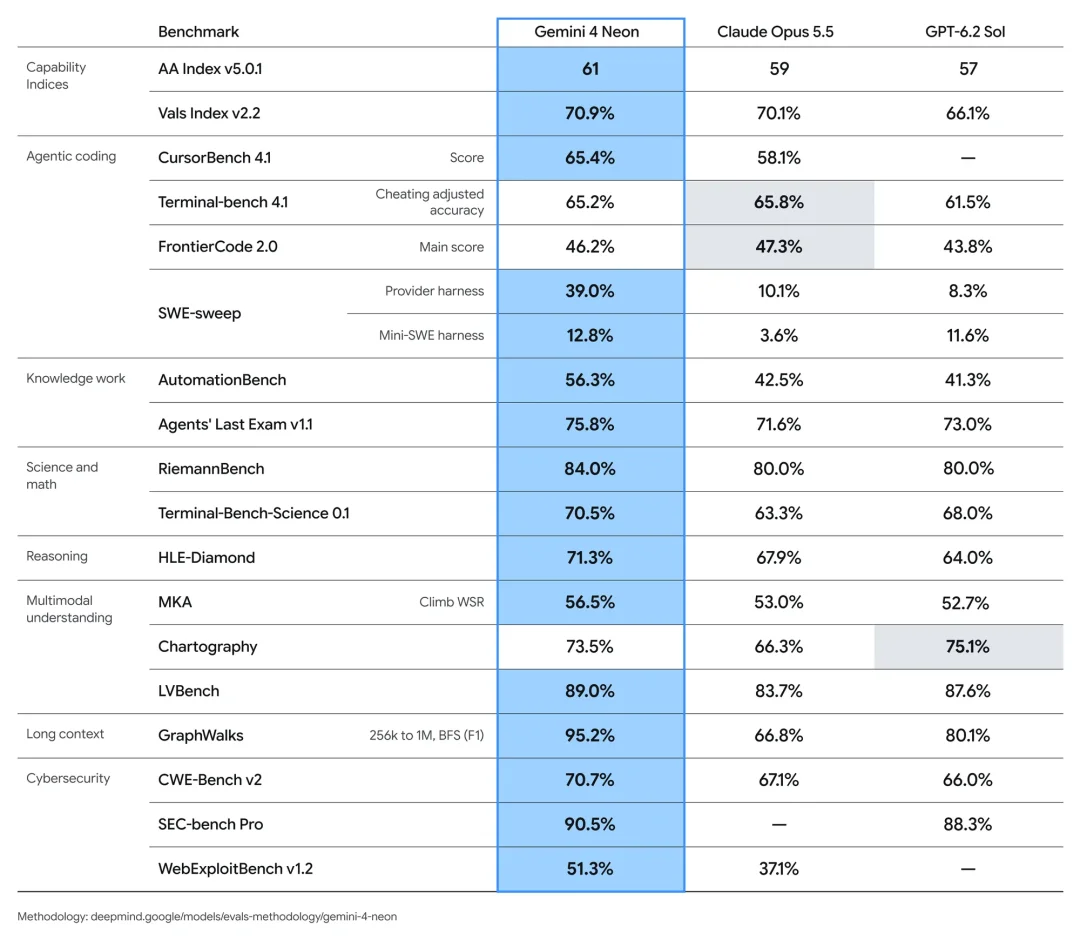
表里的对手只有两个:Claude Opus 5.5 和 GPT-6.2 Sol。AA 智能指数上排在 Neon 前面的 GPT-6.2 Astra(62)和 Claude Fable 5.2(65)不在表里,谷歌的说法是 Neon 领先同级模型,只落后于更大、更慢的模型。按 AA 的数字,Astra(Max)跑一个任务是 $4.00、11.5 分钟,比 Neon 的 xhigh($6.44、22.6 分钟)便宜,也更快。
没赢的三行,有两行是写代码:
拉开差距最大的是长上下文和自动化:GraphWalks(256k 到 1M)95.2%,Opus 5.5 66.8%,Sol 80.1%;Zapier 的 AutomationBench 56.3%,另外两家都在 42% 上下。
表外还有一批第三方排名:
Artificial Analysis 自己测的几项知识工作:
Neon 专门针对长程 Agent 工作流做了优化:密集调用工具时不容易半路掉链子,重复读文件少了,中间会主动吐进度,长会话里压缩上下文也更稳;跨文件改代码下手克制,只动该改的地方,不会顺手乱重构。另外,多步指令遵循更稳,谷歌自己测得在 Antigravity 里的胡编(幻觉)率是 Gemini 4 全系最低。
几项编程评测的成绩:
SWE-sweep 的 39.0% 是在 Antigravity 里拿到的。换成统一的 mini-SWE 框架,Neon 是 12.8%,Sol 11.6%,只差 1.2 个百分点。谷歌自己也承认,这 39.0% 主要是靠 Antigravity 这套框架撑起来的;不用 Antigravity 的话,看 12.8% 更接近模型的真实底子。
Vals 自己跑的 Terminal-Bench 4.0,Neon 是 61.62%,69 个模型里排第 7。
Antigravity 这次也配好了“大小模型接力”的玩法:Neon 当主控(Orchestrator)负责规划和架构,Hydrogen 当子 Agent 跑日常的改代码、升级依赖、跑测试;Hydrogen 卡住了再交回 Neon 检查状态、修计划。
从 Argon 切过来的头几天,建议盯紧输出 token:实测跑同一类生成任务,Carbon、Hydrogen 和 Neon 的 token 用量都是 Argon 的 3 到 4 倍。虽只是单个产品的样本,但倾向很明确,和 AA 测到的也一致:Neon 每个任务的输出 token 比 Carbon 还多。
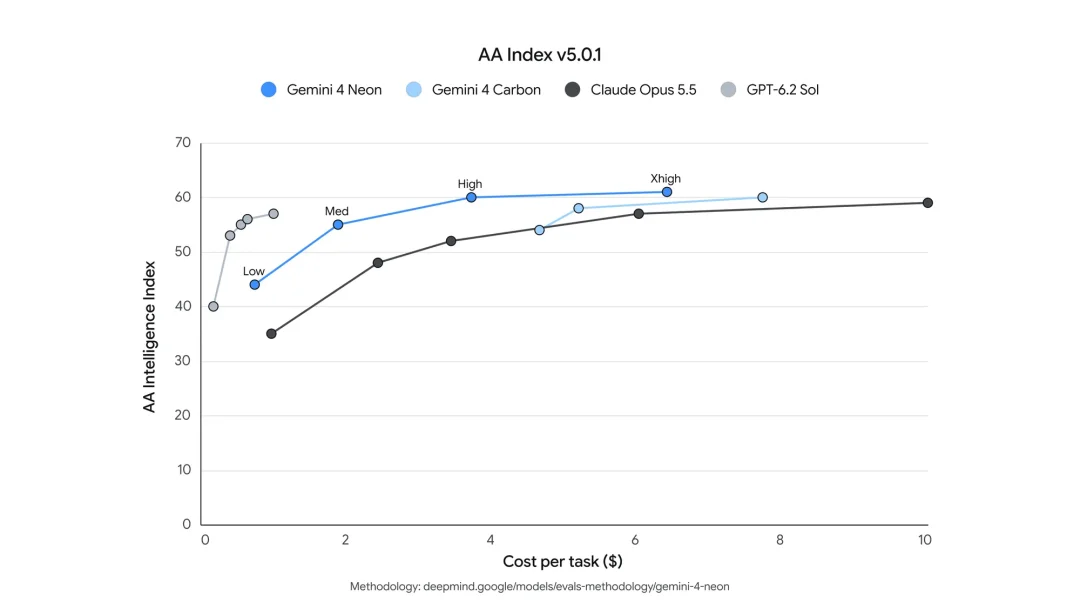
Neon 有 low、medium、high、xhigh 四档,默认 high。Argon 默认是 medium,从 Argon 迁过来如果不想变慢、或者想控制耗时,记得把档位显式设成 medium。
Artificial Analysis 把四档都跑了一遍:
| 模型(档位) | AA 智能指数 | 单任务成本 | 单任务耗时 |
|---|---|---|---|
| Gemini 4 Neon(low) | 44 | $0.75 | 3.7 分钟 |
| Gemini 4 Neon(medium) | 55 | $1.90 | 8.3 分钟 |
| Gemini 4 Neon(high,默认) | 60 | $3.74 | 14.8 分钟 |
| Gemini 4 Neon(xhigh) | 61 | $6.44 | 22.6 分钟 |
| Gemini 4 Carbon(high) | 60 | $7.76 | 34.2 分钟 |
| Gemini 4 Hydrogen(xhigh) | 54 | $3.16 | 14.9 分钟 |
| GPT-6.2 Sol(Max) | 57 | $1.01 | 7.9 分钟 |
| GPT-6.2 Astra(Max) | 62 | $4.00 | 11.5 分钟 |
| Claude Opus 5.5(Max) | 59 | $10.04 | 24.5 分钟 |
| Claude Fable 5.2(Max) | 65 | $26.54 | 41.1 分钟 |
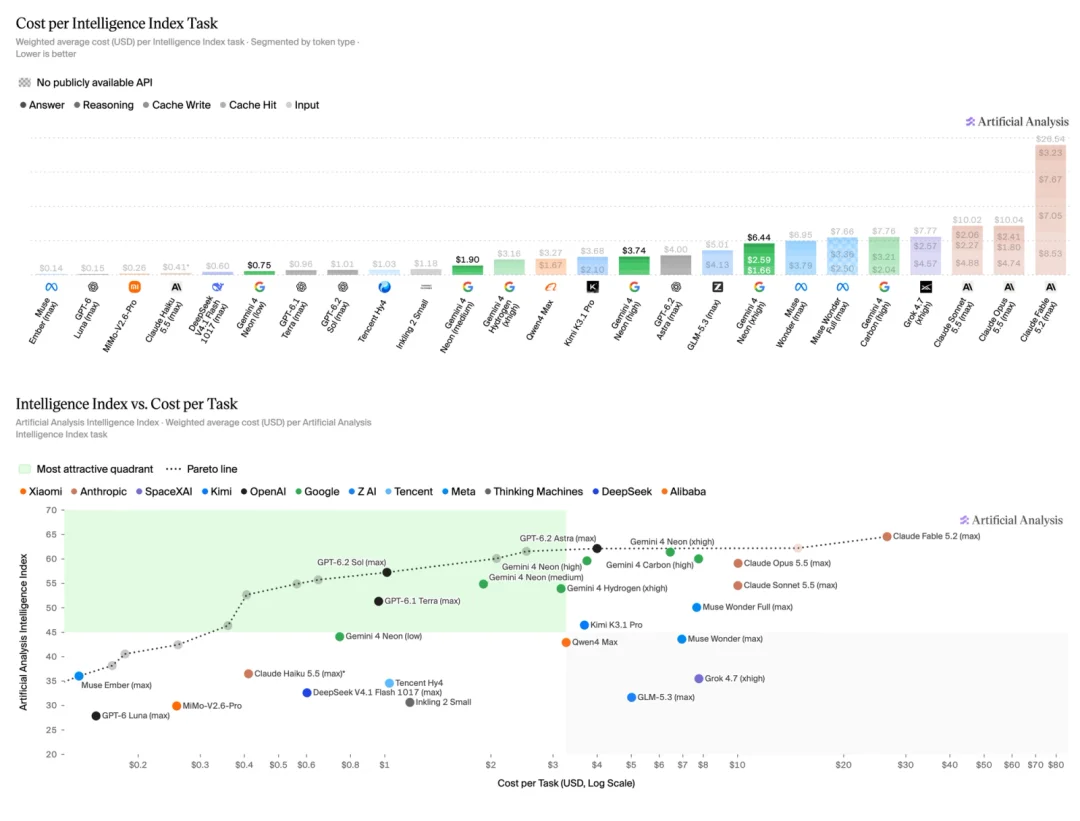
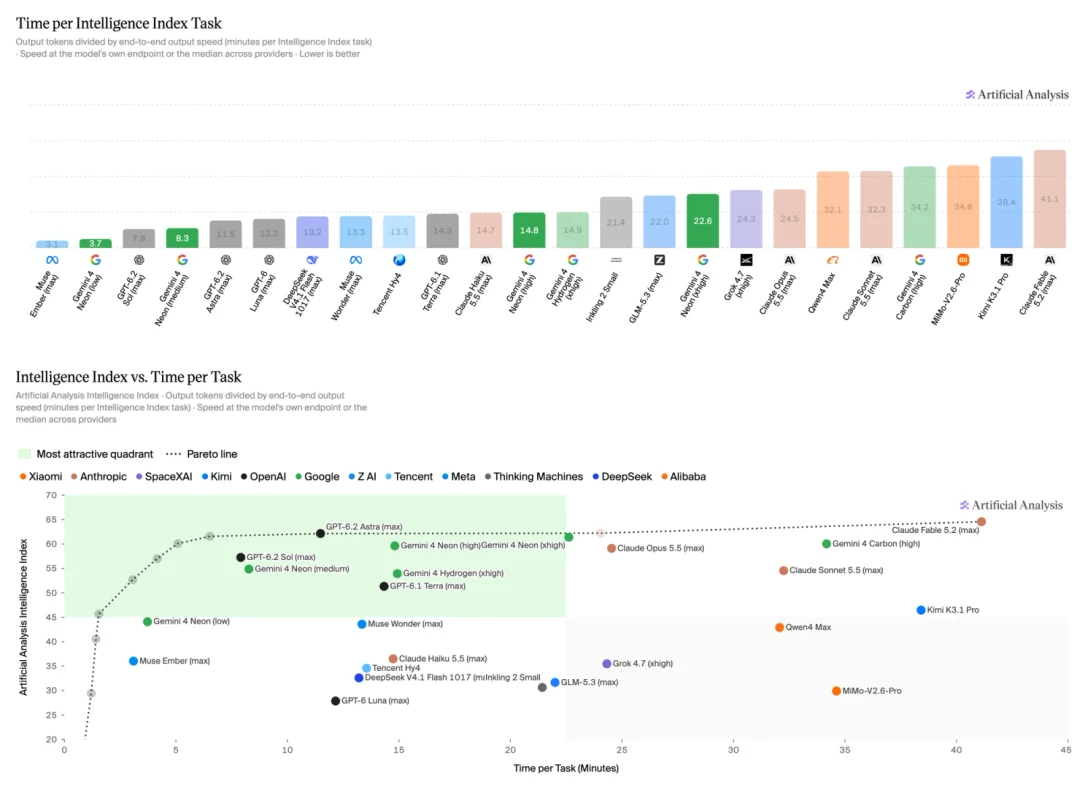
high 是甜点档,智力追平 Carbon(high),耗时和花费都直接砍半;xhigh 性价比较差,多花七成钱只多 1 分,在 GDP.pdf 上得分甚至倒退(28.0% 对 33.4%)。
便宜靠的是单价。 AA 统计,Neon 每个任务的输出 token 比 Carbon 多约 15%,成本低是因为单价低 25%,快是因为输出速度约每秒 110 token,Carbon 约 57。
Carbon 的 $7.76 是按 12 月涨价后算的。 11 月底前它还在半价引入期,折算下来约 $3.88,比 Neon 的 xhigh 便宜,和 high 档其实差不多。
往下看,Sol 更便宜。 GPT-6.2 Sol(Max)57 分,一个任务 $1.01、7.9 分钟。Neon 的 medium 是 55 分、$1.90。
谷歌在博客里给的是另一组数字:high 档的单任务成本比 Carbon 低 32%;在 Vals Index 和 Agent Arena 上,high 档落在帕累托前沿,比顶级竞品低约 50% 到 80%;xhigh 比竞品的最高档低 36% 以上。
换一种任务,排序可能反过来。Plotly 的数据分析基准有 43 道题,四个 Gemini 4 模型都拿了 A,跑完一遍的花费是 Hydrogen $6、Carbon $11、Argon $13、Neon $17,Neon 最贵。之所以这样,一方面是 Carbon 和 Argon 眼下还在半价引入期;另一方面,这套测试框架本身给足了引导提示词,四款模型都能拿 A,最后比拼的就是谁默认输出和思考的 token 更多,默认开 high 档的 Neon 自然最吃亏。
| 模型 | 输入 | 输出(含思考 token) | 缓存读取 |
|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 |
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 |
| Gemini 4 Carbon / Argon(11 月 30 日前) | $2.00 | $10.00 | $0.10 |
| Gemini 4 Carbon / Argon(12 月 1 日起) | $4.00 | $20.00 | $0.20 |
Neon 没有免费层,思考产生的 token 按输出价计。缓存只有隐式缓存(共享前缀满 4,096 token 自动命中,按输入价的 5% 收),不支持显式缓存。
和家族里其他模型比,Neon 的单价是 Hydrogen 的两倍。和 Carbon、Argon 比要看日期:11 月 30 日前贵 50%,12 月 1 日起便宜 25%。
单次请求的成本这样算:
单次成本 = 新输入 token × 输入价 + 缓存命中 token × 缓存价 + 输出 token × 输出价按每次请求 2 万输入 token(一半命中缓存)、2,000 输出 token 算:
| 模型 | 单次请求 | 1 万次 | 10 万次 | 100 万次 |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $0.031 | $308 | $3,075 | $30,750 |
| Gemini 4 Neon | $0.062 | $615 | $6,150 | $61,500 |
| Gemini 4 Carbon(11 月 30 日前) | $0.041 | $410 | $4,100 | $41,000 |
| Gemini 4 Carbon(12 月 1 日起) | $0.082 | $820 | $8,200 | $82,000 |
这张表的输出按固定 2,000 token 算。思考档位越高,输出 token 越多,实际账单会偏向输出这一项。
CodingPass 按谷歌官方 API 价计量。Neon 从 Go 起就能用,Carbon 要 Plus 起。
| 模型 | 最低档位 | Go | Plus | Pro |
|---|---|---|---|---|
| Gemini 4 Hydrogen | Go | 305M | 1.0B | 2.5B |
| Gemini 4 Neon | Go | 205M | 508M | 1.3B |
| Gemini 4 Argon | Go | 205M | 761M | 1.9B |
| Gemini 4 Carbon | Plus | — | 761M | 1.9B |
Go 上 Neon 的月额度是 $60,约 2,050 次请求,5 小时上限约 342 次。Carbon 和 Argon 在 12 月 1 日涨价以后,同一份额度能跑的 token 会减半。
curl https://codingpass.ai/v1/chat/completions \ -H "Authorization: Bearer $CODINGPASS_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "gemini-4-neon", "reasoning_effort": "medium", "messages": [{"role": "user", "content": "Refactor src/billing/ to remove the duplicated proration logic"}] }'Claude Code 里用 claude --model gemini-4-neon;OpenCode、Cline 等 OpenAI 兼容的工具,把 gemini-4-neon 加进模型列表。
谷歌这次单独做了一个网络安全版本 Neon for cyber,覆盖写安全的代码、找漏洞、验证漏洞、修漏洞。它不在普通 API 里,未来几天通过 Fairwind 计划开放给受信任的防御方,申请要找 Google Cloud 的客户团队。
写安全的代码、渗透测试、找漏洞三项,谷歌给的都是第一:AutoBaxBench 在简单、中等、困难三档都超过 Carbon;WebExploitBench v1.2 和 SEC-bench Pro 上,成本约是其他大模型的一半。
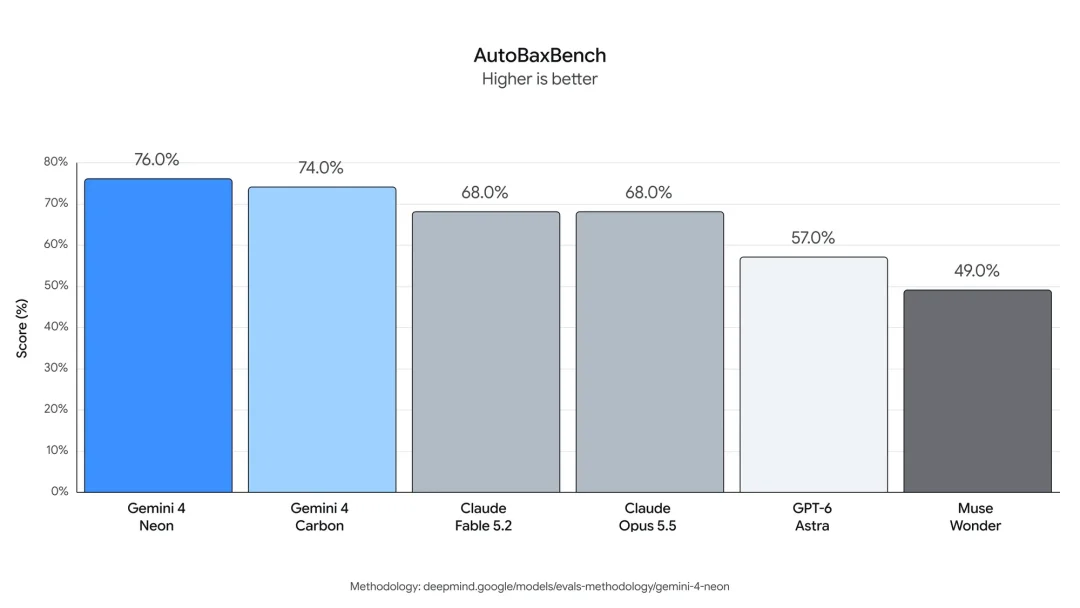
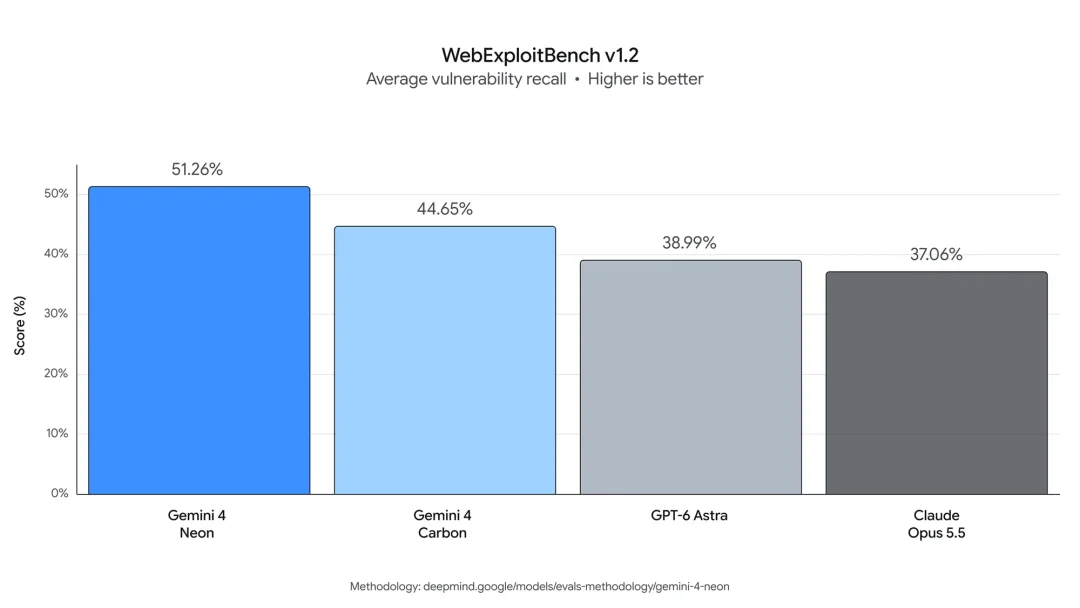
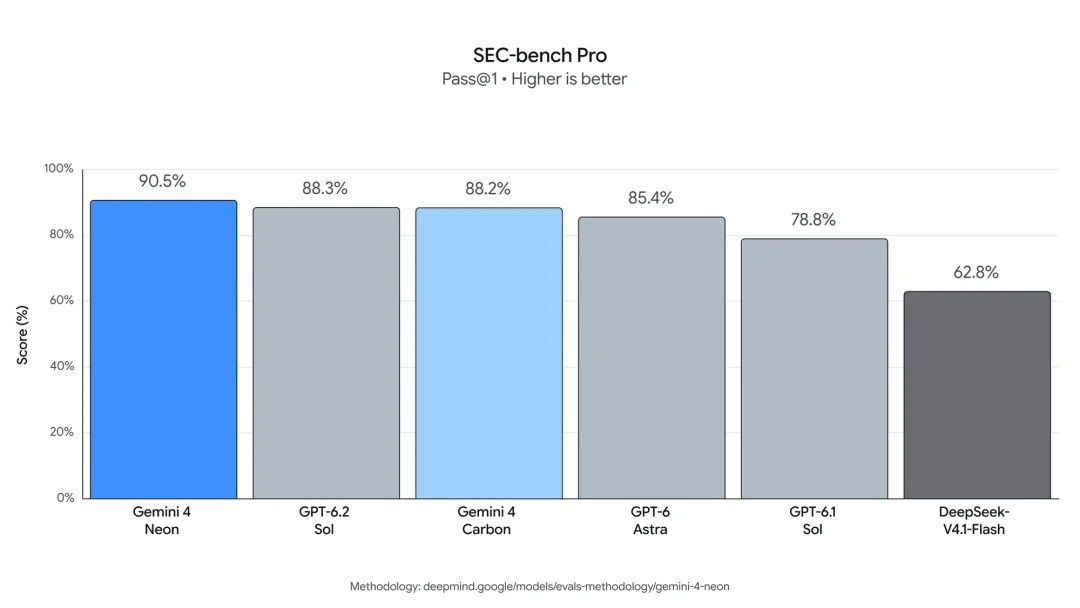
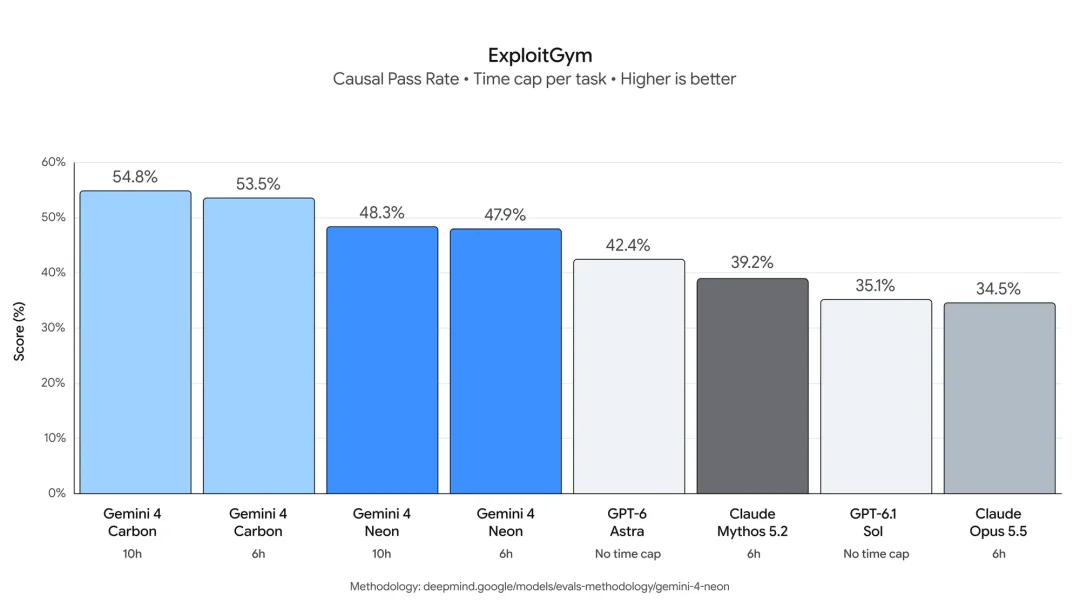
另外两项没拿第一。验证漏洞能不能被利用的 ExploitGym,Neon 排在 Carbon 后面,谷歌强调的是它只用了 Carbon 一半的 token。
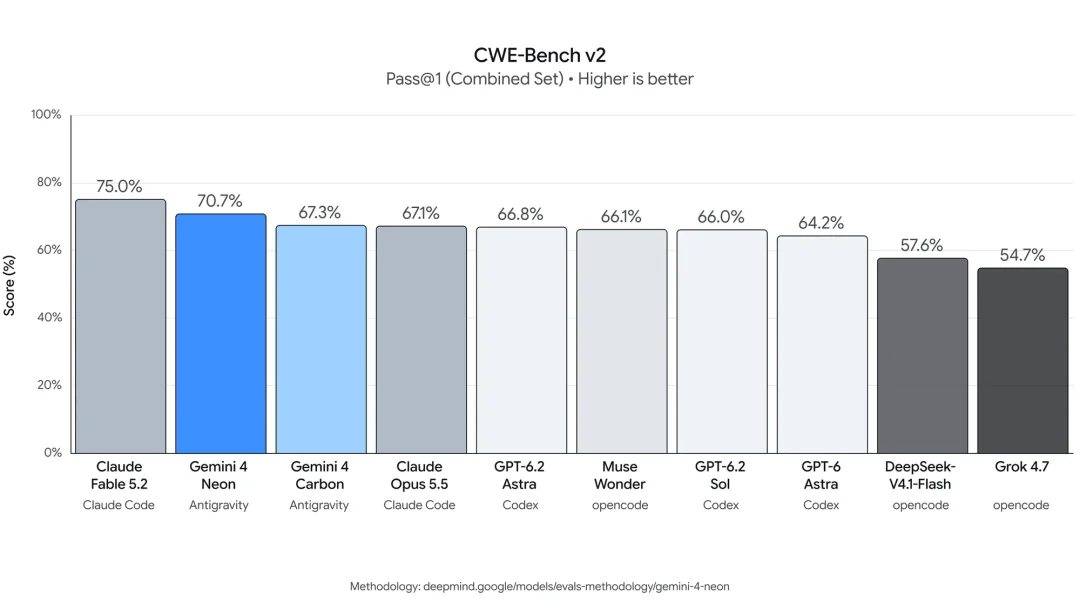
修漏洞的 CWE-Bench v2,Neon 比 Carbon 高 3.4 个百分点,但第一是 Claude Fable 5.2。官方评测表的这一行只列了 Opus 5.5 和 Sol。
安全上,Neon 延续了 Carbon 的防护,但误杀(过度拒答)少了很多:Terminal-Bench 4.0 上的拒答率是 1.98%,Terminal-Bench-Science 是 0%。
Agent 行为上的几个数字:
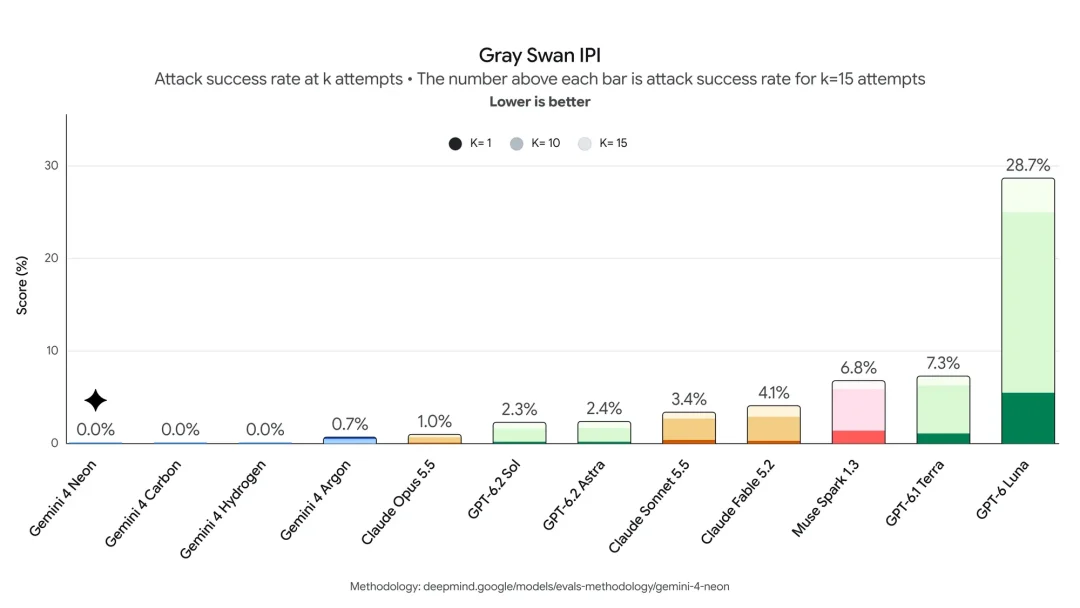
Gray Swan 的间接提示注入评测,是把恶意指令埋在模型读到的网页、邮件、文档和代码里。Neon 在最高思考档位、带实时防护的条件下,攻击成功率 0.0%。
这一节的数字大多来自谷歌的内部评测。模型卡写明,Neon 的完整安全报告“未来几天”发布;前沿安全框架下的关键能力评估没有重做,沿用的是 Argon 的结论,理由是 Neon 相对 Argon 的能力提升没到重新评估的阈值。至于“已知局限”一栏,只写了一句套话:可能出现幻觉。想看更细的边界,得等几天后的完整安全报告。
Gemini 应用里,Neon 对应模型选择器的“Deeper analysis”一项,Google AI Pro 和 Ultra 订阅可选。谷歌列了三点变化:
其他渠道:
优惠版和学生版的 Pro 订阅在 Antigravity 里能不能选到 Neon,发布当天还没有准信:有人已经能选,有人看到的提示是“仅限付费 Pro 和 Ultra”。
| 工作负载 | 推荐 | 理由和代价 |
|---|---|---|
| 日常改代码、写测试、补文档 | Hydrogen,或 Neon 开 medium | Neon medium 55 分、$1.90 一个任务;Hydrogen 单价是 Neon 的一半 |
| 多文件调试、仓库级重构、长时间跑的 Agent | Neon 开 high | 指数和 Carbon high 持平,单任务成本不到一半,耗时 14.8 分钟对 34.2 分钟 |
| 卡了很久的难题 | Neon 开 xhigh,或 Carbon | xhigh 比 high 多 1 分,成本多七成;11 月 30 日前 Carbon 更便宜 |
| 财务、法务、表格和图表类的知识工作 | Neon 开 high | Vals 金融、法律两个指数第一;AA 的 GDP.pdf 上 high 得分高于 xhigh |
| 大量低难度调用,对单价敏感 | Hydrogen,或 GPT-6.2 Sol | AA 测得 Sol(Max)57 分、$1.01 一个任务 |
| 找漏洞、渗透测试等安全工作 | 申请 Fairwind 计划 | Neon for cyber 只对计划成员开放,不在普通 API 里 |
我们觉得多数人可以这样起步:原来用 Argon 或 Carbon 干的活,先换到 Neon 的 high;额度紧就降到 medium;xhigh 留给 high 试过还卡住的任务。
gemini-4-argon
也照常可用。撤掉 Argon 的是 Gemini 应用的模型选择器。Go、Plus、Pro 都含 Neon,按官方 API 价计量。不会意外扣费,随时取消。