Gemini 4 Neon: 61 im AA Index, $3 / $15
Offizielle Benchmarks, Kosten und Dauer pro Aufgabe nach Thinking-Stufe sowie Monatsrechnungen.
Vier Releases in sieben Wochen verteilen Gemini 4 auf vier feste Punkte der Kurve aus Intelligenz, Latenz und Preis. Ein direkter Vergleich von Carbon, Neon, Hydrogen und Argon bei Benchmarks, Aufgabenkosten und Coding-Workloads.
Innerhalb von sieben Wochen im Herbst 2026 hat Google vier Gemini-4-Modelle veröffentlicht: Argon, Carbon, Hydrogen und Neon. Statt einer einfachen Abstufung von klein bis groß besetzt jedes Element einen eigenen Punkt auf der Kurve aus Leistung, Latenz und API-Preis.
Alle vier teilen sich ein Kontextfenster von 1 Million Token und native multimodale Eingabe (Text, Bild, Video, Audio, PDF), unterscheiden sich aber deutlich bei Benchmark-Spitzenwerten, Ausgabetempo, Thinking-Stufen und Token-Kosten.
Kurzfassung: Für komplexes Coding und produktive Agents ist Gemini 4 Neon der sinnvollste Standard (high erreicht 60 Punkte im AA Intelligence Index bei weniger als der halben Zeit und den halben Kosten von Carbon). Hohe Aufruffrequenzen und Subagents gehören zu Hydrogen (~140 Token/s zum halben Preis von Neon). Carbon und Argon behalten ihren Einführungspreis von $2 / $10 nur bis zum 30. November; ab der Verdopplung auf $4 / $20 am 1. Dezember lohnt sich Carbon nur noch für die härtesten Langzeit-Aufgaben.
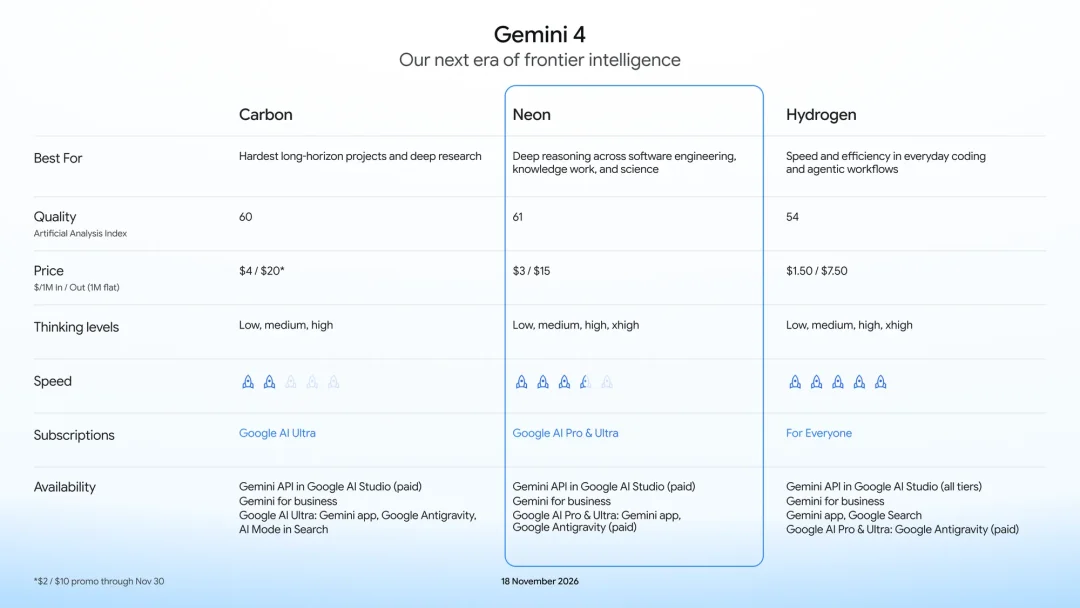
Nimmt man Argon wieder in dieselbe Übersicht auf, wird die Aufteilung der gesamten Serie klar:
| Merkmal | Carbon | Neon | Hydrogen | Argon |
|---|---|---|---|---|
| Schwerpunkt | Härteste Langzeit-Projekte & Deep Research | Komplexes Coding, Wissensarbeit & Wissenschaft | Schnelles, günstiges Coding & Subagents | Frühe Basislinie & allgemeine Automatisierung |
| AA Intelligence Index (Max) | 60 (high) | 61 (xhigh) / 60 (high Standard) | 54 (xhigh) / 51 (high) | 50 (high) / 48 (medium) |
| Ausgabetempo (ca.) | 57 Token/s | 110 Token/s | 140 Token/s | Mittel bis langsam |
| Thinking-Stufen | low, medium, high | low, medium, high (Standard), xhigh | low, medium, high, xhigh | low, medium (Standard), high |
| Kontextfenster | 1M Token | 1M Token | 1M Token | 1M Token |
| API Input / Output (pro 1M) | $4 / $20 ($2 / $10 bis 30. Nov.) | $3 / $15 | $1.50 / $7.50 | $4 / $20 ($2 / $10 bis 30. Nov.) |
| Cached Input (pro 1M) | $0.20 ($0.10 bis 30. Nov.) | $0.15 | $0.075 | $0.20 ($0.10 bis 30. Nov.) |
| Mindesttarif bei CodingPass | Plus | Go | Go | Go |
Ein Detail zur Verfügbarkeit: Google hat Argon aus der Modellauswahl der Gemini-App gestrichen (dort stehen nur noch Auto, Hydrogen, Neon und Carbon), auf der API-Preisseite und bei CodingPass bleibt gemini-4-argon aber weiterhin aktiv.
Gemini 4 Krypton, von dem auf X bereits SVG- und Video-Demos kursieren, ist bislang nur ein unveröffentlichter Test-Checkpoint ohne offizielle API-Preise oder vollständige Benchmarks und bleibt hier außen vor.
Die vier Modelle trennen sich vor allem bei drei Kriterien: Zuverlässigkeit in Terminal-Agents, Abruf über 1 Million Token Kontext und Thinking-Token pro Aufgabe.
| Benchmark | Carbon | Neon | Hydrogen | Argon |
|---|---|---|---|---|
| AA Intelligence Index | 60 | 60 (high) / 61 (xhigh) | 51 (high) / 54 (xhigh) | 50 (high) |
| Terminal-Bench 4.0 / 4.1 | 65.2% (4.0) | 65.2% (4.1) / 61.62% (Vals 4.0) | 54.04% (4.0) | ~57.2% (4.0) |
| GraphWalks (256k–1M) | 96.2% | 95.2% | — | 84.2% |
| Agent Arena | +16.2% (Platz 2) | 1336 Elo (Platz 2) | — | +11.0% (Platz 7) |
| AA Kosten pro Aufgabe | $7.76 (Dez.-Preis) | $3.74 (high) / $6.44 (xhigh) | $3.16 (xhigh) | Über Median |
| AA Dauer pro Aufgabe | 34.2 Min. (früher 25.6 Min.) | 14.8 Min. (high) / 22.6 Min. (xhigh) | 14.9 Min. (xhigh) | Langsamer |
Carbon ist für tiefes Reasoning gedacht, bei dem langes Ausprobieren wichtiger ist als Tempo. Bei GraphWalks (256k–1M) liegt es mit 96.2% vorn und führt in der Agent Arena bei Kurskorrekturen, wenn Nutzer mitten in der Sitzung widersprechen oder Anforderungen ändern.
Der Preis dafür ist enormer Token-Verbrauch: Für die komplette AA-Intelligence-Index-Suite gab Carbon 205 Millionen Token aus (Median der Vergleichsgruppe: 72,8 Millionen) und brauchte bei rund 57 Token/s im Schnitt 25,6 bis 34,2 Minuten pro Aufgabe.
Neon wurde aus Carbon abgeleitet, trifft im Alltag aber den besseren Kompromiss. Auf der Standardstufe high zieht es im AA Intelligence Index mit Carbon gleich (60 Punkte), halbiert die Laufzeit auf 14,8 Minuten und drückt die Aufgabenkosten auf $3.74 statt $7.76 (nach Dezember-Preis).
In mehreren Fachdisziplinen schlägt Neon sogar Carbon:
Hydrogen stammt ebenfalls von Carbon ab, liefert rund 140 Token/s und kostet pro Token genau die Hälfte von Neon ($1.50 / $7.50). Auf xhigh erreicht Hydrogen 54 Punkte im AA Intelligence Index und überholt damit das ältere Argon (50 Punkte).
Im Orchestrator-Modus von Google Antigravity plant Carbon oder Neon die Architektur, während Hydrogen Dateiänderungen, Dependency-Updates und Testläufe übernimmt. Auf Terminal-Bench erreicht dieses Gespann nahezu Carbon-Erfolgsraten – bei rund 19% kürzerer Laufzeit und etwa 24% weniger Kontingentverbrauch.
Argon startete als erstes Modell der Reihe mit starkem Langkontext-Abruf (84.2% bei GraphWalks) und nativem Multimodal-Streaming. Seit Hydrogen und Neon verfügbar sind, fehlt Argon die klare Nische: Im Intelligence Index (50) liegt es hinter Hydrogen (high 51 / xhigh 54), und nach der Preiserhöhung auf $4 / $20 am 1. Dezember wird es pro Token teurer als Neon ($3 / $15). Solange keine bestehenden Prompts fest auf Argons medium-Standard abgestimmt sind, gibt es für neue Projekte kaum einen Grund dafür.
Neon und Hydrogen bieten vier Thinking-Stufen (low, medium, high, xhigh), Carbon und Argon drei (low, medium, high). Wichtig beim Umstieg: Argon nutzt standardmäßig medium, Carbon und Neon dagegen high. Wer ohne explizites reasoning_effort: "medium" von Argon auf Neon wechselt, sieht sofort deutlich mehr Output-Token.
Bei 20.000 Input-Token pro Anfrage (50% impliziter Cache-Treffer zu 5% des Input-Preises) und 2.000 Output-Token ergeben sich folgende Monatskosten:
| Modell | Pro Anfrage | 10K Anfragen | 100K Anfragen | 1M Anfragen |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $0.031 | $308 | $3,075 | $30,750 |
| Gemini 4 Neon | $0.062 | $615 | $6,150 | $61,500 |
| Carbon / Argon (bis 30. Nov.) | $0.041 | $410 | $4,100 | $41,000 |
| Carbon / Argon (ab 1. Dez.) | $0.082 | $820 | $8,200 | $82,000 |
Vier Einschränkungen solltest du bei der Einordnung der Zahlen mitdenken:
mini-SWE-Harness fällt Neon auf 12.8% zurück – nur noch 1.2 Prozentpunkte vor GPT-6.2 Sol (11.6%).xhigh lohnt sich selten: Der Sprung von high auf xhigh bringt 1 Punkt im Intelligence Index (60 auf 61), erhöht die Kosten pro Aufgabe aber um 72% ($3.74 auf $6.44), dauert fast 8 Minuten länger und verschlechtert sich bei GDP.pdf (33.4% auf 28.0%).high auch bei klar geführten Aufgaben ausführlich nachdenkt.CodingPass rechnet alle vier Gemini-4-Modelle zu den offiziellen Google-API-Preisen ab. Hydrogen, Neon und Argon sind ab Go enthalten, Carbon ab Plus:
| Modell | Mindesttarif | Go | Plus | Pro |
|---|---|---|---|---|
| Gemini 4 Hydrogen | Go | 305M | 1.0B | 2.5B |
| Gemini 4 Neon | Go | 205M | 508M | 1.3B |
| Gemini 4 Argon | Go | 205M | 761M | 1.9B |
| Gemini 4 Carbon | Plus | — | 761M | 1.9B |
Mit einem einzigen Key wechselst du pro Request das Modell und steuerst die Denktiefe über reasoning_effort:
curl https://codingpass.ai/v1/chat/completions \ -H "Authorization: Bearer $CODINGPASS_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "gemini-4-neon", "reasoning_effort": "medium", "messages": [{"role": "user", "content": "Review the diff in src/billing/ for race conditions"}] }'| Workload | Empfehlung | Begründung und Kompromiss |
|---|---|---|
| Kleine Änderungen, Unit-Tests, häufige Subagents | Hydrogen (medium / high) | ~140 Token/s zum halben Neon-Preis; kein unnötiges Thinking |
| Multi-File-Refactoring, Debugging, Haupt-Agent | Neon (high Standard) | Gleicher AA-Wert wie Carbon in weniger als der halben Zeit und zu halben Kosten |
| Finanz-, Rechts- und Tabellenanalyse | Neon (high) | Platz 1 bei Vals Finance & Legal; kein xhigh wählen, da Dokumentenlesen abfällt |
| Festgefahrene Architekturfehler, 1M-Token-Audits | Carbon (high) oder Neon (xhigh) | 96.2% bei GraphWalks; 30+ Minuten Laufzeit und höherer Token-Bedarf einplanen |
| Bestehende Argon-Pipelines | Wechsel zu Neon (medium) | Argon ist ab 1. Dez. teurer und langsamer; medium hält Output-Token stabil |
Für die meisten Teams ist Neon (medium oder high) der beste Standard, Hydrogen übernimmt schnelle Subagent-Schleifen und Carbon bleibt für Fälle reserviert, an denen Neon zweimal hintereinander scheitert.
high) ist das stärkste Hauptmodell fürs Coding: Platz 1 im AA Coding Agent Index und mehr als doppelt so schnell wie Carbon. Für kleine Edits und Testläufe ergänzt Hydrogen es optimal.reasoning_effort explizit auf medium. Argon nutzt standardmäßig medium, Neon dagegen high – ohne Anpassung steigen Output-Token und Latenz spürbar an.Go, Plus und Pro rechnen zu offiziellen API-Preisen ab. Keine versteckten Kosten, jederzeit kündbar.