Alle Modelle
Die ID jedes Modells, der Mindesttarif und das Monatskontingent in Go, Plus und Pro.
Alibaba bringt sein proprietäres Flaggschiff Qwen4-Max: 2,4 Billionen Parameter bei 71 Milliarden aktiven pro Token, vier Bestwerte in 16 offiziellen Benchmarks und Cache-Hits ab $0.075 (CNY 0.5 in Festlandchina) pro Million Token. Hier sind die offiziellen und unabhängigen Testergebnisse, die API-Preise für China und international, zwei durchgerechnete Agent-Läufe sowie die passenden Reasoning-Stufen pro Aufgabe.
Am 16. November hat Alibaba sein neues Flaggschiff-Modell Qwen4-Max vorgestellt. Es basiert auf der neuen Mixture-of-Experts-Architektur (MoE) der Qwen4-Generation mit 2,4 Billionen Backbone-Parametern, von denen pro Token 71 Milliarden aktiviert werden, ergänzt um 328 Milliarden N-gram-Embedding-Parameter. Das Modell verarbeitet ein Kontextfenster von 1 Million Token sowie native Bildeingaben und wird ausschließlich über Cloud-APIs und Alibabas eigene Anwendungen angeboten.
Eine Woche vor dem Start tauchte bereits eine frühe Vorabversion als anonymes Testmodell in der Programmier-IDE Qoder auf und wurde kurz darauf als Qwen4-Max-Preview enthüllt. Am 16. November folgten die vollständigen Benchmarks, Details zur Architektur und die API-Preisliste. Dieser Artikel fasst die offiziellen Messwerte, unabhängigen Ranglisten, Preise und echten Abrechnungen aus der Community zusammen.
Kurz gesagt: Qwen4-Max punktet bei langlaufenden Agent-Aufgaben, Repository-weiten Code-Reparaturen (DeepSWE 75.7) und sehr günstigen Cache-Hits (CNY 0.5 pro Million Token in Festlandchina, international $0.075 pro Million; die Kosten pro Aufgabe auf Work360 sinken gegenüber dem Vorgänger um 62%). Schwächen zeigt es bei Terminal-Befehlen (Terminal-Bench 4.0 mit 48.5), beim Blackbox-Nachbau von Software (ProgramBench mit 31.5) und beim Tempo auf hoher Reasoning-Stufe (im Schnitt 32.1 Minuten pro Aufgabe bei Artificial Analysis). Damit eignet es sich vor allem für Engineering- und Dokumenten-Workflows mit langem Kontext und vielen Iterationen. Im Alltag reicht die Standardstufe high, für komplexe Full-Stack- und Terminal-Aufgaben solltest du auf xhigh hochschalten.
Um den Rechenaufwand bei langen Sequenzen zu drücken und pro Schritt weniger Parameter zu aktivieren, baut Qwen4-Max die Sparse-MoE-Architektur an drei Stellen um:
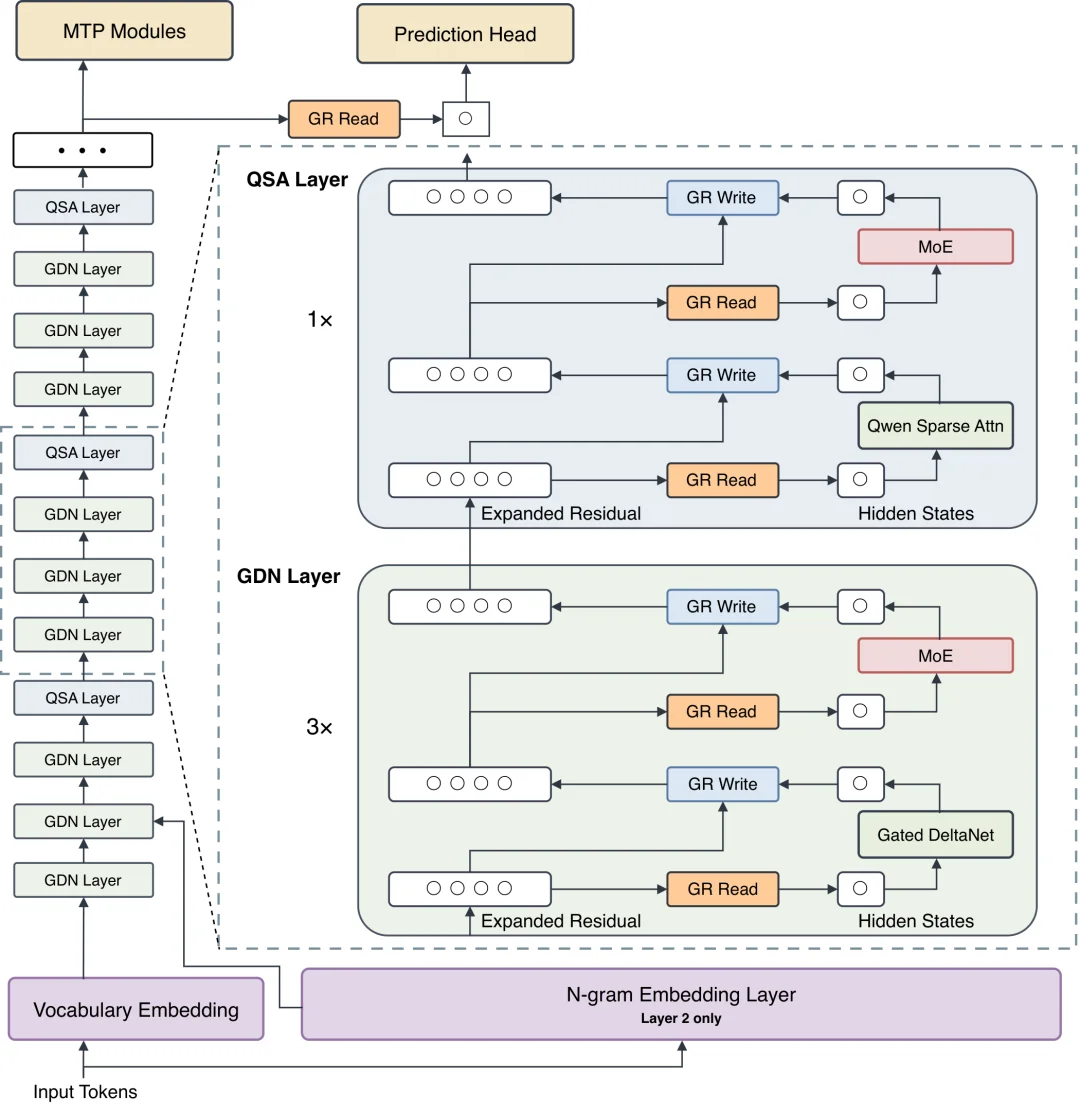
Mit diesem Aufbau aktiviert Qwen4-Max pro Token 71 Milliarden Parameter – rund 25% weniger als der Vorgänger Qwen3.8-Max (95B) – und lief im Pretraining über 2,4 Billionen Parameter komplett ohne Loss Spikes durch. In Alibabas internen Basismodell-Tests über Wissen (Knowledge), Code, Frage-Antwort (QA) und MINT (STEM) erreicht Qwen4-Max-Base bei den Bits per Byte (BPB, niedriger ist besser) unter allen fünf geprüften Checkpoints den niedrigsten Wert und liegt rund 5% bis 13% unter Qwen3.8-Max-Base. Eine Fußnote räumt zugleich ein, dass die mitgetesteten Modelle GLM-5.3 und Kimi-K3.1-Pro bereits Post-Training-Checkpoints sind, was den direkten Vergleich mit reinen Base-Modellen beeinflusst.
Der Ablauf in der Woche vor dem Release: Am 6. November postete der offizielle Qwen-Account auf X den Teaser „The becoming begins.“. Am 7. November schaltete die Programmier-IDE Qoder das anonyme Modell Qoduck für Einzelnutzer zeitweise kostenlos frei und spielte vier Tage lang täglich ein neues Build ein. Am 11. November lüftete Qoder das Geheimnis und stellte das Modell auf Qwen4-Max-Preview um (der Post sammelte über 5,4 Millionen Aufrufe). Am 16. November ging die finale Version live.
Aktuell ist Qwen4-Max (Modell-ID qwen4-max) per Pay-as-you-go-API in Festlandchina über Alibaba Cloud Model Studio sowie international über QwenCloud verfügbar und zusätzlich in das Abo-Modell Token Plan (Region Singapur) eingebunden. Direkt nutzen lässt es sich außerdem in QwenWork, Qoder, der Qwen app und Qwen Studio.
Qwen4-Max selbst erscheint ohne offene Gewichte. Am Ende des Blogbeitrags kündigt das Team lediglich an, dass kleinere und mittlere Modelle der Qwen4-Reihe nach und nach als Open-Weight-Modelle folgen sollen – ohne Angaben zu Parametergrößen oder Terminen. Unter dem Enthüllungspost forderte die Community bereits massenhaft Nachschub mit dem Spruch „Qwen-4 27B > GTA VI“.
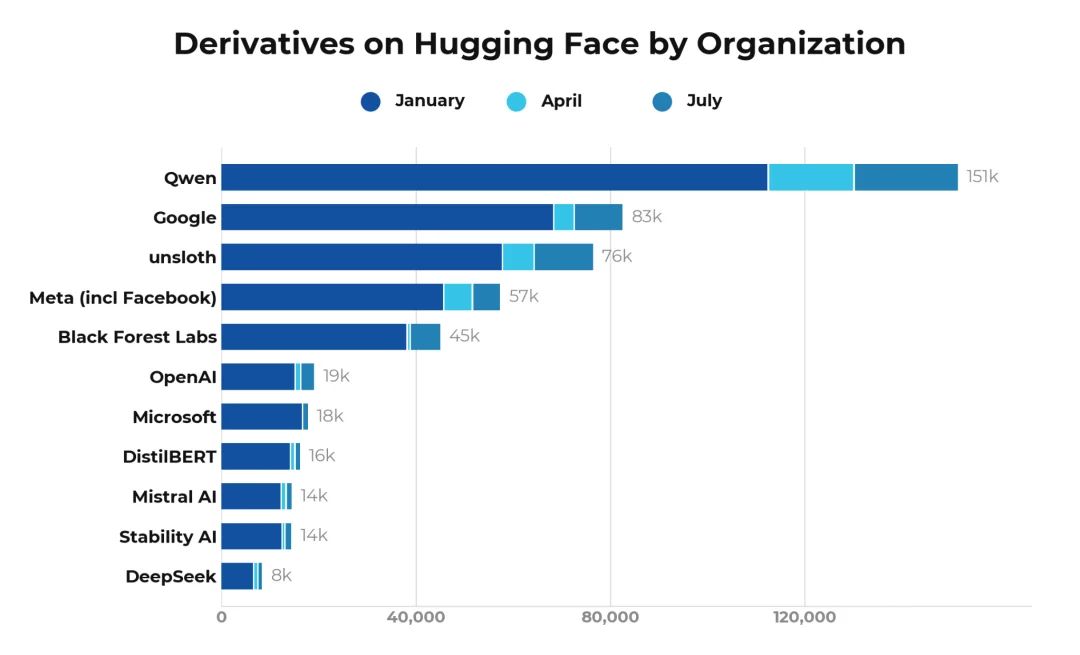
Dass viele Entwickler vor allem auf die kleineren Modelle warten, hat einen einfachen Grund: Die offenen Qwen-Gewichte gehören lokal wie auf eigenen Servern zu den meistgenutzten Basismodellen überhaupt. Laut dem Bericht zu offenen Modellen im Sommer 2026 von Hugging Face wurde Qwen zwischen Januar und August 2026 allein auf Hugging Face 2,045 Milliarden Mal heruntergeladen (über alle Plattformen hinweg nennt Alibaba mehr als 3 Milliarden Downloads). Auf Basis von Qwen entstanden 151.448 abgeleitete Modelle – das 2,6-Fache von Meta und mehr als Google (82.506) und Meta zusammen.
Auch in Unternehmen läuft die Modellfamilie im Produktivbetrieb. Airbnb-CEO Brian Chesky erklärte im Oktober 2025 in einem Interview, der KI-Kundendienst von Airbnb stütze sich stark auf Alibabas Qwen-Modell – es sei sehr gut, schnell und günstig.
Dabei schlägt das proprietäre Spitzenmodell nicht automatisch jedes kleinere Open-Weight-Modell aus eigenem Haus. Der Hacker-News-Nutzer chriddyp ließ Qwen4-Max gegen den internen Benchmark seines Teams für kurze Datenanalyse-Aufgaben antreten: Es schnitt ein paar Punkte schlechter ab als das im August veröffentlichte Open-Weight-Modell Qwen3.8 27B, das auf normaler Desktop-Hardware läuft, und war pro Durchlauf obendrein etwas teurer.
Das Qwen-Team hat 16 Benchmarks aus Programmierung, Büroarbeit, Forschung und Multimodalität veröffentlicht und Qwen4-Max dort mit Qwen3.8-Max-0902, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra und Kimi K3.1 verglichen.
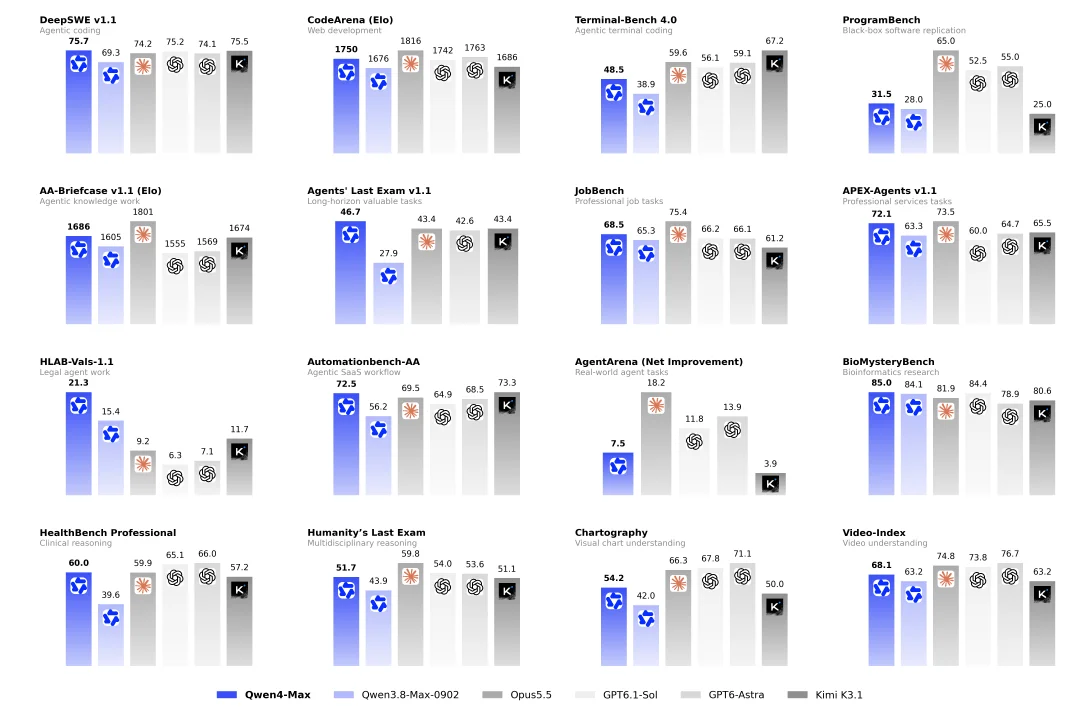
Die vollständigen Werte aller 16 Disziplinen aus dem Diagramm (Bestwerte je Zeile fett markiert):
| Benchmark | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 (GPT, nur ein Wert im Diagramm) | — | 43.4 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | 11.8 | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Das Qwen-Team bildet Siege und Rückstände in derselben Grafik ab, statt nur die gewonnenen Disziplinen herauszupicken:
Im doppelblinden Frontend-Ranking CodeArena: WebDev (Stand 14. November 2026, 159 Modelle, über 1 Million Stimmen) liegt Qwen4-Max (xHigh) mit 1,750 Elo-Punkten weltweit auf Platz 6 und ist damit das bestplatzierte chinesische Modell (das nächste folgt auf Platz 13 mit Kimi K3.1 Pro bei 1,686 Punkten). Es reiht sich knapp hinter GPT-6 Astra (1,763) und vor Claude Fable 5.1 (1,743), GPT-6.1 Sol (1,742) sowie Claude Sonnet 5.5 auf High (Platz 10, 1,716 Punkte) ein. Zwei Details gehören zur Einordnung dazu: Erstens steht Sonnet 5.5 auf der Stufe xHigh mit 1,772 Punkten auf Platz 3; zweitens basiert der Wert von Qwen4-Max bislang auf 1,814 Stimmen und ist als Preliminary (vorläufig) mit einer Schwankungsbreite von ±15 Punkten (Rank Spread 3–9) gekennzeichnet.
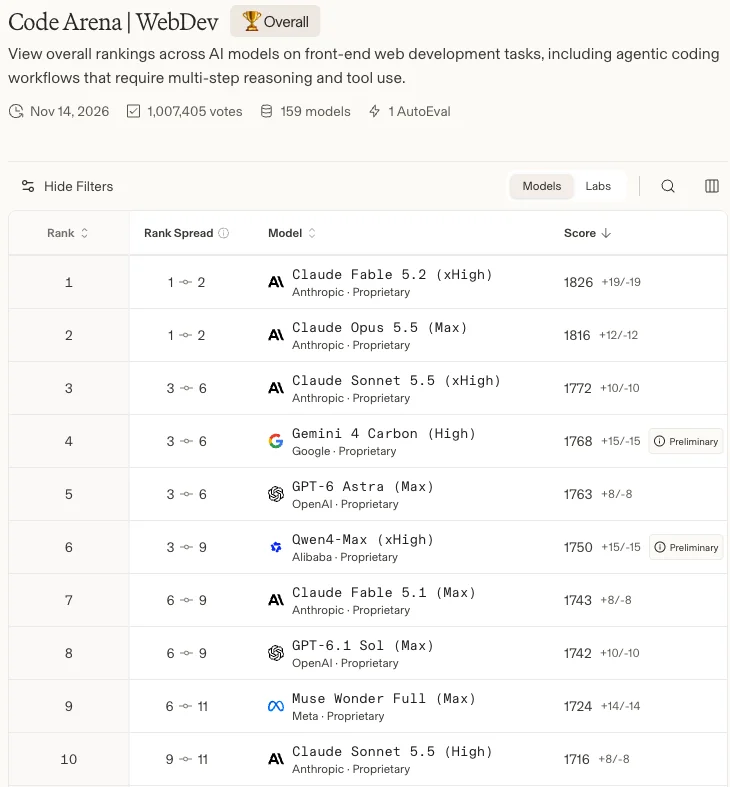
| Rang | Modell | Elo-Wert | Anmerkung |
|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 ±19 | — |
| 2 | Claude Opus 5.5 (Max) | 1816 ±12 | — |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 ±10 | — |
| 4 | Gemini 4 Carbon (High) | 1768 ±15 | Preliminary |
| 5 | GPT-6 Astra (Max) | 1763 ±8 | — |
| 6 | Qwen4-Max (xHigh) | 1750 ±15 | Preliminary; Rank Spread 3–9; 1,814 Stimmen; Cost/Task (P50) $4.18 |
| 7 | Claude Fable 5.1 (Max) | 1743 ±8 | — |
| 8 | GPT-6.1 Sol (Max) | 1742 ±10 | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 ±8 | — |
| 13 | Kimi K3.1 Pro (Max) | 1686 ±9 | Nächstes chinesisches Modell |
| 16 | Qwen3.8-Max (0902) | 1676 ±6 | Vorgängergeneration |
| 19 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 ±7 | Vergleichsmodell beim Token-Verbrauch unten |
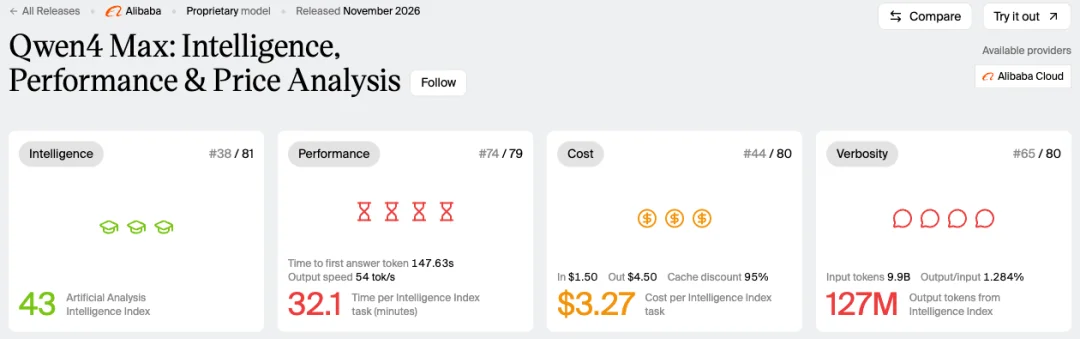
Die unabhängigen Messungen von Artificial Analysis (Abruf vom 17. November 2026) zeichnen ein nüchternes Gesamtbild: Im Intelligence Index v5.0.1, der 9 Einzeltests bündelt, kommt Qwen4-Max auf 43 Punkte und landet damit auf Platz 38 von 81 Modellen (Median vergleichbarer Modelle: 41). Im selben Testfeld erreicht GPT-6.1 Sol (max) 55 Punkte bei durchschnittlichen Kosten von nur $1.27 pro Aufgabe – 12 Punkte mehr als Qwen4-Max ($3.27) und pro Aufgabe 61% günstiger. Kimi K3.1 Pro liegt bei 46 Punkten und $3.68 pro Aufgabe.
| Modell | Intelligence Index | Zeit pro Aufgabe (Min.) | Kosten pro Aufgabe |
|---|---|---|---|
| Claude Fable 5.2 (max) | 65 | 40.8 | $26.54 |
| Gemini 4 Carbon (high) | 60 | 31.1 | $5.48 |
| Claude Opus 5.5 (max) | 59 | 24.6 | $10.04 |
| GPT-6 Astra (max) | 57 | 20.4 | $6.24 |
| GPT-6.1 Sol (max) | 55 | 23.0 | $1.27 |
| Kimi K3.1 Pro | 46 | 38.8 | $3.68 |
| Qwen4-Max | 43 | 32.1 | $3.27 |
| Grok 4.7 (xhigh) | 35 | 24.6 | $7.77 |
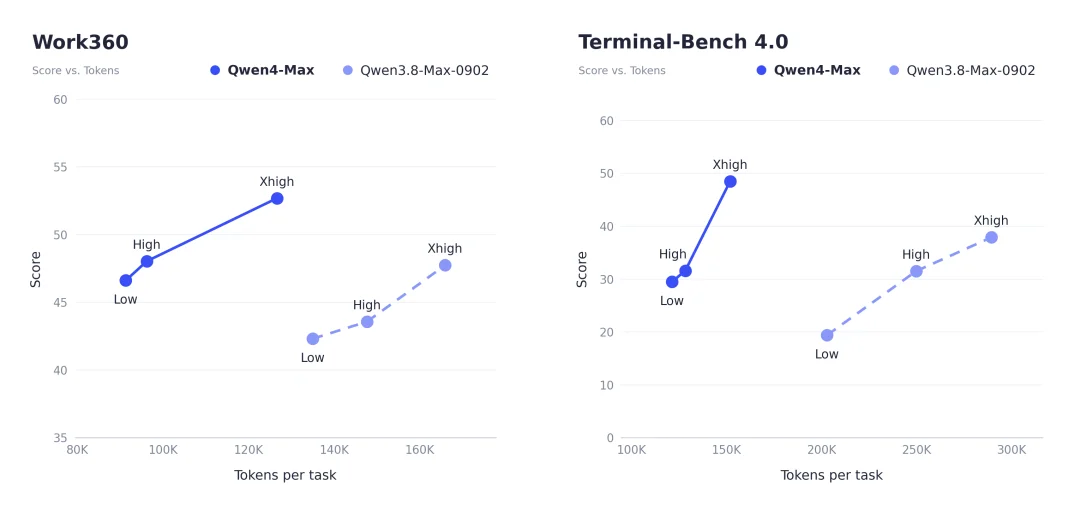
Gegenüber dem Vorgänger Qwen3.8-Max sinkt der Token-Verbrauch laut den offiziellen Zahlen spürbar: Auf Work360 braucht Qwen4-Max auf den Stufen xhigh und high rund 24% bzw. 35% weniger Token pro Aufgabe. Auf Terminal-Bench 4.0 fällt der Schnitt pro Aufgabe auf xhigh von rund 289K auf 151K Token (minus 48%), während die Punktzahl von 38.9 auf 48.5 steigt; auf high geht der Token-Verbrauch um rund 49% zurück.
Während der Preview-Phase haben Entwickler außerdem zwei direkte Vergleichstests bei identischen Prompts veröffentlicht:
Qwen4-Max-Preview und DeepSeek-v4.1-flash-1017 über 103 identische Three.js-Aufgaben laufen: In 87 von 103 Aufgaben verbrauchte die Qwen-Preview weniger Token – im Schnitt rund 77K Token pro Aufgabe gegenüber 115K bei DeepSeek, also etwa 33% weniger.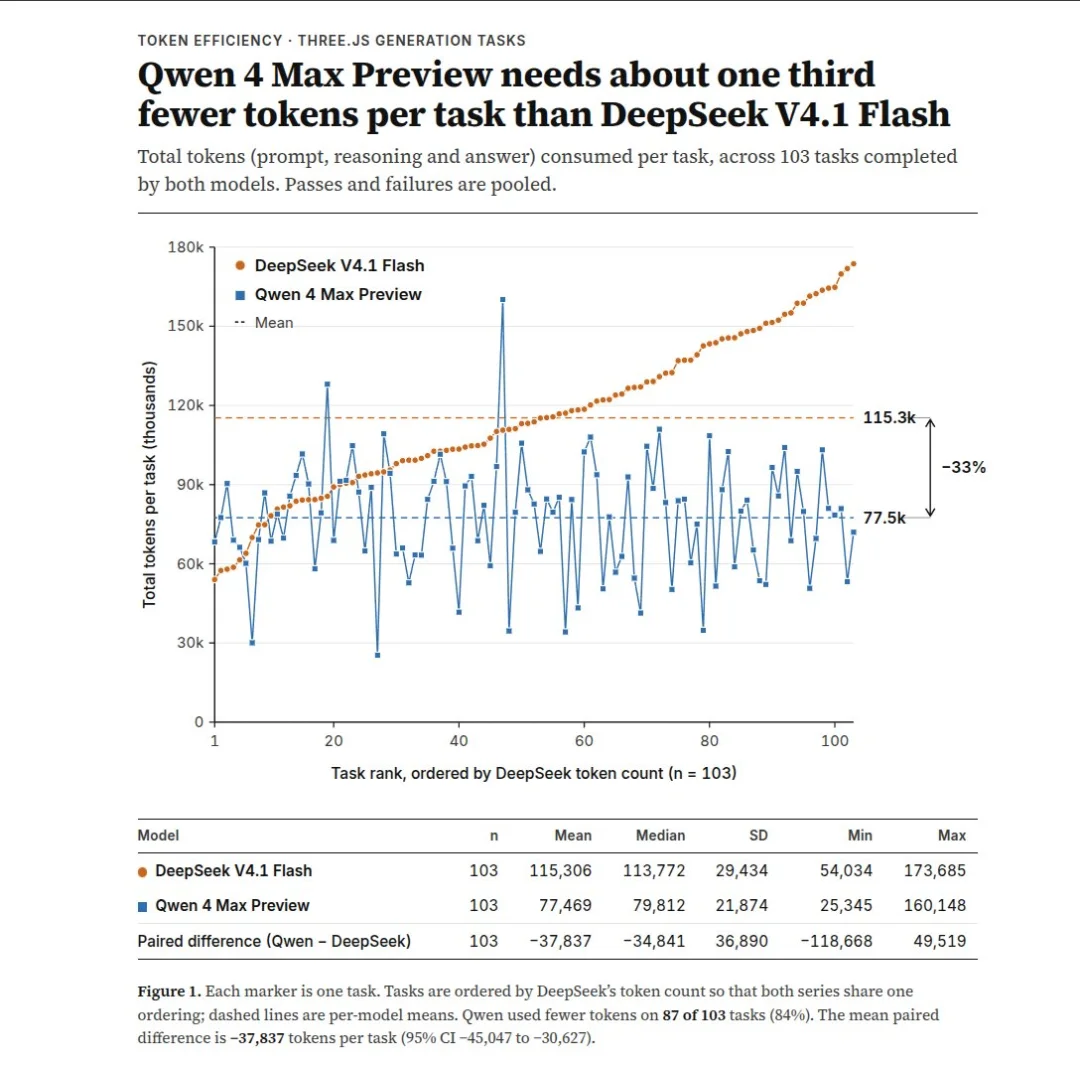
Beide Community-Tests liefen mit der Preview-Version und traten gegen DeepSeek V4.1 Flash an. Zwar spart Qwen pro Aufgabe ein Drittel bis die Hälfte der Token ein, doch DeepSeek V4.1 Flash kostet per API nur $0.15 / $0.60 pro Million Input- bzw. Output-Token – ein Zehntel des Input-Preises von Qwen4-Max ($1.50 / $4.50) und rund ein Siebtel beim Output. @ItsmeAjayKV hielt im Originalpost entsprechend fest, dass deepseek-v4.1-flash bei Preis und Modellgröße klar vorn liegt.
Im anbieterübergreifenden Vergleich von Artificial Analysis erzeugte Qwen4-Max über den gesamten Intelligence-Index-Durchlauf 127 Millionen Output-Token – deutlich mehr als der Median vergleichbarer Modelle (78.6 Millionen) – und erhielt das Label „very verbose“. Eine Aufgabe dauerte im Schnitt 32.1 Minuten (Median: 13.3 Minuten), die Wartezeit bis zum ersten Antwort-Token (time to first answer token) lag bei 147.63 Sekunden, die Ausgabegeschwindigkeit bei 54 Token/s.
| Testszenario | Referenz | Qwen4-Max | Referenzwert | Einordnung |
|---|---|---|---|---|
| Work360 (xHigh / High) | Qwen3.8-Max-0902 | ≈127K / ≈96K | ≈166K / ≈148K | Rund 24% / 35% weniger als der Vorgänger |
| Terminal-Bench 4.0 (xHigh / High) | Qwen3.8-Max-0902 | ≈151K / ≈129K | ≈289K / ≈250K | Rund 48% / 49% weniger als der Vorgänger |
| 103 Three.js-Aufgaben (Preview) | DeepSeek V4.1 Flash | 77.5K / Aufgabe | 115.3K / Aufgabe | 33% weniger Token, aber DeepSeek kostet pro Token eine Größenordnung weniger |
| AA Intelligence Index (Output gesamt / Dauer pro Aufgabe) | Median vergleichbarer Frontier-Modelle | 127M / 32.1 Min. | 78.6M / 13.3 Min. | AA-Vermerk „very verbose“, Laufzeit rund das 2.4-Fache des Medians |
Wir finden: Die Token-Ersparnis von Qwen4-Max gilt im Vergleich zum eigenen Vorgänger Qwen3.8-Max und zu DeepSeek V4.1 Flash. Gemessen am restlichen Feld aktueller Frontier-Modelle bleibt es auf hoher Reasoning-Stufe langsam und wortreich.
Laut der Dokumentation von Alibaba Cloud Model Studio bietet der Parameter reasoning_effort bei Qwen4-Max die drei Stufen low, high und xhigh (Standard ist high bei einem maximalen Reasoning-Budget von thinking_budget=131072; wer minimal, medium oder max übergibt, landet automatisch auf low, high bzw. xhigh).
Aus Alibabas Effizienzdiagramm ergeben sich für die drei Stufen auf Work360 und Terminal-Bench 4.0 folgende Punktzahlen und Token-Mengen pro Aufgabe:
| Benchmark | Low | High (Standard) | Xhigh | Abstand High zu Xhigh |
|---|---|---|---|---|
| Work360 (Büro- und Branchenaufgaben) | ≈46.6 Pkt. (≈91K) | ≈48.0 Pkt. (≈96K) | 52.69 Pkt. (≈127K) | High liegt ca. 4.7 Punkte tiefer und spart ca. 24% Token |
| Terminal-Bench 4.0 (Terminal-Coding) | ≈29.5 Pkt. (≈122K) | ≈31.5 Pkt. (≈129K) | 48.5 Pkt. (≈151K) | High liegt ca. 17.0 Punkte tiefer und spart nur ca. 15% Token |
In der Preview-Phase stand die Standardstufe noch fest auf xhigh, was einfache Aufgaben unnötig in die Länge zog. @SrinivasValekar berichtete von einem Test zur Dorf-Generierung, bei dem beide Modelle auf xhigh liefen: Gemini 4 Hydrogen war nach 12 Minuten für rund $1.7 fertig, Qwen4-Max brauchte 1 Stunde und 15 Minuten für rund $0.9. Ein einzelner Durchlauf ersetzt keine Rangliste, aber der Zeitabstand ist enorm.
Der YouTube-Kanal The Dark Factory testete qwen4-max-preview über das Token-Plan-Abo direkt in Claude Code und ließ dieselbe Budget-App-Aufgabe auf zwei Stufen gegeneinander laufen: Wurde die Reasoning-Stufe vom Standard xhigh auf low gesenkt, fiel die Laufzeit von 24 auf 9 Minuten, die gelesenen Kontext-Token sanken von 4.4M auf 1.1M (minus 75%), der Output ging von 83K auf 31K zurück (minus 63%), und die blinde Bewertung durch Codex (GPT-6.1 Sol) stieg von 8/10 auf 9/10.
| Reasoning-Stufe | Output-Token | Gelesene Token | Dauer | Blindbewertung (Judge: GPT-6.1 Sol) |
|---|---|---|---|---|
| Standard (xHigh) | 83K | 4.4M | 24 Min. | 8 / 10 |
| low | 31K (-63%) | 1.1M (-75%) | 9 Min. | 9 / 10 |
Der Test von The Dark Factory umfasst nur einen einzelnen Durchlauf an einer Frontend-Aufgabe mit einem einzigen KI-Judge. Nimmt man die offiziellen Kurven von oben hinzu, finden wir: Die neue Standardstufe high der finalen Version reicht für Büroaufgaben, normales Frontend und Frage-Antwort-Runden völlig aus. Sobald komplexe Full-Stack-Entwicklung oder autonome Kommandozeilen-Aufgaben wie in Terminal-Bench anstehen, klafft zwischen high und xhigh eine Lücke von 17 Punkten – dort lohnt sich das manuelle Umschalten auf xhigh.
Ein minimales Codebeispiel zur Wahl der Reasoning-Stufe über die OpenAI-kompatible Schnittstelle (Responses API) von QwenCloud:
from openai import OpenAIimport os client = OpenAI( api_key=os.getenv("DASHSCOPE_API_KEY"), base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",) resp = client.responses.create( model="qwen4-max", input="Schreib Unit-Tests für diese Funktion", reasoning={"effort": "high"}, # low / high / xhigh, Standard ist high)print(resp.output_text)Alibaba führt zwei offizielle Preislisten: eine für Festlandchina (Alibaba Cloud Model Studio) und eine internationale (QwenCloud, Region Singapur). In Festlandchina kosten eine Million Standard-Input-Token CNY 10 und eine Million Output-Token CNY 30 – rund 16.7% weniger als beim Vorgänger qwen3.8-max (CNY 12 / 36). Der Preis für Cache-Hits fällt auf CNY 0.5 pro Million Token (international $0.075 pro Million), also 5% des regulären Input-Preises. Zusammen mit dem geringeren Token-Bedarf pro Aufgabe sinken die durchschnittlichen Gesamtkosten einer Work360-Aufgabe laut Alibaba von $4.43 beim Vorgänger auf $1.67 – ein Minus von 62%.
| Posten | Festlandchina (Model Studio) | International (QwenCloud, Singapur) |
|---|---|---|
| Standard-Input (0 < Token ≤ 1M, mit und ohne Reasoning identisch) | CNY 10 / Mio. | $1.5 / Mio. |
| Output (Reasoning-Tokens + Antwort) | CNY 30 / Mio. | $4.5 / Mio. |
| Cache-Hit (explizit / implizit) | CNY 0.5 / Mio. | $0.075 / Mio. |
| Expliziten Cache anlegen (5 Min. TTL) | CNY 12.5 / Mio. | $1.875 / Mio. |
| Expliziten Cache anlegen (1 Std. TTL) | CNY 20 / Mio. | $3 / Mio. |
| Freibetrag für Neukunden | 1 Mio. Token (90 Tage) | — |
Laut den Abrechnungsregeln von Model Studio gilt für das Caching: Der implizite Cache (Implicit Cache) ist standardmäßig aktiv und erfordert keine Codeänderung, garantiert aber keinen Treffer bei jeder Anfrage. Für den expliziten Cache (Explicit Cache) muss das Präfix mindestens 1,024 Token lang sein; die Gültigkeit (TTL) beträgt wahlweise 5 Minuten (Standard) oder 1 Stunde und verlängert sich bei einem Treffer automatisch. Caches werden ausschließlich zwischen Anfragen desselben Kontos geteilt, und Output-Token (einschließlich Reasoning-Tokens) werden immer zum vollen Satz abgerechnet.
Wie sich das auf echte Multi-Turn-Sitzungen auswirkt, zeigt eine Nachrechnung mit den Nutzungsdaten des Entwicklers @superalesha. Er ließ die Preview auf der Stufe xhigh mit identischem Prompt eine regnerische Nachtszene mit Ramen-Stand in Tokio in Blender bauen – einmal über DeepSeek Harness (DSH) und einmal über Qwen Code. Umgerechnet auf die finalen Listenpreise (Kosten = Input ohne Cache-Hit × Input-Preis + Cache-Hits × Cache-Preis + Output × Output-Preis) sieht die Rechnung so aus:
| Harness (gleicher Prompt, xHigh) | Input gesamt (Cache-Hit / ohne Hit) | Output | Festlandchina gesamt (mit Cache) | Festlandchina (bei 0 Cache) | International gesamt (mit Cache) | International (bei 0 Cache) |
|---|---|---|---|---|---|---|
| DeepSeek Harness | 11.96M (11.59M / 0.37M) | 130K | 3.70 + 5.80 + 3.90 = CNY 13.40 | CNY 123.50 | $2.01 | $18.53 |
| Qwen Code | 3.02M (2.85M / 0.17M) | 62K | 1.70 + 1.43 + 1.86 = CNY 4.99 | CNY 32.06 | $0.75 | $4.81 |
Aus dieser Abrechnung lassen sich drei Dinge ablesen:
Rund um das 1-Million-Token-Kontextfenster, die native Bilderkennung und Tool-Aufrufe zeigen der offizielle Blog und die Community mehrere mehrstufige Workflows.
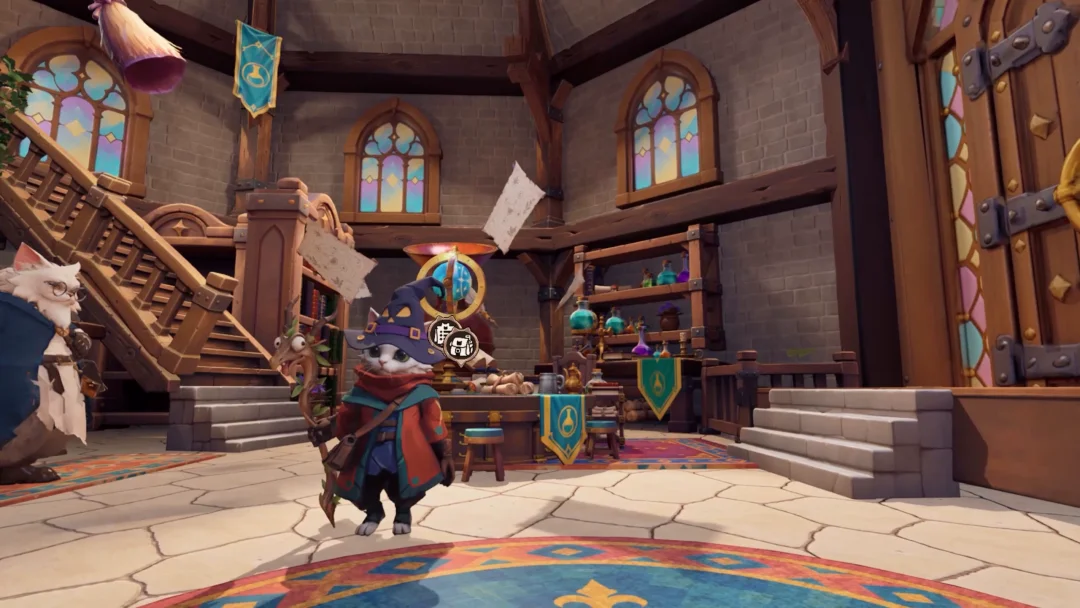
In der 3D- und Spieleentwicklung ließ @superalesha das Modell ausschließlich über Blender MCP per Python-Skript – ohne externe Assets – den erwähnten Ramen-Stand bei Regen in Tokio modellieren. Der Prompt verlangte Stoffvorhänge, Papierlaternen, dampfende Suppenschüsseln, Getränkeautomaten und Pfützen mit Neon-Spiegelungen in Cycles-Rendering; anschließend prüfte das Modell die gerenderten Bilder selbst und besserte fehlerhafte Stellen nach. Das Qwen-Team zeigte parallel, wie Qwen4-Max in Unity, Unreal Engine und Godot aus natürlichsprachlichen Vorgaben direkt Szenen aufbaut, Spiellogik schreibt, externe Assets einbindet und anhand des laufenden Bildes Kameraführung und Trefferfeedback abstimmt – darunter das 3D-Katzenmagier-Abenteuer Meow of Magic in Unreal Engine, das Fantasy-Flugspiel Yun Guan Xing sowie das Android-Rennspiel Flying Racer in Unity 6.
Weil langlaufende Agent-Aufgaben oft mitten im Lauf in eine falsche Richtung abbiegen und sich am Ende kaum noch korrigieren lassen, führt Alibaba mit Qwen4-Max den Mechanismus Live Delivery samt dem quelloffenen Plugin Qwen-Live-Delivery-Plugin ein: Bei komplexen Aufträgen liefert das Modell zuerst rasch eine lauffähige erste Version und baut sie anschließend anhand von Ausführungs-Feedback und Nutzereingaben Schritt für Schritt aus, sodass Entwickler jederzeit gegensteuern können.
Aus Industrie, Finanzwesen, Recht, Medizin und Forschung nennt Alibaba sechs Partnerprojekte:
| Bereich | Aufgabe | Genannte Kennzahlen |
|---|---|---|
| Automobilfertigung (SANF, Pacific Union) | 3D-Fertigungslinien aus 2D-Layouts und Prozessparametern aufbauen und virtuell per SPS (PLC) in Betrieb nehmen; Türbaugruppen und Reibräder auf Bauteilebene konstruieren, CNC-Werkzeugwege berechnen und vorab auf Über- oder Unterschnitt simulieren | Manueller Programmieraufwand pro Werkstück sinkt von rund 475 auf 24 Minuten (minus ca. 95%) |
| Juristische IPO-Due-Diligence | Ungeordnet angelieferte Arbeitspapiere (Working Papers) sichten, nach Inhalt umbenennen, in Ordner sortieren und indizieren; Handelsregister-, IP-, Gerichts- und Bonitätsdaten abgleichen sowie Risiken durch Wiederauflebensklauseln (Reinstatement Clauses) in Wertanpassungsvereinbarungen (VAM) markieren | 198 Arbeitspapiere in 14 Ordner sortiert, 86-seitigen Bericht (über 60,000 chinesische Zeichen) über 12 Prüffelder und 14 Rechtsfragen mit Belegverweisen erstellt |
| Finanzanalyse (CSI-300-Index-Futures) | Marktdaten zu A-Aktien, Hongkong- und US-Aktien, Anleihen, Fonds und Derivaten abrufen, anhand von Finanzierungskosten, Dividendenrenditen und Laufzeiten die theoretische Futures-Basis und Volatilitäts-Spreads berechnen und doppelt rückverfolgbare Excel- und editierbare PowerPoint-Dateien ausgeben | Zugriff auf 90 MCP-Tools; Klick auf eine Excel-Zelle führt direkt zur Originalquelle, PowerPoint-Diagramme und Tabellenblätter sind exakt abgeglichen |
| Klinische Intensivmedizin | In einer Sitzung Dutzende Laborbefunde, umfangreiche Verlaufsdokumentationen und ärztliche Anordnungen auswerten, Rohbilder in 6 Sequenzen aufteilen und mehrere Sub-Agents parallel Hunderte Thorax-CT-Schichten prüfen lassen | Verlaufsnotizen von über 10,000 Zeichen und 1,433 Aufnahmen verarbeitet, bilaterale abhängige Konsolidierung erkannt (deckt sich mit der fachärztlichen Diagnose), 4 Therapieempfehlungen stimmen mit den Tagesanordnungen überein |
| Closed-Loop-Laborforschung (Deep Principle Mira) | Für die Kühlung von Hochleistungs-Chips in Rechenzentren eigenständig Struktur-Screening, MPA-Eigenschaftsprognosen, Ab-initio-Rechnungen und Retrosynthese durchführen und einen Laborroboter für Synthese, Aufreinigung und Messung ansteuern | 48 Stunden Dauerbetrieb, 2.7 Mio. Molekülkandidaten gefiltert und nach 4 geschlossenen Iterationen eine im Labor verifizierte Kühlmittelprobe hergestellt |
| Cloud-Ressourcenplanung (Alibaba Cloud + MindOpt) | Für das Multi-Modell-Routing bei der Datenannotation, die Online-Zuteilung von GPUs und das Offline-Rescheduling von CPUs eigene Kandidaten-Algorithmen entwerfen und gemeinsam mit Alibabas Solver MindOpt iterativ verifizieren | Routing-Kosten bei der Datenannotation sinken im Schnitt um 10.42%, zusammenhängende Leerlaufzeit freier GPU-Nodes steigt um 4.62%, optimale Lösung beim Offline-CPU-Rescheduling wird über 14.61-mal schneller gefunden |
Alle sechs Beispiele stammen aus Referenzprojekten von Alibaba und seinen Partnern und wurden bislang nicht unabhängig reproduziert. Die genannten Zeiteinsparungen und Beschleunigungsfaktoren solltest du daher als Bestwerte in speziell darauf zugeschnittenen Pipelines verstehen.
Wer mit einem einzigen Satz eine komplette statische Webseite generieren lässt, bekommt bei Qwen4-Max nach Einschätzung vieler Tester optisch schlichtere Ergebnisse als bei der westlichen Spitze: In einem Community-Vergleich zu chinesischen Tierkreiszeichen gegen GPT-6 Astra und DeepSeek V4.1 Flash stimmte bei der Preview zwar das Grundgerüst, Lichtstimmung und Detailtiefe wirkten jedoch flach.
Wenn du Qwen4-Max für Frontend- und UI-Aufgaben einsetzt, solltest du die Qualitätskriterien direkt im Prompt festschreiben und nach dem ersten Entwurf gezielt Farben oder Animationen in weiteren Runden nachschärfen. Diese Checkliste am Ende des Prompts hilft dabei:
Prüfe vor der Auslieferung der Frontend-Seite jeden Punkt:1. Visuelle Hierarchie: Klare Abstände, Schriftgrößenkontraste und Farbabstufungen; keine ungestylten Standard-Formularelemente ausgeben.2. Interaktion und Zustände: Alle Buttons, Filter, Modals und Formulare müssen funktionieren; ergänze Hover-Feedback, Ladezustände (Loading States) und Leerzustände (Empty States).3. Schwachstellen nachbessern: Prüfe vor der Abgabe den Gesamteindruck, greif den optisch oder interaktiv schwächsten Bereich heraus und überarbeite ihn in einer eigenen Runde.4. Rendering-Check: Stelle sicher, dass die Seite vollständig rendert – ohne ungeschlossene Tags, Layout-Überläufe oder Fehler in der Browser-Konsole.Aus den Benchmark-Werten, Laufzeiten und Abrechnungen von oben ergibt sich folgende Einordnung nach Aufgabe:
| Workload / Szenario | Empfehlung | Gründe und Kompromisse |
|---|---|---|
| Mehrstufige Agent-Läufe mit langem Kontext / Dokumenten- und Due-Diligence-Arbeit | Gut geeignet | 1M Kontextfenster; Platz 1 bei ALE (46.7) und HLAB-Vals (21.3); Cache-Hits kosten nur $0.075 (CNY 0.5) pro Mio. Token, Kosten pro Aufgabe auf Work360 sinken um 62% ($1.67). Produktiv am besten mit explizitem Cache nutzen |
| Code-Reparaturen in echten Repositories und normale Full-Stack-Arbeit | Geeignet, Stufe nach Aufgabe wählen | 75.7 Punkte auf DeepSWE v1.1; im Alltag reicht die Standardstufe high, für schwierige Full-Stack- oder Terminal-Aufgaben auf xhigh wechseln (auf Terminal-Bench liegen 17 Punkte dazwischen) |
| Intensive Terminal-Ausführung / Blackbox-Software-Nachbau | Lieber Claude oder Kimi wählen | Auf Terminal-Bench 4.0 nur 48.5 Punkte (Kimi K3.1: 67.2, Opus 5.5: 59.6); auf ProgramBench nur 31.5 (Opus 5.5: 65.0) |
| Hoher Intelligence Index bei niedrigen Kosten pro Aufgabe | Lieber GPT-6.1 Sol ansehen | Bei Artificial Analysis erreicht GPT-6.1 Sol (max) 55 Punkte für $1.27 pro Aufgabe; Qwen4-Max liegt bei 43 Punkten und $3.27 pro Aufgabe |
| Frontend-Seiten per Ein-Satz-Prompt generieren | Nur mit detaillierter Checkliste | Platz 6 auf CodeArena WebDev (1,750 ±15), aber Ein-Satz-Prompts wirken in Community-Tests oft flach; visuelle Hierarchie und Empty States explizit vorgeben und iterieren |
| Strenge Anforderungen an Latenz und Gesamtdauer / lokales Hosting | Ungeeignet | AA misst 147.63 s bis zum ersten Antwort-Token und 32.1 Min. pro Aufgabe; das Max-Modell gibt es nur per Cloud-API, zu kleineren Open-Weight-Modellen fehlen noch Größen und Termine |
Ja. Der Token Plan von QwenCloud unterstützt sowohl das OpenAI-Protokoll als auch das Anthropic-Messages-Protokoll; auf der offiziellen Kompatibilitätsliste stehen Claude Code, Cursor, Qwen Code, Codex, Qoder und OpenClaw (auch der oben gezeigte Test von The Dark Factory lief in Claude Code). Über die Anthropic-Messages-Schnittstelle übergibst du die Reasoning-Stufe per output_config.effort, wobei medium auf high und max auf xhigh abgebildet wird. Wichtig: Der Token Plan nutzt den eigenen Endpunkt token-plan.maas.qwencloudapi.com sowie spezielle Keys mit dem Präfix sk-sp-, die sich nicht mit regulären Pay-as-you-go-Keys mischen lassen.
In Festlandchina (Alibaba Cloud Model Studio) kosten eine Million Standard-Input-Token CNY 10, Output-Token CNY 30 und Cache-Hits CNY 0.5; dazu gibt es für Neukunden ein Freikontingent von 1 Million Token (90 Tage gültig). International (QwenCloud, Singapur) liegen die Preise bei $1.5 pro Million Input-Token, $4.5 für Output und $0.075 für Cache-Hits (für das internationale Deployment in Model Studio gilt daneben ein Tarif von CNY 10.938 / CNY 32.813). Umgerechnet zum Wechselkurs liegen beide Preislisten nah beieinander; das Abo-Modell Token Plan lässt sich derzeit allerdings nur in der Region Singapur buchen und nutzen.
Nein, Qwen4-Max selbst bleibt proprietär und ist ausschließlich über die Cloud-API und Alibabas offizielle Anwendungen zugänglich. Im Ankündigungs-Blog schreibt das Qwen-Team lediglich, dass kleinere und mittlere Modelle der Qwen4-Familie auf Basis derselben Architektur und Trainingsmethodik später als Open-Weight-Modelle veröffentlicht werden sollen – konkrete Parametergrößen oder ein Datum wurden bisher nicht genannt.
CodingPass bündelt Claude, GPT, Gemini sowie Qwen3.8 Flash und weitere Modelle, abgerechnet zu offiziellen API-Preisen. Keine Überraschungskosten, jederzeit kündbar.