Все модели
ID каждой модели, минимальный тариф и месячная квота в Go, Plus и Pro.
Индустрия соревнуется в том, кто выдаст больше токенов и сильнее рассуждает. Google выпустила модель, которая ничего не пишет: вы даёте ей входные данные и варианты, она за один проход называет лучший и сообщает, с какой уверенностью. JevBench — 92,2% точности, $0.10 за миллион входных токенов, выходные не тарифицируются.
Вся отрасль по-прежнему гонится за тем, кто выдаст больше токенов и сильнее рассуждает. Google выпустила модель, которая работает наоборот: она не генерирует ответ слово за словом.
11 ноября Google представила Gemini Decision 1 и основанный на ней Gemini Decisions API. Модель занимается только суждением: вы перечисляете варианты ответа, она делает один проход, ставит каждому варианту оценку, и на этом всё.
Коротко: Decision 1 не пишет текст. Вы даёте несколько вариантов, а модель сразу называет лучший. Классификация, маршрутизация, выбор инструмента и проверка на соответствие правилам, где нужен один результат, решаются быстрее и дешевле, и каждый ответ приходит с оценкой уверенности, которой можно доверять. Но универсальной её не назовёшь: в официальной таблице Google по вопросу «нужно ли вызывать инструмент» Decision 1 не выиграла.
Гендиректор Google Sundar Pichai сам представил модель в своём посте в X.
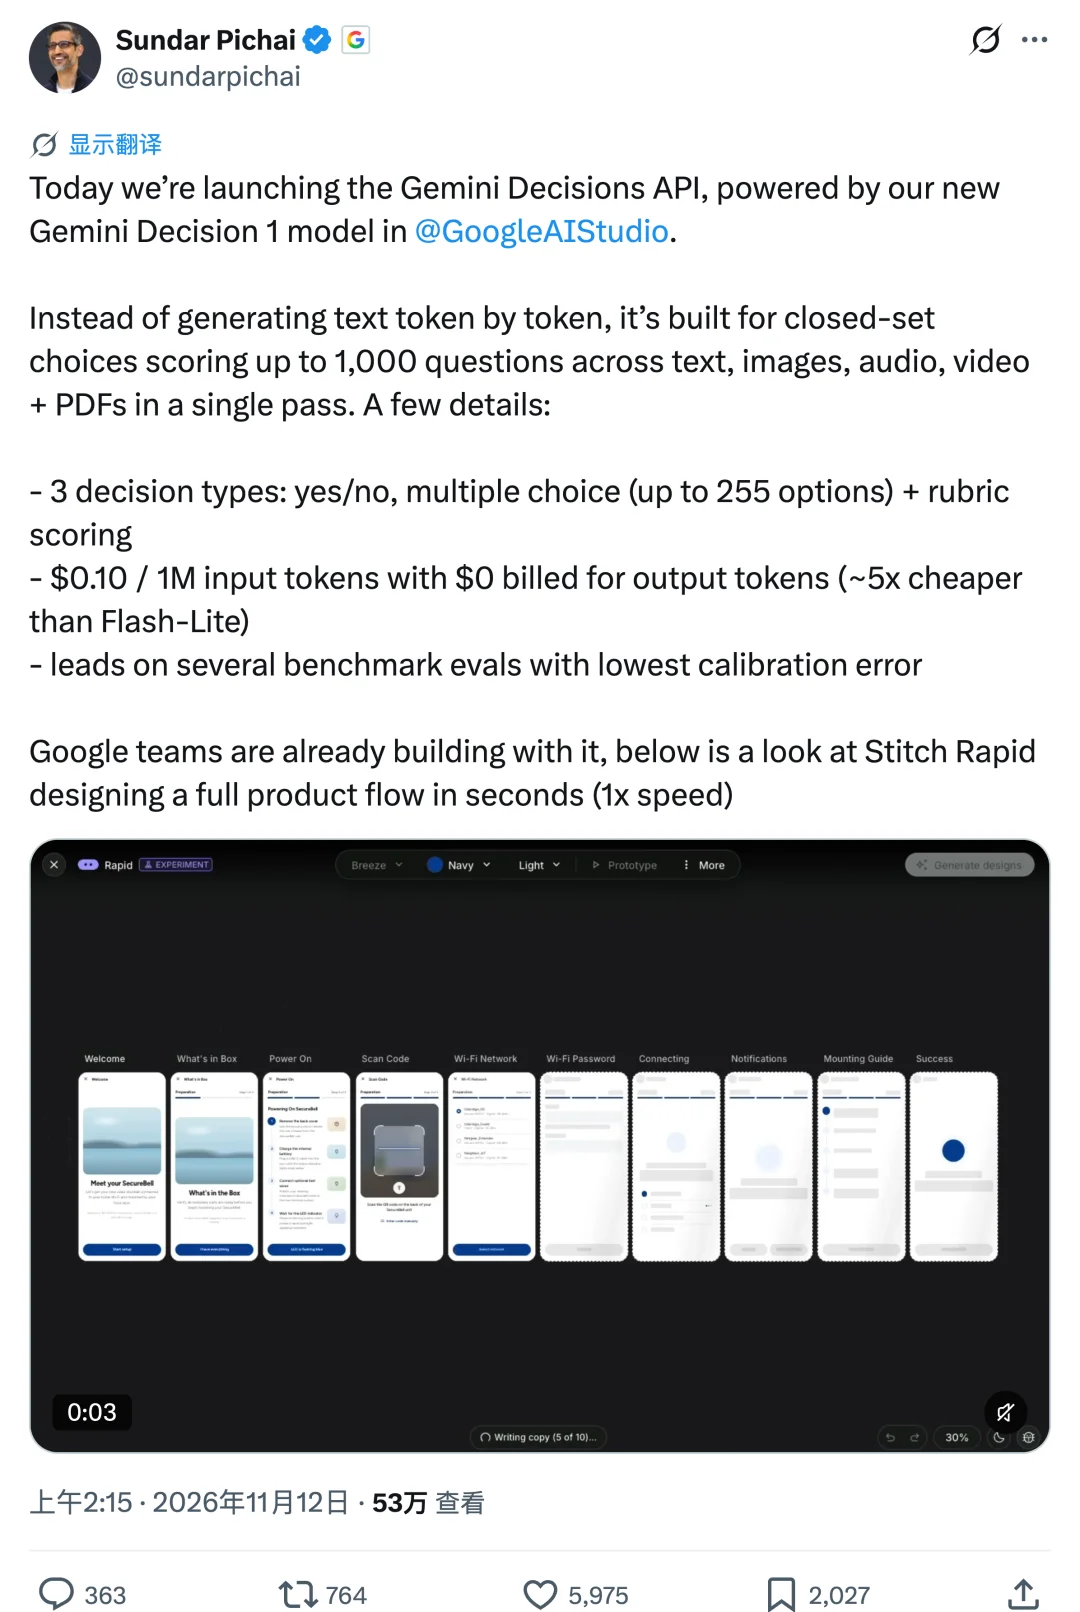
В посте выделены три детали:
Там же говорится, что внутренние команды Google уже работают с моделью, и приложено демо Stitch Rapid в реальном времени: за несколько секунд построен весь пользовательский путь продукта. Как это выглядит на реальных примерах, показано в видео:
Раньше, чтобы понять, спам ли письмо или какому агенту отдать задачу, обычно вызывали генеративную модель, дожидались текста и разбирали из него ответ. Decision 1 убирает пошаговую генерацию текста: вы передаёте входные данные, вопрос и варианты, а модель сразу возвращает выбранный вариант, вероятность каждого и уверенность.
Задачи, в которых нужны классификация, оценка или выбор, больше не требуют полного цикла генерации текста.
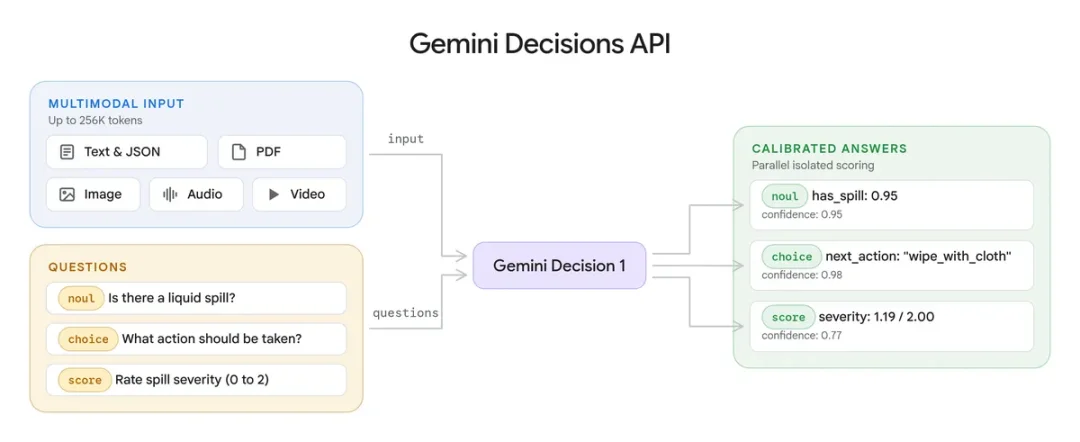
По данным Google, один запрос может содержать до 1000 независимых вопросов. Входные данные могут быть текстом, изображением, аудио, видео или PDF, а сквозная задержка составляет 150–250 мс.
Цена тоже низкая: $0.10 за миллион входных токенов, выходные не тарифицируются. На общем для всех моделей наборе из 7 тестов модель обходится почти в пять раз дешевле Gemini 3.5 Flash-Lite через Interactions API.
Google не ограничивает её выбором ответов. Маршрутизация моделей, выбор инструмента агентом, дизайн продукта и проверка безопасности уже работают внутри компании, и Google хочет сделать модель слоем ИИ-системы, который отвечает за решения.
Decision 1 поддерживает три типа вопросов:
| Тип вопроса | Имя в API | Что делает | Что возвращает |
|---|---|---|---|
| Да / нет | noul | Есть ли риск для безопасности на изображении, нарушает ли текст правила | Вероятность того, что условие выполнено |
| Выбор из нескольких | choice | Выбирает лучший вариант из 2–255 кандидатов | Выбранный вариант и нормализованная вероятность каждого варианта |
| Упорядоченная оценка | score | Оценивает по заданной вами шкале уровней (нумерация с нуля) | Взвешенная непрерывная оценка и вероятность каждого уровня |
Все три типа можно задать в одном запросе.
Google приводит пример: фото столешницы в офисной кухне и короткая подпись. Модель одновременно отвечает на три вопроса: есть ли пролитая жидкость, которую не вытерли, как её убрать и насколько это серьёзно.
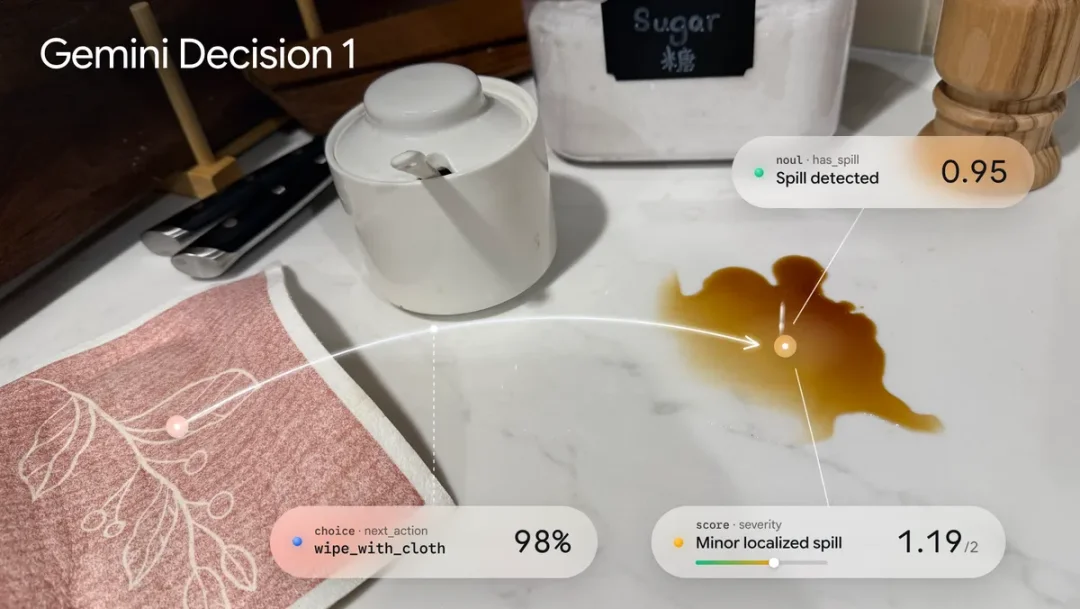
Раньше на это уходило несколько отдельных классификаторов или несколько промптов для генеративной модели. Теперь хватает одного запроса.
Контекст на входе достигает 256K токенов, и разные типы данных можно смешивать в одном контексте. В компании это значит: сопоставить запись звонка с данными клиента или проверить страховое заявление вместе с фотографиями.
Каждое решение получает уверенность от 0 до 1. Если модель не уверена, систему можно сразу передать другой модели или человеку на проверку.
Скорость и цена дают ещё два преимущества. При контексте до 16K токенов медианная задержка вычисления модели составляет 50–100 мс, а сквозная задержка 150–250 мс. Рост числа вопросов с 1 до 100 почти не увеличивает задержку. Общие входные данные оплачиваются один раз за запрос, а каждый дополнительный вопрос добавляет только токены собственного описания и вариантов.
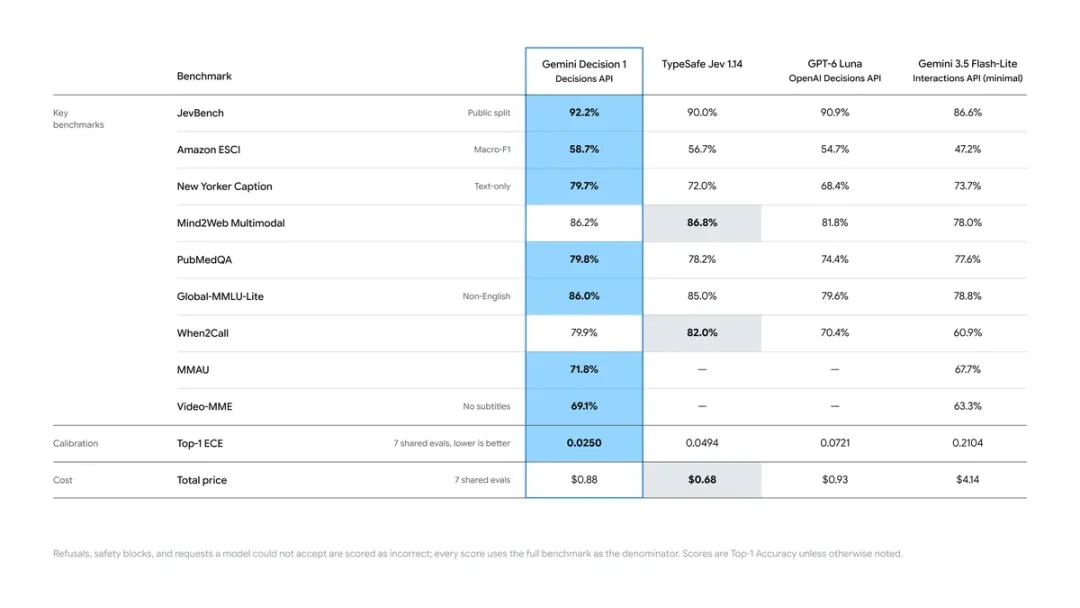
Google сравнила модель не с универсальными генеративными моделями, а с теми, что работают в том же профиле. Обычно новую модель сравнивают с целой группой универсальных моделей. Здесь соперниками стали GPT-6 Luna из OpenAI Decisions API, TypeSafe Jev 1.14, который делает классификацию решений, и собственная Gemini 3.5 Flash-Lite.
| Тест | Decision 1 | TypeSafe Jev 1.14 | GPT-6 Luna | Flash-Lite |
|---|---|---|---|---|
| JevBench | 92,2% | 90,0% | 90,9% | 86,6% |
| Amazon ESCI (Macro-F1) | 58,7% | 56,7% | 54,7% | 47,2% |
| New Yorker Caption | 79,7% | 72,0% | 68,4% | 73,7% |
| Mind2Web Multimodal | 86,2% | 86,8% | 81,8% | 78,0% |
| PubMedQA | 79,8% | 78,2% | 74,4% | 77,6% |
| Global-MMLU-Lite (неанглийские языки) | 86,0% | 85,0% | 79,6% | 78,8% |
| When2Call | 79,9% | 82,0% | 70,4% | 60,9% |
| MMAU (аудио) | 71,8% | — | — | 67,7% |
| Video-MME (без субтитров) | 69,1% | — | — | 63,3% |
| Top-1 ECE (чем ниже, тем лучше) | 0,0250 | 0,0494 | 0,0721 | 0,2104 |
| Общая стоимость 7 общих тестов | $0.88 | $0.68 | $0.93 | $4.14 |
Из 9 тестов Decision 1 первая в 7 и по калибровке тоже первая. В двух тестах и по общей стоимости лучше соперники.
Сначала о победах. В JevBench модель набрала 92,2%, на 1,3 процентного пункта больше, чем GPT-6 Luna. В Amazon ESCI, тесте на релевантность товарного поиска, у неё на 4 процентных пункта больше, чем у Luna, и на 11,5 процентного пункта больше, чем у Flash-Lite.
Самый большой разрыв в New Yorker Caption: подбор подписи к карикатуре, где нужно понять контекст и выбрать из вариантов. Decision 1 набрала 79,7%, Luna 68,4%, разница 11,3 процентного пункта. В медицинском тесте PubMedQA результат 79,8% против 74,4% у Luna, а в многоязычном Global-MMLU-Lite 86,0% против 79,6%.
В аудио MMAU и видео Video-MME есть результаты только у неё и у Flash-Lite: 71,8% и 69,1%, обе цифры выше, чем у Flash-Lite.
В Mind2Web Multimodal первое место у TypeSafe Jev с 86,8%, у Decision 1 86,2%, разница 0,6 процентного пункта.
В When2Call разрыв больше: 82,0% у Jev против 79,9%. Тест проверяет, нужно ли вызывать инструмент и когда. Это как раз сценарий, который Google продвигает для агентов, и здесь выиграла специализированная Jev.
И по общей стоимости Decision 1 не самая дешёвая: на 7 общих тестах она обошлась в $0.88, а Jev в $0.68. Формулировка «почти в пять раз дешевле» сравнивает с Flash-Lite ($4.14).
Под таблицей есть примечание: отказы, блокировки безопасностью и запросы, которые модель не смогла обработать, считаются ошибками, а знаменатель — полный тестовый набор.
Google отдельно подчёркивает калибровку вероятностей. По Top-1 ECE (ожидаемой ошибке калибровки) у Decision 1 0,0250, у Jev 0,0494, у Luna 0,0721, у Flash-Lite 0,2104. Ошибка калибровки у Decision 1 примерно на 65% ниже, чем у Luna, и примерно на 88% ниже, чем у Flash-Lite.
Для агентов это особенно важно. Допустим, агент проверяет фрагмент кода на уязвимость. Модель отвечает не просто «есть» или «нет», а даёт вероятность. Если при уверенности 90% она действительно права в девяти случаях из десяти, система может уверенно ставить порог: всё выше порога обрабатывается автоматически, всё ниже отправляется человеку на проверку. С плохо откалиброванной моделью такой порог выбрать трудно.
Многие новые модели выходят только с таблицами тестов. Google также рассказала о четырёх применениях Decisions API в собственных продуктах.
Gemini Notebook: маршрутизация моделей в реальном времени. Это самое интересное применение. Каждый запрос сначала оценивается Decisions API по сложности, и только потом выбирается уровень модели и глубина рассуждений. Простые вопросы уходят к более дешёвой и быстрой модели, сложные рассуждения к сильной. Google говорит, что так задержка обычных запросов снизилась на величину до 40%.
Это совпадает с тем, как сейчас строят агентов. Агент постоянно принимает мелкие решения: какой инструмент вызвать, какую модель использовать, нужен ли человек. Если каждое такое решение отдавать большой генеративной модели, задержка и стоимость растут. Отдельная модель для решений разделяет работу: чёткие решения идут к модели с низкой задержкой, а сложные задачи остаются за универсальной.
Stitch: макет за несколько секунд. В экспериментальной функции Rapid Canvas, новой в Stitch, Decisions API за несколько секунд строит кликабельный макет продуктового флоу. Пользователь меняет его голосом или кликом, и отклик почти мгновенный. Когда направление выбрано, одним действием макет переносится в полный Stitch для доработки. Именно эту функцию показывает демо из поста Sundar Pichai.
CC: выбор эмодзи из более чем 200. Google Labs использует модель в CC, чтобы мгновенно выбрать подходящую реакцию-эмодзи из более чем 200 вариантов, не добавляя задержки в диалог.
Google Search: слой безопасности для инструментов MCP. Внутри Search Decisions API добавляет к инструментам MCP слой проверки безопасности: в пределах бюджета задержки он выявляет враждебное поведение и контент.
API-ключ получают в Google AI Studio, там же есть бесплатный уровень для прототипов. Google выложила три демо-приложения: Doorstep Parcels, Speed Sketch и Find the Zoo Keeper. В документации есть руководства по подключению на Python, JavaScript и REST.
Помимо SDK google-genai, интеграции с OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit и OpenCode появляются одна за другой, а поддержка Gemini в Google Cloud придёт позже.
Все модели списываются по официальным ценам API. Никаких неожиданных списаний, отмена в любой момент.