全部模型
每个模型的 ID、最低档位,以及在 Go、Plus、Pro 上的月额度。
阿里发布闭源旗舰 Qwen4-Max:2.4T 参数每 token 激活 71B,官方 16 项评测拿到 4 项第一,国内缓存命中低至 0.5 元/百万 token。本文整理官方与第三方评测数据、国内与国际价格、两次真实运行的账单对比,以及思考档位与适用场景。
11 月 16 日,阿里发布新一代旗舰模型 Qwen4-Max。它基于新的 Qwen4 混合专家(MoE)架构,主干参数 2.4T,每 token 激活 71B,外加 328B 的 N-gram 词表参数,支持 100 万 token 上下文与原生视觉输入,仅通过云端 API 和官方应用提供。
此前一周,它的早期预览版先在编程工具 Qoder 里以匿名模型身份开放测试,随后升级为 Qwen4-Max-Preview;11 月 16 日官方正式公布完整基准测试、技术架构与 API 定价。下面整理官方评测、第三方榜单、价格和社区实测账单。
结论:Qwen4-Max 的优势在于长周期 Agent 任务、代码仓库修复(DeepSWE 75.7)和低廉的缓存单价(国内 0.5 元/百万、国际 $0.075/百万,Work360 单任务成本较上代降 62%);短板在于终端命令执行(Terminal-Bench 4.0 48.5)、黑盒软件复刻(ProgramBench 31.5)以及高思考档位下的响应速度(Artificial Analysis 每题平均 32.1 分钟)。它适合长上下文、多轮迭代的工程和文档任务;日常调用保持默认的 high 档,复杂全栈和终端编程切到 xhigh。
Qwen4-Max 对稀疏 MoE 架构做了三项调整,用来降低长序列推理开销并减少每步激活的参数量:
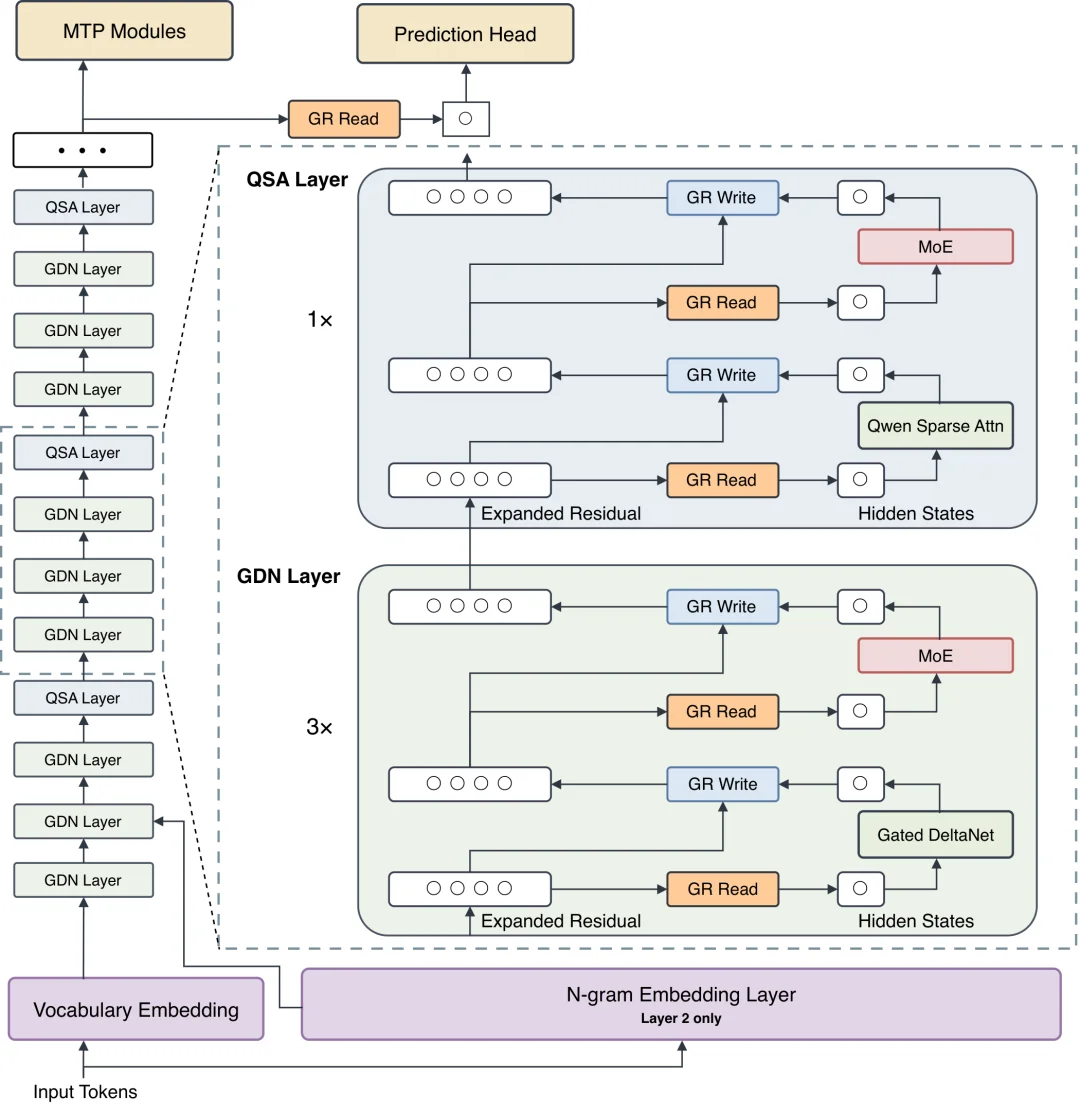
在这套架构下,Qwen4-Max 每 token 激活 71B 参数,比上一代 Qwen3.8-Max(95B)减少约 25%,2.4T 规模预训练全程没有出现 loss 尖峰。在千问内部的知识(Knowledge)、代码(Code)、问答(QA)和 STEM 四类基座评测中,Qwen4-Max-Base 的每字节比特数(BPB,越低越好)在全部 5 个参评 checkpoint 里最低,比 Qwen3.8-Max-Base 下降约 5%–13%。官方脚注同时说明,同场对比的 GLM-5.3 和 Kimi-K3.1-Pro 是后训练 checkpoint,可能影响与 base 模型的直接比较。
正式发布前的一周时间线:11 月 6 日,千问官方 X 账号发帖预告 “The becoming begins.”;11 月 7 日,编程 IDE Qoder 上线匿名模型 Qoduck,个人用户限时免费,匿名的 4 天里每天更新一版;11 月 11 日,Qoder 揭晓该模型并升级为 Qwen4-Max-Preview(该帖浏览量超 540 万);11 月 16 日正式版上线。
目前 Qwen4-Max(模型 ID qwen4-max)已在中国内地的阿里云百炼、千问 AI 平台,以及国际站 QwenCloud 上开放按量 API,同时接入了新加坡区的订阅制 Token Plan;应用侧可在千问办公(QwenWork)、Qoder、千问 APP 和 Qwen Studio 中直接选用。
Qwen4-Max 本身不开源权重。官方博客仅在文末表示“Qwen4 系列的中小尺寸模型将陆续开源”,尚未公布具体参数规模和发布时间。社区在揭晓帖下密集刷屏 “Qwen-4 27B > GTA VI” 催更小模型。
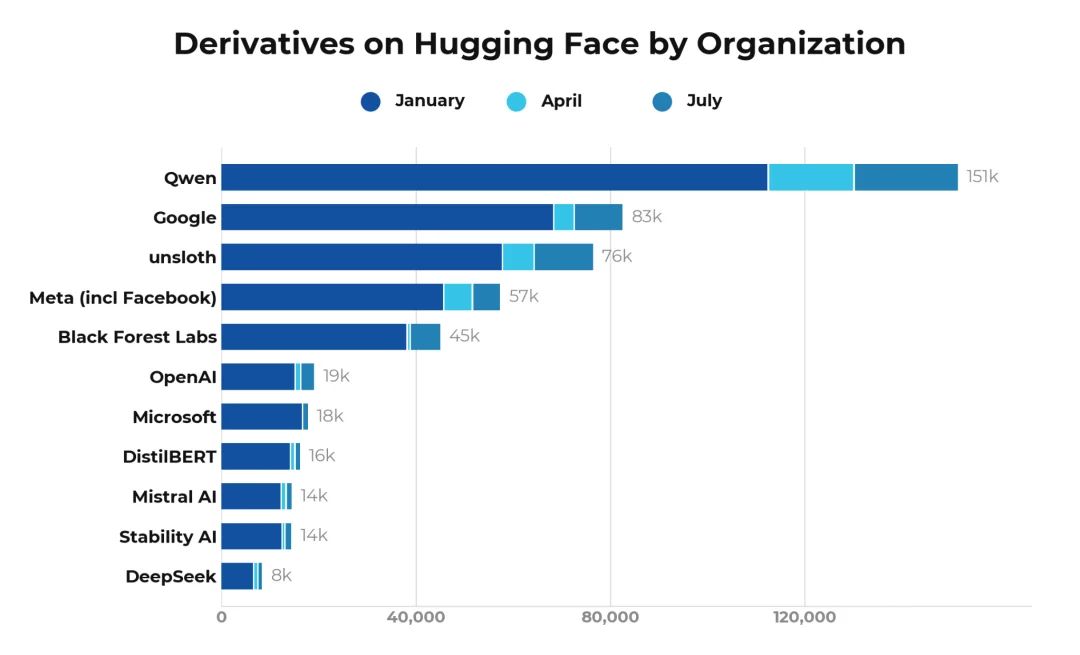
大家盯着小模型,是因为 Qwen 的开源权重一直是本地和服务端部署用得最多的底座。Hugging Face 的 2026 夏季开源模型报告 统计,2026 年 1–8 月 Qwen 在 Hugging Face 上被下载 20.45 亿次(阿里披露的全平台累计数是超 30 亿次);基于 Qwen 的衍生模型有 151,448 个,是 Meta 的 2.6 倍,比 Google(82,506 个)和 Meta 加起来还多。
企业端也有人用。Airbnb CEO Brian Chesky 2025 年 10 月接受采访时说,Airbnb 的 AI 客服大量依赖 Qwen,“很好用,也快、便宜”。
闭源超大杯也并非在所有任务上都优于自家的开源小模型。Hacker News 用户 chriddyp 实测了他们团队的短周期数据分析基准:Qwen4-Max 的得分比今年 8 月开源、可在桌面硬件运行的 Qwen3.8 27B 低了几分,单次成本还略高一点。
千问官方公布了涵盖编程、办公、科研与多模态的 16 项基准测试,同场对比 Qwen3.8-Max-0902、Claude Opus 5.5、GPT-6.1 Sol、GPT-6 Astra 和 Kimi K3.1。
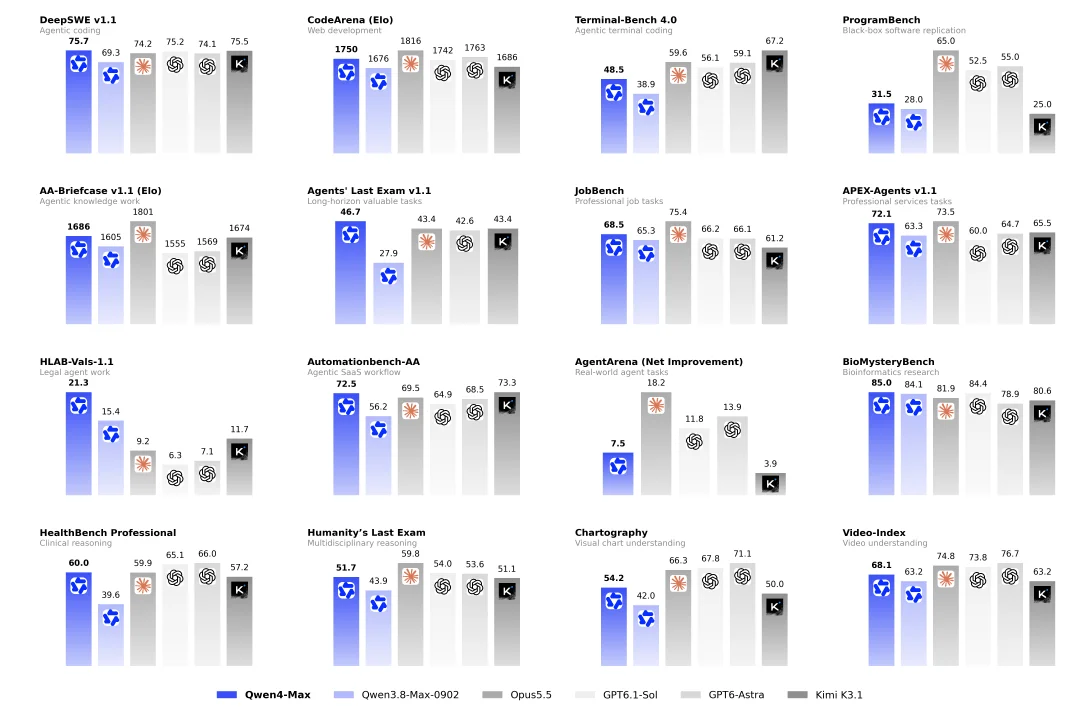
图中 16 项评测的完整数据如下(加粗为该项参评模型最高分):
| 评测项目 | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6(GPT,图中仅一项) | — | 43.4 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | 11.8 | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
千问团队把优势项和落后项画在同一张图里,没有只截取领先的榜单:
在前端双盲评测 CodeArena: WebDev 榜上(2026-11-14 数据,共 159 个模型、超 100 万票),Qwen4-Max (xHigh) 以 1,750 分排在全球第 6,是榜上排名最高的中国模型(下一个中国模型是第 13 名的 Kimi K3.1 Pro,1,686 分)。它排在 GPT-6 Astra(1,763)之后、Claude Fable 5.1(1,743)和 GPT-6.1 Sol(1,742)之前,也高于开 High 档的 Claude Sonnet 5.5(第 10,1,716 分)。同时需要注意两点:一是 Sonnet 5.5 开到 xHigh 档拿到 1,772 分排在第 3;二是 Qwen4-Max 目前只有 1,814 票,榜上标注为 Preliminary(初步成绩),误差区间 ±15,对应名次区间为 3–9。
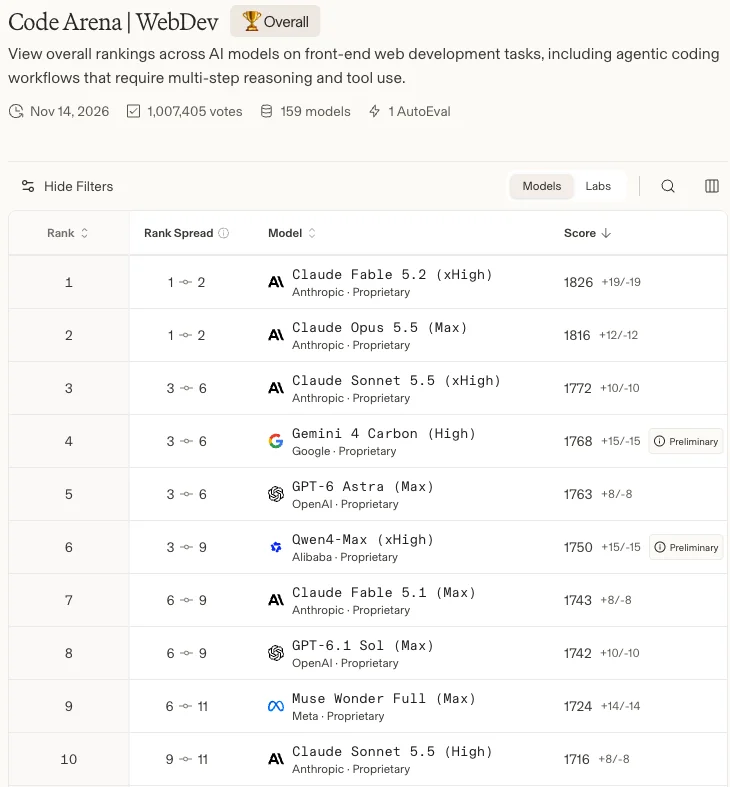
| 名次 | 模型 | Elo 分数 | 备注 |
|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 ±19 | — |
| 2 | Claude Opus 5.5 (Max) | 1816 ±12 | — |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 ±10 | — |
| 4 | Gemini 4 Carbon (High) | 1768 ±15 | Preliminary |
| 5 | GPT-6 Astra (Max) | 1763 ±8 | — |
| 6 | Qwen4-Max (xHigh) | 1750 ±15 | Preliminary;名次区间 3–9;1,814 票;每任务 P50 $4.18 |
| 7 | Claude Fable 5.1 (Max) | 1743 ±8 | — |
| 8 | GPT-6.1 Sol (Max) | 1742 ±10 | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 ±8 | — |
| 13 | Kimi K3.1 Pro (Max) | 1686 ±9 | 下一个中国模型 |
| 16 | Qwen3.8-Max (0902) | 1676 ±6 | 上一代 |
| 19 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 ±7 | 下文 token 用量对比模型 |
第三方独立评测机构 Artificial Analysis 的数据(2026-11-17 抓取)显示:在汇总 9 项测试的 Intelligence Index v5.0.1 中,Qwen4-Max 得分为 43,在 81 个模型里排第 38(可比模型中位数 41)。同场对比里,GPT-6.1 Sol(max)拿到 55 分,平均每道题成本仅 $1.27,比 Qwen4-Max($3.27)高出 12 分且单题便宜 61%;Kimi K3.1 Pro 拿到 46 分,每题成本 $3.68。
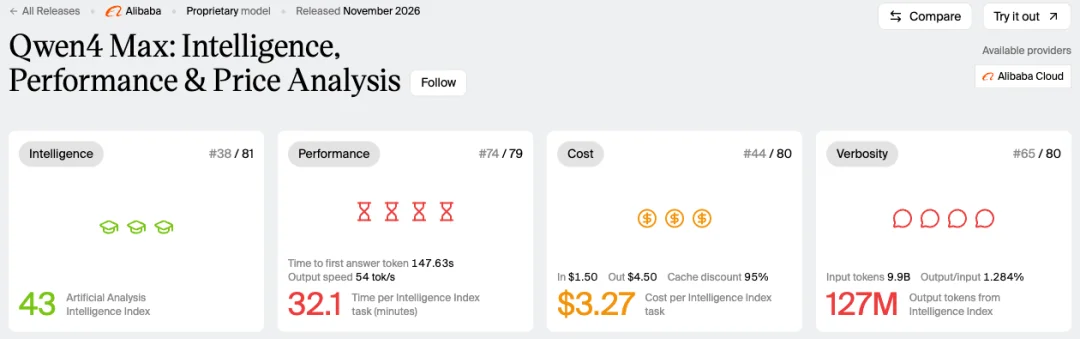
| 模型 | 智能指数 | 每题耗时(分钟) | 每题成本 |
|---|---|---|---|
| Claude Fable 5.2 (max) | 65 | 40.8 | $26.54 |
| Gemini 4 Carbon (high) | 60 | 31.1 | $5.48 |
| Claude Opus 5.5 (max) | 59 | 24.6 | $10.04 |
| GPT-6 Astra (max) | 57 | 20.4 | $6.24 |
| GPT-6.1 Sol (max) | 55 | 23.0 | $1.27 |
| Kimi K3.1 Pro | 46 | 38.8 | $3.68 |
| Qwen4-Max | 43 | 32.1 | $3.27 |
| Grok 4.7 (xhigh) | 35 | 24.6 | $7.77 |
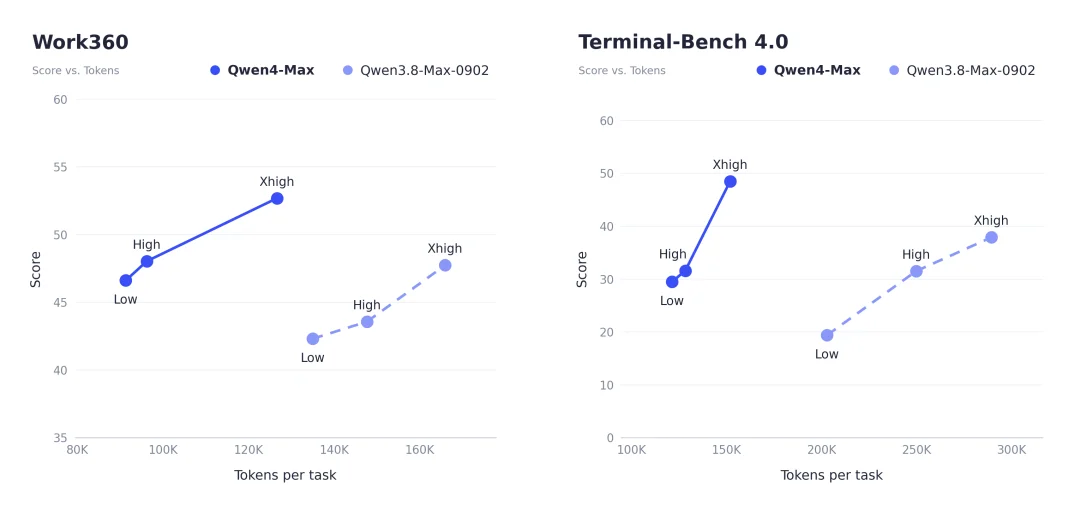
对比上一代 Qwen3.8-Max,官方给出的数据是:在 Work360 评测上,Qwen4-Max 在 xhigh 和 high 档的每任务 token 用量分别下降约 24% 和 35%;在 Terminal-Bench 4.0 上,xhigh 档平均每题消耗从约 289K 降到约 151K(减少约 48%),得分从 38.9 升至 48.5,high 档用量也减少约 49%。
预览版期间,海外开发者也发布了两组同题对比数据:
Qwen4-Max-Preview 与 DeepSeek-v4.1-flash-1017:Qwen 在 87 道题中消耗更少,平均每题约 77K token,DeepSeek 约 115K,少约 33%。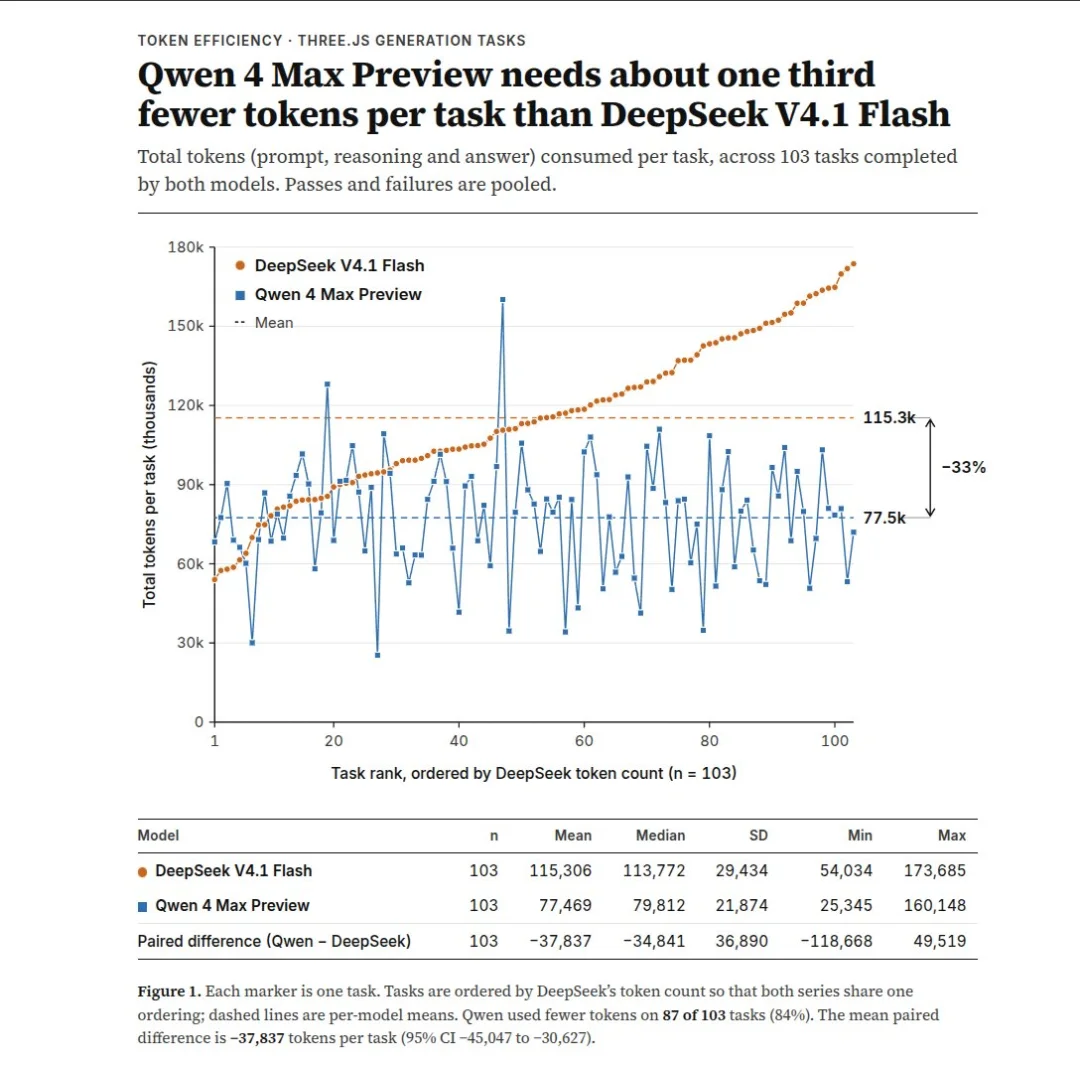
这两组社区测试的对照组都是 DeepSeek V4.1 Flash,且测的都是预览版。虽然 Qwen 每题少用了三分之一到一半的 token,但 DeepSeek V4.1 Flash 的 API 单价只有 $0.15 / $0.60(每百万输入 / 输出 token),输入价是 Qwen4-Max($1.50 / $4.50)的十分之一,输出价约七分之一。@ItsmeAjayKV 在原帖里也写了,算上单价和模型体积,占优的是 deepseek-v4.1-flash。
而在 Artificial Analysis 的横向评测中,Qwen4-Max 跑完整个智能指数共输出了 1.27 亿个 token,高于可比模型的中位数(7,860 万),被标注为 “very verbose”;平均每题耗时 32.1 分钟(中位数 13.3 分钟),首个答案 token 等待时间达 147.63 秒,输出吞吐为 54 tok/s。
| 测试场景 | 对照组 | Qwen4-Max | 对照组数据 | 说明 |
|---|---|---|---|---|
| Work360(xHigh / High) | Qwen3.8-Max-0902 | ≈127K / ≈96K | ≈166K / ≈148K | 比上一代少用约 24% / 35% |
| Terminal-Bench 4.0(xHigh / High) | Qwen3.8-Max-0902 | ≈151K / ≈129K | ≈289K / ≈250K | 比上一代少用约 48% / 49% |
| 103 道 Three.js 生成(预览版) | DeepSeek V4.1 Flash | 77.5K / 题 | 115.3K / 题 | token 少用 33%,但 DeepSeek 单价低一个量级 |
| AA 智能指数总输出与每题耗时 | 同档前沿模型中位数 | 127M / 32.1 分钟 | 78.6M / 13.3 分钟 | AA 标注 “very verbose”,耗时约为中位数的 2.4 倍 |
我们觉得,Qwen4-Max 的 token 缩减是相对自家上一代 Qwen3.8-Max 和 DeepSeek V4.1 Flash 而言;放到全行业前沿模型里横向对比,它在高思考强度下依然偏慢、输出偏长。
根据阿里云百炼文档,Qwen4-Max 的思考强度参数 reasoning_effort 提供 low、high、xhigh 三档(默认 high,默认最大思维链预算 thinking_budget=131072;传入 minimal、medium、max 会分别映射为 low、high、xhigh)。
官方效率图里三个档位在 Work360 和 Terminal-Bench 4.0 上的得分与每题 token 消耗如下:
| 评测基准 | Low | High(正式版默认) | Xhigh | High 与 Xhigh 差距 |
|---|---|---|---|---|
| Work360(综合办公与行业任务) | ≈46.6 分(≈91K) | ≈48.0 分(≈96K) | 52.69 分(≈127K) | High 低约 4.7 分,省约 24% token |
| Terminal-Bench 4.0(终端编程) | ≈29.5 分(≈122K) | ≈31.5 分(≈129K) | 48.5 分(≈151K) | High 低约 17.0 分,仅省约 15% token |
预览版刚上线时默认档位固定在 xhigh,直接拉长了简单任务的响应时间。@SrinivasValekar 转述过一次村庄生成测试:都开 xhigh,Gemini 4 Hydrogen 12 分钟跑完、花了约 $1.7,Qwen4-Max 跑了 1 小时 15 分钟、花了约 $0.9。单次测试,但时间差得很远。
YouTube 频道 The Dark Factory 在 Claude Code 里用 Token Plan 实测 qwen4-max-preview 时,对比了同一道预算 App 题目在不同档位下的表现:把思考强度从默认的 xhigh 直接调到 low 重跑,耗时从 24 分钟降到 9 分钟,上下文读取量从 4.4M 降到 1.1M(减少 75%),输出从 83K 降到 31K(减少 63%),由 Codex(GPT-6.1 Sol)盲评的分数从 8/10 升到 9/10。
| 思考档位 | 输出 token | 读取 token | 耗时 | 盲评得分(GPT-6.1 Sol 裁判) |
|---|---|---|---|---|
| 默认(xHigh) | 83K | 4.4M | 24 分钟 | 8 / 10 |
| low | 31K(-63%) | 1.1M(-75%) | 9 分钟 | 9 / 10 |
The Dark Factory 这组结果来自单次、一道前端应用题、单一 AI 裁判。结合上面的官方曲线,我们觉得正式版默认的 high 档够日常办公、常规前端和问答用;涉及复杂全栈开发或终端命令行 Agent 任务(如 Terminal-Bench 这类场景)时,high 和 xhigh 之间有 17 分的差距,仍需手动切到 xhigh。
在国际站 QwenCloud 的 OpenAI 兼容接口(Responses API)中指定思考档位的最小示例:
from openai import OpenAIimport os client = OpenAI( api_key=os.getenv("DASHSCOPE_API_KEY"), base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",) resp = client.responses.create( model="qwen4-max", input="给这个函数补单元测试", reasoning={"effort": "high"}, # low / high / xhigh,默认 high)print(resp.output_text)官方 API 定价分中国内地(阿里云百炼)与国际(QwenCloud 新加坡)两套。国内标准输入 10 元/百万 token、输出 30 元/百万 token,比上一代 qwen3.8-max(12 / 36 元)下调约 16.7%;缓存命中单价下调至 0.5 元/百万 token(国际站为 $0.075/百万),为标准输入价的 5%。配合单任务 token 消耗的下降,官方 Work360 评测里的单任务平均总成本从上一代的 $4.43 降到了 $1.67,降幅 62%。
| 计费项 | 国内(百炼,中国内地) | 国际(QwenCloud,新加坡) |
|---|---|---|
| 标准输入(0 < token ≤ 1M,思考 / 非思考同价) | 10 元 / 百万 | $1.5 / 百万 |
| 输出(思维链 + 回答) | 30 元 / 百万 | $4.5 / 百万 |
| 缓存命中(显式 / 隐式) | 0.5 元 / 百万 | $0.075 / 百万 |
| 创建显式缓存(5 分钟 TTL) | 12.5 元 / 百万 | $1.875 / 百万 |
| 创建显式缓存(1 小时 TTL) | 20 元 / 百万 | $3 / 百万 |
| 新用户免费额度 | 100 万 token(90 天) | — |
按阿里云百炼计费文档,缓存规则如下:隐式缓存默认开启、无需改代码,但不保证每次请求都命中;显式缓存要求前缀至少 1,024 token,有效期(TTL)可选 5 分钟(默认)或 1 小时,命中后自动续期;缓存仅在同一用户账号的请求之间复用;输出 token(含思维链)一律按原价计费。
拿开发者 @superalesha 公布的 Blender 东京雨夜拉面摊实测用量做重算:他在预览版 xhigh 档下用同一条提示词分别跑了 DeepSeek Harness(DSH)和 Qwen Code 两个框架,按正式版公开单价(费用 = 未命中输入 × 输入单价 + 缓存命中 × 缓存单价 + 输出 × 输出单价)折算如下:
| 运行框架(同题,xHigh) | 总输入(缓存命中 / 未命中) | 输出 | 国内整单(含缓存) | 国内(假设 0 缓存) | 国际整单(含缓存) | 国际(假设 0 缓存) |
|---|---|---|---|---|---|---|
| DeepSeek Harness | 11.96M(11.59M / 0.37M) | 130K | 3.70 + 5.80 + 3.90 = 13.40 元 | 123.50 元 | $2.01 | $18.53 |
| Qwen Code | 3.02M(2.85M / 0.17M) | 62K | 1.70 + 1.43 + 1.86 = 4.99 元 | 32.06 元 | $0.75 | $4.81 |
这张账单反映出三点:
围绕百万上下文、原生视觉和工具调用,官方博客和社区展示了一批长链路任务。
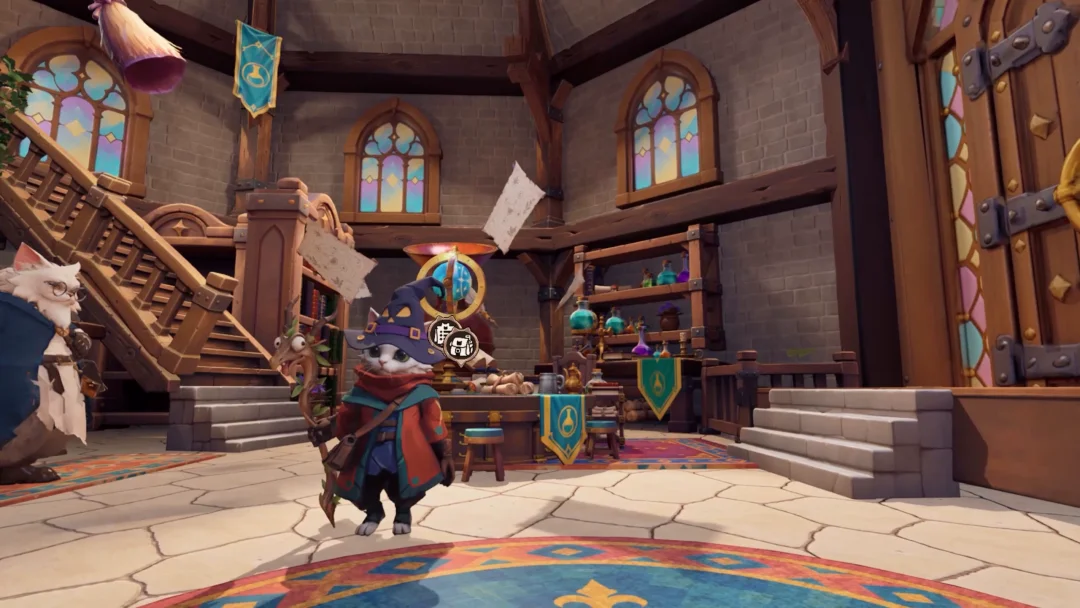
在 3D 与游戏开发上,@superalesha 让模型只通过 Blender MCP 写 Python、不导入任何外部资产,搭一个东京雨夜的拉面摊微缩场景。提示词里列了布帘、纸灯笼、热汤碗、自动售货机、倒映霓虹的积水,要求用 Cycles 渲染,并让模型看渲染图自己找问题返工。千问官方则展示了它在 Unity、Unreal Engine 和 Godot 中从自然语言需求直接搭建场景、编写玩法逻辑、整合外部资产并看着运行画面调优镜头与打击感,做出了 Unreal Engine 下的 3D 猫法师冒险游戏《喵出法随》(Meow of Magic)、御剑穿云的奇幻冒险 Yun Guan Xing,以及 Unity 6 下的安卓赛车手游《Flying Racer》。
针对长周期 Agent 任务容易中途跑偏、等到跑完才发现难以返工的问题,Qwen4-Max 推出了 Live Delivery(持续交付) 机制,并同步开源了配套插件 Qwen-Live-Delivery-Plugin:模型接手复杂任务后先快速交付一个可运行的首版,随后基于执行反馈和用户指令逐版迭代扩展,方便开发者随时介入修正方向。
在工业、金融、法律、医疗与科研领域,官方披露了 6 个合作案例:
| 场景 | 工作内容 | 关键数字 |
|---|---|---|
| 汽车制造(SANF、Pacific Union 产线) | 用 2D 布局图和工艺参数建 3D 产线并做 PLC 虚拟调试;零件级设计车门总成与摩擦轮,生成加工刀路并在上机前仿真排查过切与少切 | 单个工件编程人工投入从约 475 分钟降到 24 分钟(减少约 95%) |
| 企业 IPO 法律尽调 | 清洗客户分批提供的命名混乱底稿,按实质内容重命名归入目录并编索引;交叉核查工商、知识产权、司法与征信记录,识别对赌协议(VAM)中的“恢复条款”隐患 | 整理 198 份底稿归入 14 个目录,交付 86 页、超 6 万字报告,覆盖 12 个审查领域与 14 个法律问题,每条结论带底稿引用 |
| 金融投研(沪深 300 股指期货) | 拉取 A 股、港美股、债券、基金与衍生品数据,结合融资成本、分红率与到期日计算理论期现基差与波动率价差,输出双重溯源的 Excel 与可编辑 PPT | 调用 90 个 MCP 工具;点击 Excel 单元格直达原始数据源,PPT 图表与工作表一一对应 |
| 危重症临床辅助 | 单次对话内通读数十份化验单、万字病程与多组医嘱,将原始影像分为 6 个序列,调度多个子 Agent 并行审阅数百张胸部 CT 切片 | 处理超 1 万字病程与 1,433 张影像,识别双肺背侧实变(与主治医生诊断一致),4 条处置建议与当日医嘱逐条对应 |
| 干湿闭环科研(Deep Principle Mira 平台) | 针对高功率芯片数据中心散热,自主完成结构筛选、MPA 性质预测、第一性原理计算与逆合成分析,直接调度自动化湿实验台配料合成、纯化与测试 | 连续运行 48 小时,筛选 270 万个候选分子,经 4 轮闭环迭代做出经实验验证的新型冷却液实物样品 |
| 云计算资源调度(阿里云 + MindOpt) | 针对数据标注多模型调用调度、GPU 在线分配和 CPU 离线重调度,自主生成候选算法并与阿里自研求解器 MindOpt 协同验证迭代 | 数据标注调度成本平均降 10.42%,在线 GPU 整机空闲时长增加 4.62%,离线 CPU 重调度最优求解速度提升超 14.61 倍 |
以上案例均为阿里与合作方挑选的官方展示场景,目前尚无独立第三方复现,其中的时间缩减和加速比应作为特定工作流打通后的上限参考。
只给一句话直接出静态页面时,社区对比普遍认为 Qwen4-Max 的视觉质感比前沿模型差一截,例如在一组和 GPT-6 Astra、DeepSeek V4.1 Flash 同题的生肖生成对比里,预览版的作品框架完整,但光影和细节质感不足,整体偏平。
用它做前端和交互开发,需要在提示词里把完成标准写清楚,初稿生成后再针对具体配色或动效多轮追改。可以在需求末尾附上这份前端验收清单:
交付前端页面前请逐项自查:1. 视觉层级:排版留白、字号对比和色彩主次清晰,不直接输出未加样式的默认表单控件。2. 交互与状态:所有按钮、筛选、弹窗和表单均能正常触发,补齐悬停反馈、加载态与空数据状态(Empty State)。3. 薄弱点返工:交付前先审视整体完成度,挑出视觉或交互最薄弱的一块再单独打磨一轮。4. 渲染检查:确认页面完整渲染,不留未闭合标签、布局溢出或浏览器控制台报错。按上文的跑分、耗时和账单数据,不同工作负载的选型建议如下:
| 工作负载 / 场景 | 建议 | 理由与代价 |
|---|---|---|
| 多轮长上下文 Agent / 文档与尽调重活 | 适合直接用 | 支持 1M 上下文;ALE(46.7)与法律 HLAB-Vals(21.3)排第一;国内缓存命中仅 0.5 元/百万,Work360 单任务成本降 62%($1.67)。生产环境建议配显式缓存 |
| 真实仓库代码修复与常规全栈开发 | 可用,按难度切档 | DeepSWE v1.1 拿 75.7 分;日常改代码用默认 high 档,遇到复杂全栈或命令行任务需切 xhigh(Terminal-Bench 上两档差 17 分) |
| 重度终端命令执行 / 黑盒软件复刻 | 优先选 Claude 或 Kimi | Terminal-Bench 4.0 仅 48.5(Kimi K3.1 为 67.2,Opus 5.5 为 59.6);ProgramBench 仅 31.5(Opus 5.5 为 65.0) |
| 追求高智能指数且控制单题成本 | 优先看 GPT-6.1 Sol | 在 Artificial Analysis 上,GPT-6.1 Sol (max) 智能指数 55、每题 $1.27;Qwen4-Max 指数 43、每题 $3.27 |
| 一句话生成前端页面 | 需配详细验收清单 | CodeArena WebDev 排第 6(1,750 ±15),但社区对比里一句话直出的作品光影和细节偏平,要写明视觉层级与空状态要求并多轮迭代 |
| 对首字延迟和总耗时敏感 / 需本地部署 | 不适合 | AA 测得首个答案 token 需 147.63 秒、每题平均 32.1 分钟;Max 仅提供闭源 API,开源中小模型尚未公布尺寸与发布日期 |
可以。QwenCloud 的 Token Plan 兼容 OpenAI 和 Anthropic Messages 协议,官方支持列表包含 Claude Code、Cursor、Qwen Code、Codex、Qoder 和 OpenClaw(上文 The Dark Factory 的测试就是在 Claude Code 里跑的)。走 Anthropic Messages 接口时,思考档位用 output_config.effort 传递,medium 会映射为 high,max 映射为 xhigh。需要注意 Token Plan 使用独立接口 token-plan.maas.qwencloudapi.com 和 sk-sp- 开头的专用 Key,不能和按量付费 Key 混用。
国内(阿里云百炼,中国内地)标准输入 10 元/百万 token、输出 30 元/百万、缓存命中 0.5 元/百万,另有 100 万 token 免费额度(90 天内有效);国际站(QwenCloud,新加坡)标准输入 $1.5/百万、输出 $4.5/百万、缓存命中 $0.075/百万(百炼的国际部署范围另有一档 10.938 元 / 32.813 元)。按汇率折算两边单价接近,订阅制的 Token Plan 目前只能在新加坡区购买和使用。
Qwen4-Max 本身不开源,只提供云端 API 和官方应用。千问团队在发布博客中表示,基于同一代架构与训练技术的 Qwen4 系列中小尺寸模型后续会开源,但目前尚未公布具体尺寸和发布日期。