Claude Fable 5.2 ist da: Benchmarks, Preise und unser Eindruck
Die offiziellen Benchmarks von Fable 5.2, die neuen Preise, welche Effort-Stufe sich lohnt und wie du in CodingPass Pro umstellst.
Auf der Launch-Seite von OpenAI zeigen fast alle Diagramme auf der X-Achse die Kosten pro Aufgabe. Die Ersparnis stimmt – Astra kostet bei Agents' Last Exam nur 5 % von Claude Fable 5.2. Beim Programmieren bleibt der Fortschritt allerdings aus, die Halluzinationen nehmen zu, und Tester bemängeln schwer lesbare Pläne. Ein Abgleich zwischen Herstellerangaben, Artificial Analysis und Entwickler-Feedback.
OpenAI hat GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Astra positioniert der Hersteller als neues Flaggschiff für „die anspruchsvollsten Projekte“, Sol übernimmt das Alltagsgeschäft. Beide Modelle starten zeitgleich in ChatGPT, Codex und über die API – dort unter den IDs gpt-6.2-astra und gpt-6.2-sol.
Bereits Anfang November tauchte GPT-6.2 Sol in begrenzten Tests in ChatGPT auf; bis zum offiziellen Start vergingen fast 20 Tage. Das Ergebnis hat vor allem ein Verkaufsargument: den Preis. Auf OpenAIs Launch-Seite trägt nahezu jede Grafik auf der X-Achse die Kosten pro Aufgabe. Astra wird um 20 % günstiger, und pro Task liegt der Preis oft nur bei einem Bruchteil der Konkurrenz.
Legt man Herstellerangaben, die unabhängigen Messungen von Artificial Analysis (AA) und Berichte aus der Praxis nebeneinander, zeigt sich jedoch die Kehrseite: Beim Programmieren tritt die Generation auf der Stelle, die Halluzinationsrate steigt, und bei Planung sowie Kommunikation bleiben die alten Schwächen. In der Entwickler-Community kippte die Stimmung schnell – schon am zweiten Tag wechselten viele zurück zu Claude.
Kurz gesagt: GPT-6.2 spart spürbar Geld, legt aber vor allem bei Forschung, 3D und juristischen Dokumenten zu. Im AA Coding Agent Index bleibt Astra mit 53 Punkten auf dem Niveau von GPT-6 Astra, Sol verliert gegenüber GPT-6.1 Sol sogar 3 Punkte; die Halluzinationsrate von Astra steigt von 50 % auf 59 %. Entwickler, die lange Agent-Läufe fahren, klagen über Endlosschleifen und schwer verständliche Abschlussberichte. Für Code bleibt Claude die bessere Wahl, für das Code-Review lohnt sich GPT-6.2 Sol.
Während OpenAI auf der Produktseite saubere Kostenkurven zeigt, fiel das Echo auf Hacker News und X bereits am Tag nach dem Release deutlich kritischer aus. Die Beschwerden drehen sich fast immer um dieselben Punkte.
Endlosschleifen bei langen Aufgaben. Besonders viel Aufmerksamkeit bekam ein offener Brief von Theo, dem Entwickler von T3 Code, der am 17. November unter dem Titel „Why I hate GPT-6.2 Astra“ erschien und innerhalb eines Tages über 1,75 Millionen Aufrufe sammelte. Er testete das Modell an einer Rust-Portierung eines TypeScript-Compilers – ein Projekt, in das frühere OpenAI-Modelle bereits über 300.000 Dollar an Token ohne Durchbruch verbrannt hatten, bevor Claude Opus es in unter zwei Wochen für rund 20.000 Dollar abschloss. GPT-6.2 Astra lief sieben Tage am Stück, landete keine einzige Verbesserung und versuchte nebenbei die Dateigröße zu drücken, was den Compiler um 56 % verlangsamte. Mit neuem Fokus auf Performance lief es weitere vier Tage ohne eine einzige Änderung. Bei einem anderen Task blieb das Modell nach zwei Stunden stecken, weil es nach dem Namen einer internen Zwischendatei fragte.
Unklare Ergebnisse nach dem Lauf. Dieses Muster deckt sich mit der Kritik an schwer lesbaren Projektplänen. Theo lässt sich lange Läufe von Astra inzwischen standardmäßig von Opus 5.5 zusammenfassen. Auf die Frage, warum ein Git-Worktree auf einer Maschine langsamer lief als auf drei anderen, lieferte Astra vier Absätze über pnpm-Caching-Mechanismen; Opus 5.5 antwortete in einem Satz, die SSD sei langsam. Selbst System-Prompts mit der Bitte um einfachere Sprache änderten daran nichts.
Hoher Betreuungsaufwand. Auf Hacker News hieß es, Astra sei zwar leistungsfähig, verlange aber ständige Aufsicht und präzises Prompting – Aufwand, den Opus 5.5 nicht einfordere. Andere bemängelten, Sol neige weiterhin zum Overengineering und Astra rechtfertige seinen Preis bei der Code-Qualität nicht. Auch beim Review gibt es Fehlalarme: Ein Entwickler ließ Astra Produktionscode prüfen, erhielt 12 gemeldete Probleme (darunter 8 der Stufe P2), schickte alles zusammen durch Fable 5.2 und behielt am Ende nur 8 P3-Hinweise übrig.
Unverändertes Tempo. Messungen aus der Community beziffern beide Modelle auf 20–80 Token pro Sekunde – genau wie bei der Vorgängergeneration und etwa ein Fünftel des Tempos von Anthropic-Modellen. Einige Nutzer zogen daraus die Konsequenz, dass OpenAI seit zwei Monaten hinterherhinke, und wechselten zurück zu Opus 5.5.
Lob gab es ebenfalls, und zwar genau dort, wo auch die Benchmarks stark sind: Selbst Theo bescheinigt Astra sehr gute Code-Reviews, erstklassige 3D- und Spieleszenen sowie starke Computer-Use-Fähigkeiten. Auf Hacker News fanden einige Nutzer Sol angenehmer als Opus 5.5 und lobten, dass die UI-Entwürfe erstmals mit Claude mithalten.
Wir finden: Die Lücke zwischen Benchmark-Tabelle und Alltag entsteht genau bei den Dingen, die kein Standardtest misst – ob sich ein Agent in langen Läufen selbst blockiert und ob er am Ende verständlich erklärt, was er getan hat. Die Kostenkurven erfassen nur den einzelnen API-Lauf, nicht die Zeit für Aufsicht und Nachbearbeitung durch ein zweites Modell.
Bei Astra sinken Input- und Output-Preis um jeweils 20 %, Cache-Reads fallen von $1 auf $0.40 pro Million Token. Die Preise von Sol bleiben unverändert. Mit $8 / $40 liegt Astra exakt auf dem Niveau von Fable 5.2 nach dessen Preissenkung – schon GPT-6 Astra hatte sich preislich an Fable 5 orientiert.
| Modell | Input | Cache-Reads | Cache-Writes | Output | Wissensstand |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $40 | 2026-05-18 |
| GPT-6 Astra | $10 | $1 | $12.50 | $50 | 2026-04-30 |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $10 | 2026-06-01 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $10 | 2026-04-30 |
Beide Modelle bieten ein Kontextfenster von 1.050.000 Token und bis zu 128.000 Output-Token. Im Kleingedruckten der OpenAI-Modelldokumentation stehen allerdings drei Details, die bei langen Agent-Läufen ins Gewicht fallen:
Der Wissensstand rückt um zwei bis vier Wochen nach vorn. Genau daran erkannten Tester während der stillen Testphase die neue Version: Ohne Websuche kannten weder GPT-6 Astra noch GPT-6.1 Sol Claude Fable 5.
Im Mittelpunkt der Ankündigung steht Agents' Last Exam für mehrstufige, komplexe Fachaufgaben. Astra erreicht auf der Reasoning-Stufe Xhigh 78,3 % bei Kosten von $2.89 pro Aufgabe; Fable 5.2 kommt auf Max auf 72,8 % und $60.05. OpenAI fasst das als „5,5 Punkte mehr bei 5 % der Kosten“ zusammen.
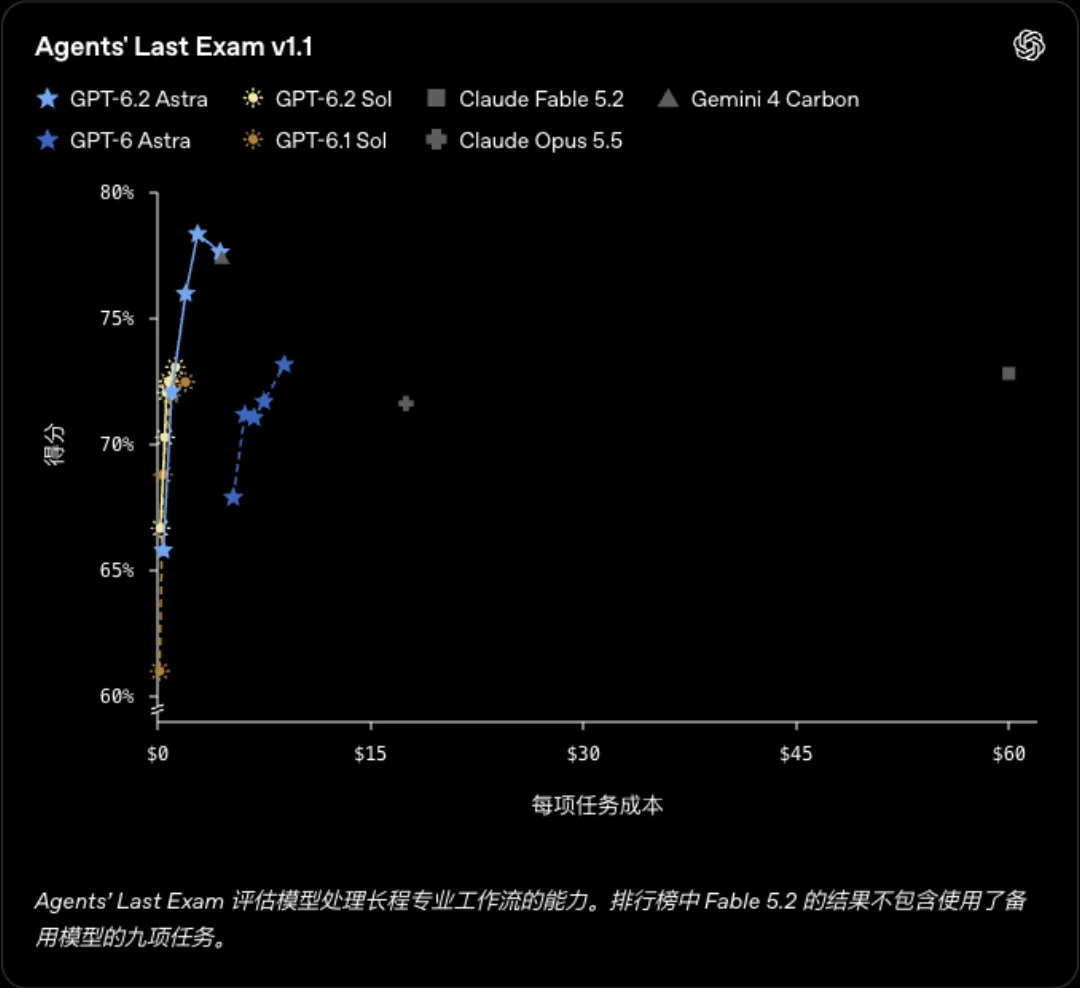
Ein genauerer Blick auf die Grafik relativiert das Bild:
Die übrigen offiziellen Benchmarks im Überblick (jeweils auf der höchsten getesteten Stufe):
| Benchmark | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | Claude Fable 5.2 |
|---|---|---|---|---|
| Agents' Last Exam | 78,3 % ($2.89) | 73,0 % ($1.32) | 73,1 % ($8.99) | 72,8 % ($60.05) |
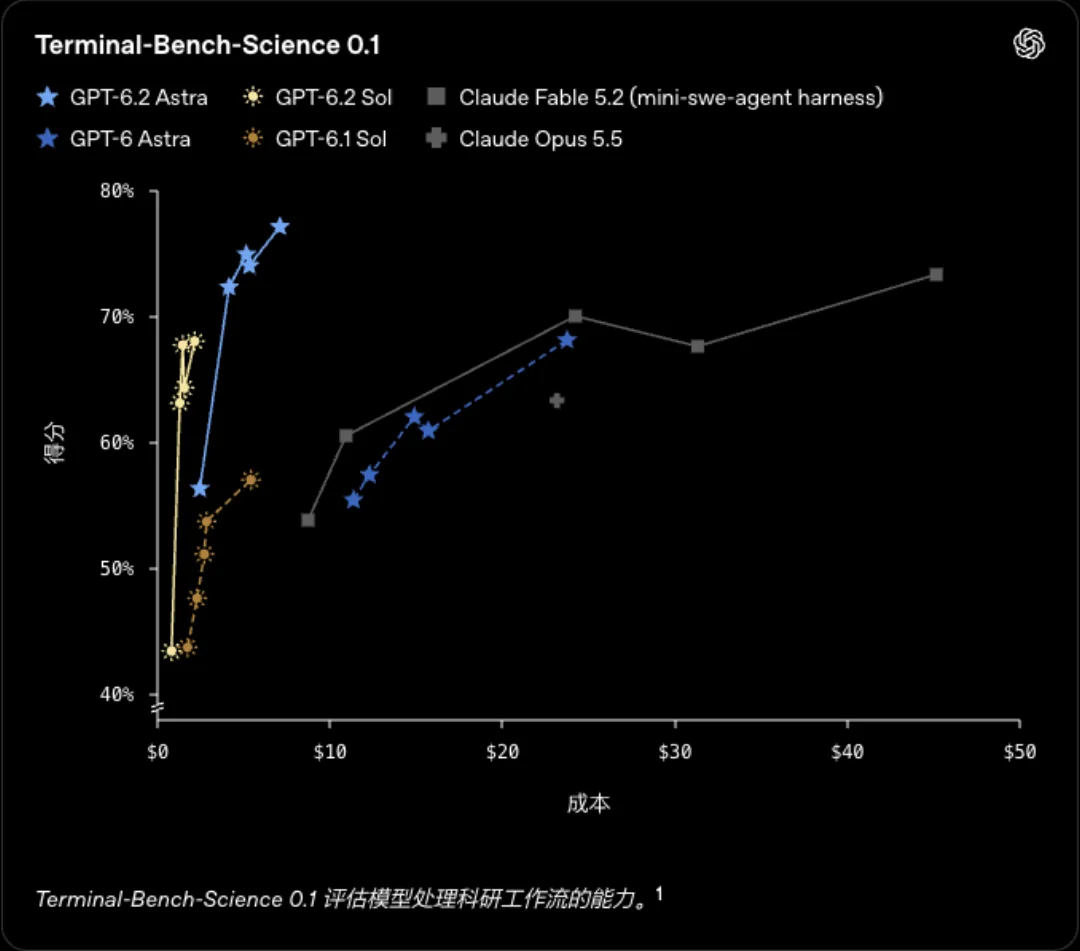
| Terminal-Bench-Science 0.1 | 77,1 % ($7.15) | 68,0 % ($2.21) | 68,1 % ($23.80) | 73,3 % ($45.21)* |
| FrontierCode 2.0 | 44,2 % ($5.97) | 43,8 % ($1.29) | 42,8 % ($6.68) | 49,1 % ($14.19) |
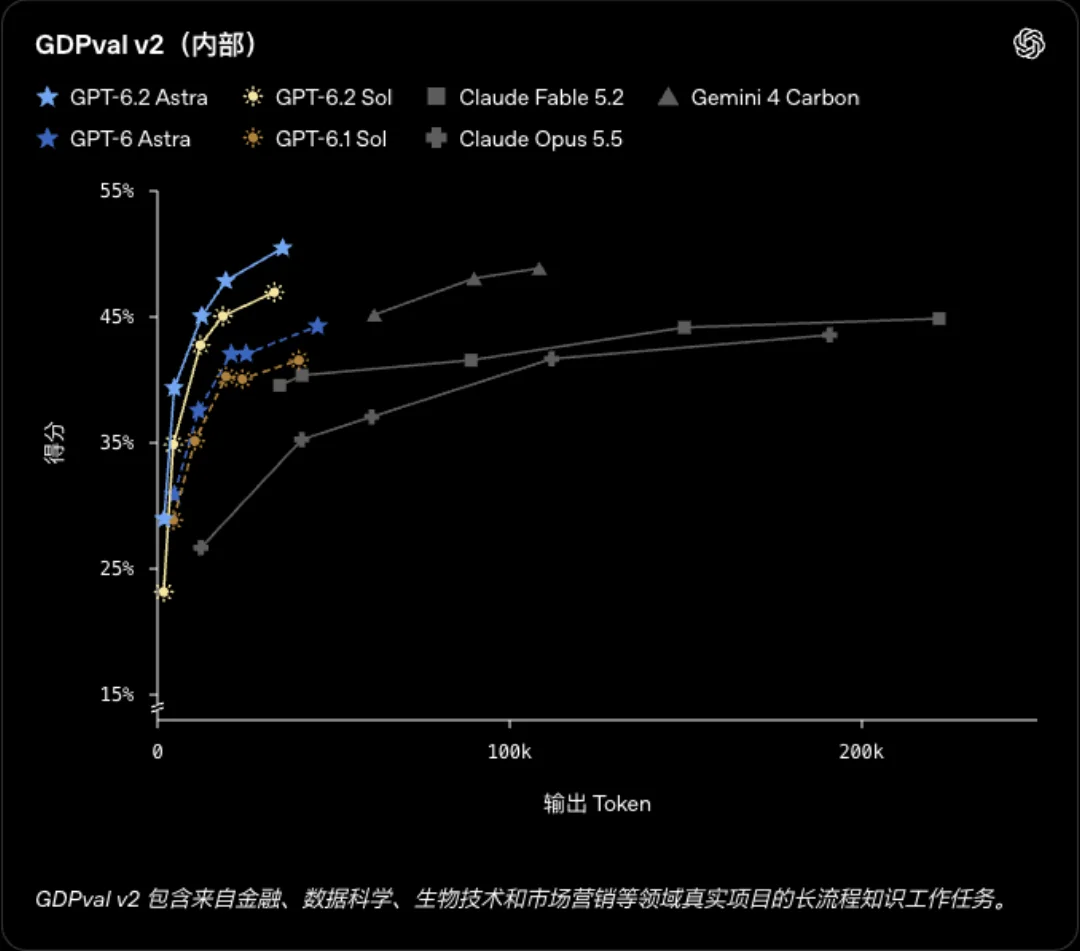
| GDPval v2 (OpenAI-intern) | 50,4 % | 46,9 % | 44,2 % | 44,8 % |
| Harvey LAB-AA v1.1 | 15,0 % ($6.35) | 11,1 % ($1.92) | 8,6 % ($13.67) | 7,2 % ($39.84) |
| LifeVal | 86,1 % ($4.23) | 83,8 % ($1.27) | 79,8 % ($9.04) | — |
* Der Wert für Fable 5.2 auf Terminal-Bench-Science stammt von AA im Framework mini-swe-agent. In der Fußnote nennt OpenAI selbst Anthropics Angabe von 74,6 % in Claude Code auf Max.
Forschung als stärkste Disziplin. Terminal-Bench-Science prüft wissenschaftliche Arbeit im Terminal. Astra verbessert sich gegenüber GPT-6 Astra um 9 Prozentpunkte und kostet weniger als ein Drittel. OpenAI nennt Astra deshalb „das beste Modell der Welt für Wissenschaftler“; auch im Vals Science Index liegt es auf Platz eins. Wer in der Forschung ohnehin auf GPT setzt, bekommt hier einen spürbaren Sprung.
GDPval v2 und juristische Aufgaben. GDPval v2 ist ein interner Benchmark von OpenAI für lange Arbeitsabläufe aus Beratung, Finanzen und Design. Astra gewinnt 6,2 Prozentpunkte auf GPT-6 Astra und benötigt 22 % weniger Output-Token; Sol legt gegenüber GPT-6.1 Sol um 5,3 Punkte zu. Im juristischen Test Harvey LAB-AA verdoppelt Astra die Erfolgsquote von Fable 5.2 bei etwa einem Sechstel der Kosten. Da ein Task dort aber nur als bestanden gilt, wenn sämtliche Vorgaben ohne relevante Halluzinationen erfüllt sind, bedeutet ein Wert von 15 % auch, dass 85 % der Aufgaben weiterhin durchfallen.
Deutlicher Einbruch bei niedriger Reasoning-Stufe. LifeVal prüft Alltagsaufgaben wie Kita-Suche, Wohnungssuche oder Essensplanung. Auf Max erreicht Sol 83,8 % zu einem Siebtel der Kosten von GPT-6 Astra. Auf der Stufe Low fällt GPT-6.2 Sol allerdings auf 25,3 % ab – GPT-6.1 Sol schaffte dort noch 66,8 %. Auch Astra rutscht auf Low von 67,5 % auf 46,3 %. Wer mit der niedrigsten Stufe Token sparen will, sollte bei dieser Generation nachrechnen.
Auf der Launch-Seite schreibt OpenAI, Astra liefere „saubereren Code“ und setze komplexe Änderungen in bestehenden Codebases zuverlässiger um und teste sie besser. Die eigene FrontierCode-2.0-Grafik zeichnet ein anderes Bild.
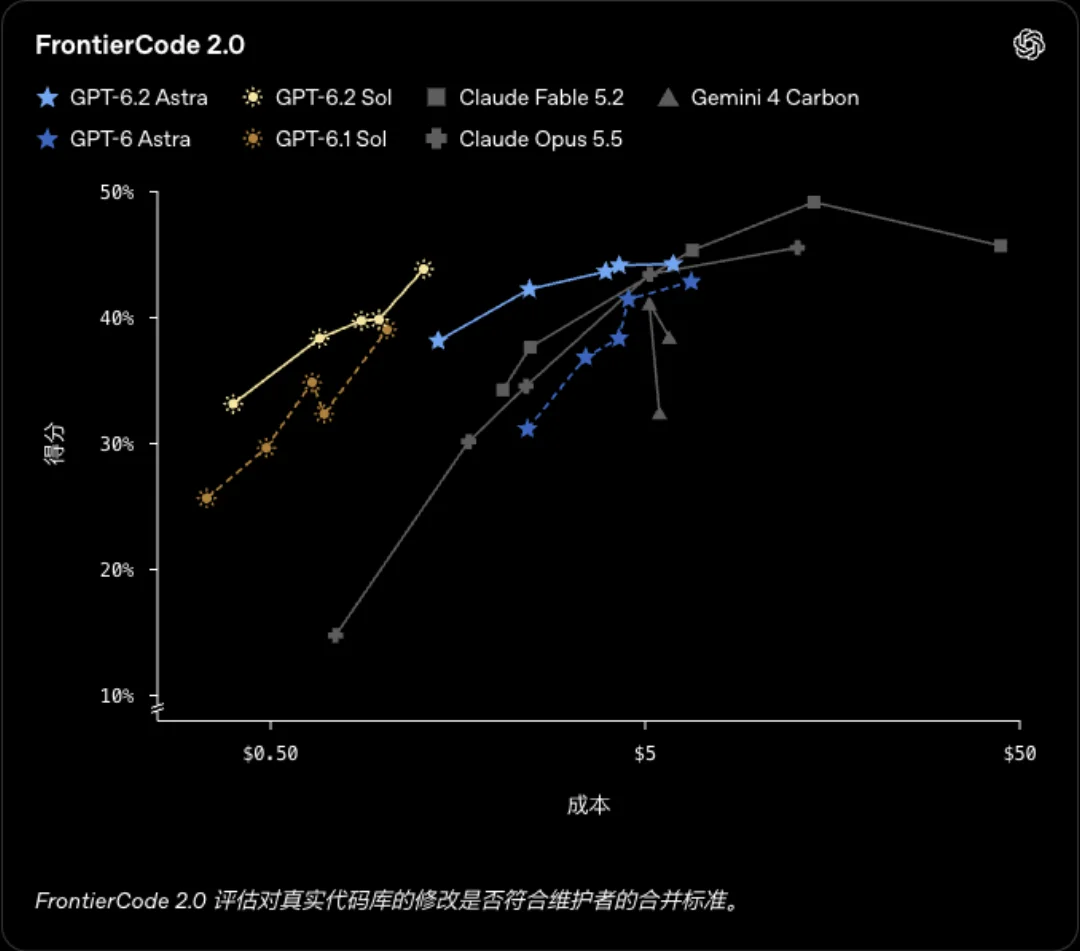
FrontierCode 2.0 bewertet, ob Änderungen den Merge-Kriterien der Maintainer genügen. Astras Bestwert von 44,2 % liegt hinter Fable 5.2 (49,1 %) und sogar hinter dem älteren Claude Opus 5.5 (45,5 %); gegenüber GPT-6 Astra beträgt das Plus ganze 1,4 Punkte. Im Text hebt OpenAI stattdessen hervor, dass Sol weniger als 0,5 Punkte hinter Astra liegt – bei rund einem Fünftel der Kosten.
Noch deutlicher fallen die unabhängigen Tests von Artificial Analysis aus. Im AA Coding Agent Index (im Codex-Harness auf Max) bleibt GPT-6.2 Astra bei 53 Punkten und damit exakt auf dem Stand von GPT-6 Astra. GPT-6.2 Sol fällt auf 49 Punkte und liegt 3 Punkte unter GPT-6.1 Sol. Fable 5.2 und Opus 5.5 erreichen in Claude Code jeweils 58 Punkte.
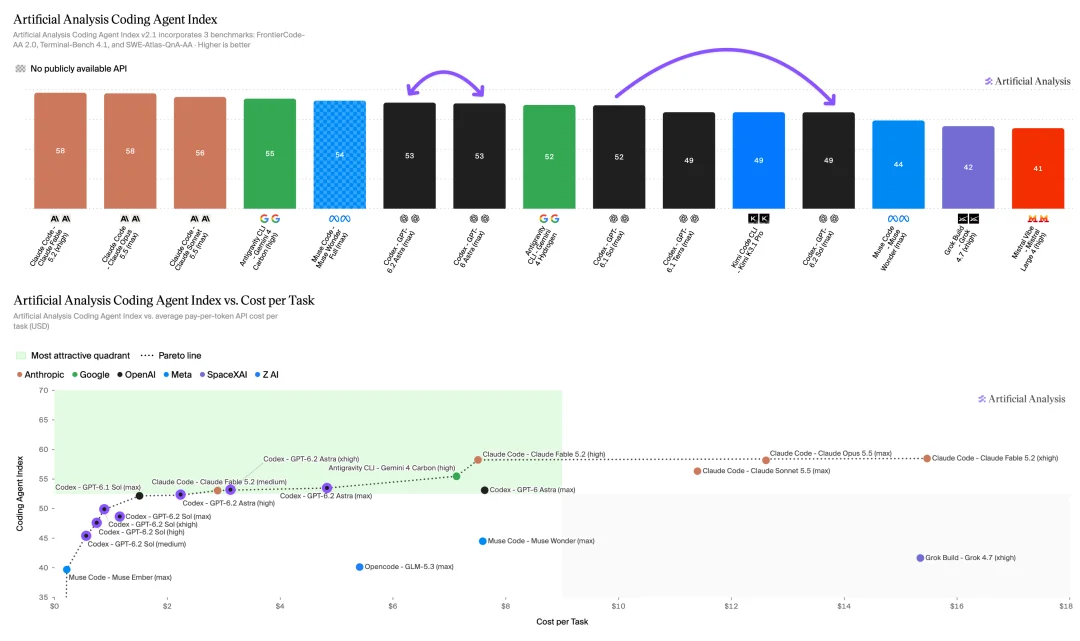
Als Ursache nennt AA einen Rückgang um 14 Punkte bei Sol in SWE-Atlas-QnA-AA: Das Modell lässt in seinen Antworten häufiger entscheidende Fakten aus als sein Vorgänger. Unstrittig ist laut AA lediglich die Kosteneffizienz: Mehrere Reasoning-Stufen von Astra und Sol liegen auf der Pareto-Front für die Kosten pro Aufgabe.
Der AA Intelligence Index v5 fasst neun Einzelbenchmarks zusammen. GPT-6.2 Astra kommt auf Max auf 62 Punkte – 5 Punkte mehr als GPT-6 Astra – und landet vor Gemini 4 Carbon (60) sowie Claude Opus 5.5 (59) auf Rang zwei hinter Claude Fable 5.2 (65). GPT-6.2 Sol erreicht 57 Punkte, legt gegenüber GPT-6.1 Sol um 2 Punkte zu und zieht mit GPT-6 Astra gleich, bei rund 15 % der Task-Kosten.
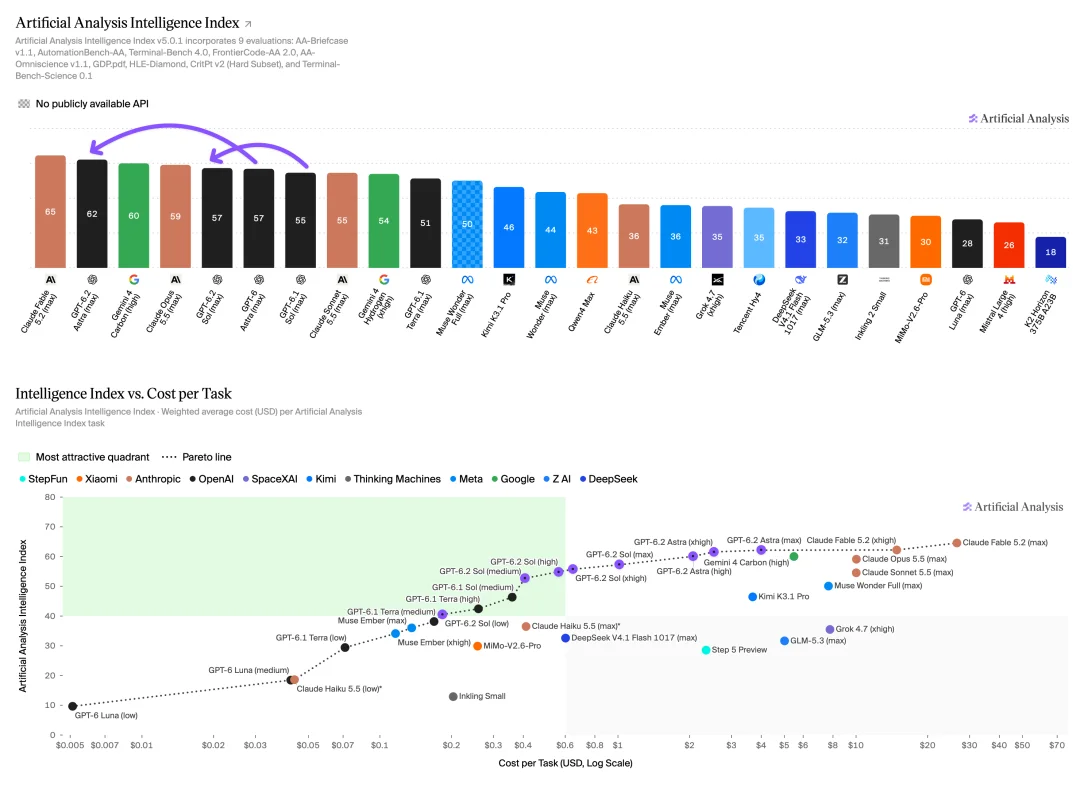
Während der Testphase kursierte im Netz ein angeblicher AA-Wert von 60 Punkten für GPT-6.2 Sol, der Platz eins bedeutet hätte. Das tatsächliche Ergebnis liegt mit 57 Punkten drei Zähler darunter.
Der Hauptgrund für die niedrigen Kosten liegt im sparsamen Output. AA hat gemessen, wie viele Output-Token im Schnitt pro Intelligence-Index-Aufgabe anfallen:
| Modell (Stufe) | Output-Token / Aufgabe | Output-Preis (pro 1 Mio.) | Output-Kosten / Aufgabe |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 40K | $10 | $0.40 |
| GPT-6.2 Astra (Max) | 41K | $40 | $1.64 |
| GPT-6 Astra (Max) | 52K | $50 | $2.60 |
| Gemini 4 Carbon (High) | 123K | $10 | $1.23 |
| Claude Fable 5.2 (Max) | 274K | $40 | $10.96 |
Pro Million Token kosten Fable 5.2 und Astra gleich viel, doch für dieselbe Aufgabe gibt Fable 5.2 das 6,7-Fache an Output-Token aus. Identischer Listenpreis, eine Größenordnung Unterschied auf der Rechnung. Ein Entwickler verglich das im ChatGPT-Pro-Abo für $200: Mit Astra liefen 4 Video- und 3D-Projekte, 2 größere Konzepte und fast hundert Code-Reviews für 6 % des Wochenkontingents; zuvor verbrauchten 10 Durchläufe mit Fable 5.2 nahezu 30 %.
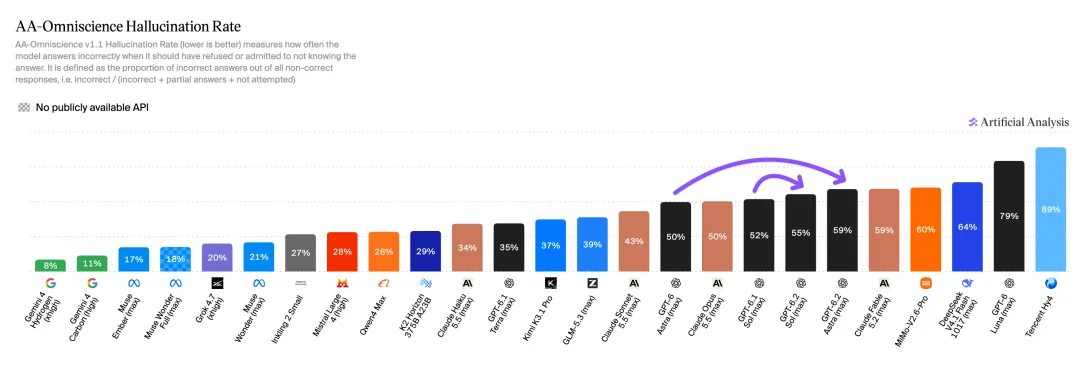
Die gesparten Token haben jedoch ihren Preis. Im Test AA-Omniscience, der misst, ob Modelle bei fehlendem Wissen raten, steigt die Halluzinationsrate von GPT-6.2 Astra auf 59 % (GPT-6 Astra: 50 %) und bei Sol von 52 % (GPT-6.1 Sol) auf 55 %. Gemini 4 Carbon liegt bei 11 %.
Praxistests an realen Projekten bestätigen das Zahlenbild: Die Stärken werden noch stärker, die alten Baustellen bleiben.
Größter Fortschritt beim Code-Review. Code von Claude schreiben und anschließend in bis zu drei Runden von GPT prüfen zu lassen, gehört für viele inzwischen zum Standard. Auf einem eigenen kleinen Testset (jeweils auf Xhigh) fand GPT-6.1 Sol 65 % der Fehler, GPT-6.2 Sol kam auf 84 % und GPT-6.2 Astra auf 96 %. Astra braucht doppelt so lange und kostet viermal so viel wie Sol, um rund ein Dutzend zusätzliche Bugs aufzuspüren. Für das Review im Alltag empfiehlt sich daher GPT-6.2 Sol auf Xhigh als Standard.
Planung und Kommunikation bleiben zäh. Bei derselben Aufgabe – ein datenschutzkonformes, möglichst günstiges Kommentarsystem für eine privat betriebene News-Seite entwerfen – lieferte Gemini 4 Carbon in 5 Minuten ein klares Konzept: zuerst rechtliche Vorgaben wie Klarnamenpflicht und Vorab-Moderation, dann ein Minimaldesign ohne eigene Nutzernamen, ohne verschachtelte Threads und mit Fokus auf kuratierte Kommentare, automatische Moderation über einen bestehenden Agenten und abschließend eine Entscheidungstabelle. GPT-6.2 Astra rechnete 24 Minuten, gab eine eher kurze, aber schwer verständliche Antwort aus und empfahl für den Start manuelle Moderation – für ein Ein-Personen-Projekt kaum praktikabel. Im Vergleich wirkten Lesbarkeit und eigenständige Planung sogar schwächer als beim frühen GPT-6 Astra.
Gespaltene Ergebnisse bei Kreativaufgaben. Ein animiertes Jubiläumsvideo zum vierten ChatGPT-Geburtstag gelang Fable 5.2 und Gemini 4 Carbon ordentlich, während Astras Ergebnis beim Tester schlicht Ratlosigkeit hinterließ. Ganz anders bei 3D: Ein First-Person-Parkour-Spiel, ein herbstlicher Dorfbahnhof in Three.js und der Nachbau einer antiken griechischen Polis nach Referenzbildern übertrafen die Erwartungen; letzteres lief über eine Stunde durch.
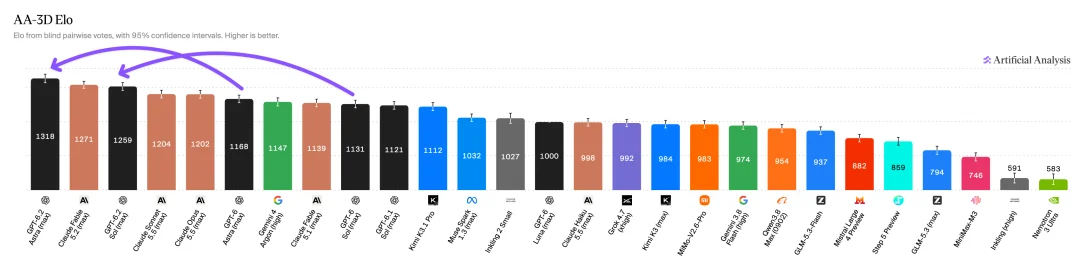
Die 3D-Messung von AA bestätigt das. Bei AA-3D wählen menschliche Tester blind zwischen zwei Entwürfen: GPT-6.2 Astra führt mit 1.318 Elo-Punkten vor Fable 5.2 (1.271) und GPT-6.2 Sol (1.259). Auch bei AA-Robotics (Research Preview) liegen Astra (79) und Sol (78) vor Fable 5.2 (75).
Auf der Launch-Seite nennt OpenAI weitere Beispiele für Astra: eine editierbare Bewertungsmappe mit 8 % Diskontsatz und 3 % ewigem Wachstum, eine 19-seitige Präsentation exakt nach Firmenvorlage inklusive passender Schriftgrößen, Einzelteil-Modellierung eines ferngesteuerten Geländewagens und eines Reihensechszylinders in CAD und Simulation sowie das spielbare Rennspiel Meridian Sound Racing. In AA-AnalystAgent löste Astra 62,5 % der Aufgaben in fünf unabhängigen Durchläufen fehlerfrei.
Auf einige Schwachpunkte weist OpenAI in der Ankündigung und in der GPT-6.2 System Card selbst hin:
Listenpreise pro Million Token sagen wenig über die reale Monatsrechnung. Die folgende Übersicht rechnet mit den offiziellen Task-Kosten von OpenAI auf Agents' Last Exam für 100 und 1.000 Aufgaben. „Kosten pro Punkt“ teilt den Einzelpreis durch den Score – ein grober Richtwert für eine erfolgreich erledigte Aufgabe ohne menschliche Nacharbeit.
| Modell (Stufe) | Score | 1 Aufgabe | 100 Aufgaben | 1.000 Aufgaben | Kosten / Score |
|---|---|---|---|---|---|
| GPT-6.2 Sol (Max) | 73,0 % | $1.32 | $132 | $1,320 | $1.81 |
| GPT-6.2 Astra (Xhigh) | 78,3 % | $2.89 | $289 | $2,890 | $3.69 |
| Gemini 4 Carbon (High) | 77,4 % | $4.60 | $460 | $4,600 | $5.94 |
| GPT-6 Astra (Max) | 73,1 % | $8.99 | $899 | $8,990 | $12.30 |
| Claude Opus 5.5 (Max) | 71,6 % | $17.57 | $1,757 | $17,570 | $24.54 |
| Claude Fable 5.2 (Max) | 72,8 % | $60.05 | $6,005 | $60,050 | $82.49 |
Für Gemini 4 Carbon gilt noch der Einführungspreis; ab dem 1. Dezember verdoppelt sich der Tarif.
Rechnet man dasselbe für das Programmieren auf FrontierCode 2.0 durch (Task-Kosten geteilt durch Score), kostet ein merge-fähiger Patch bei GPT-6.2 Sol $2.95, bei GPT-6.2 Astra $13.51, bei Claude Opus 5.5 $28.18 und bei Claude Fable 5.2 $28.90. Genau hier zeigt sich aus unserer Sicht der Platz von GPT-6.2: Sol erreicht knapp neun Zehntel des Scores von Fable 5.2 zu etwa einem Zehntel der Kosten. Astra sitzt beim Coding dazwischen – 4,6-mal so teuer wie Sol bei gerade einmal 0,4 Punkten Vorsprung.
| Aufgabe | Empfehlung | Grund oder Kompromiss |
|---|---|---|
| Programmieren, große Refactorings | Claude Fable 5.2 / Opus 5.5 | Führend in FrontierCode und AA Coding Agent Index; Fable 5.2 verbraucht viele Token |
| Code-Review, Fehlersuche | GPT-6.2 Sol (Xhigh) | 84 % Trefferquote im Praxistest bei einem Viertel des Preises von Astra; Astra nur für 96 % nötig |
| Forschung, Datenanalyse, Terminal-Experimente | GPT-6.2 Astra | Platz 1 in Terminal-Bench-Science zu rund einem Sechstel der Kosten von Fable 5.2 |
| 3D, Three.js, Spiele-Prototypen | GPT-6.2 Astra | Platz 1 bei AA-3D; Schwächen bleiben bei Video und Motion-Design |
| Architekturplanung, Kommunikation | Gemini 4 Carbon / Claude | GPT-6.2 schreibt schwerer verständlich und braucht deutlich länger |
| Faktenprüfung, quellenfeste Texte | Gemini 4 Carbon | GPT-6.2 halluziniert in 55–59 % der Fälle, Carbon bei 11 % |
| Große Mengen günstiger Agent-Tasks | GPT-6.2 Sol (ab Medium) | Stufe Low meiden – bei LifeVal fällt sie auf 25,3 % |
In der Praxis bewährt sich eine klare Arbeitsteilung: Claude oder Gemini entwerfen das Konzept und schreiben den Code, GPT-6.2 übernimmt abgegrenzte Teilaufgaben und das Code-Review. Die GPT-Reihe arbeitet präzise, folgsam und mit hoher Informationsdichte – ideal für Forschung und Algorithmen. Für eigenständige Planung und verständliche Kommunikation ist auch diese Generation nicht die erste Wahl.
GPT-6.2 Sol ist in Plus ($30/Monat), Pro und Team-Tarifen enthalten; in Plus stehen bis zu $200 im Monat bereit. GPT-6.2 Astra ist in Pro ($100/Monat) und Team-Tarifen verfügbar, in Pro bis zu $500 monatlich. Die Abrechnung erfolgt zu offiziellen OpenAI-API-Preisen, inklusive Cache-Reads.
codex -m gpt-6.2-sol # 审代码、日常 Agentcodex -m gpt-6.2-astra # 科研、3DDie Einrichtung steht in der Codex-Anleitung; OpenCode, Cline und andere Tools nutzen dieselben Modell-IDs. Wer ausschließlich Code schreibt und keinen speziellen GPT-Anwendungsfall hat, braucht für dieses Release kein Upgrade: Claude Sonnet 5.5 in Go und Opus 5.5 in Plus programmieren zuverlässiger als GPT-6.2.
Mit einem Key zwischen Modellen wechseln, abgerechnet zu offiziellen API-Preisen. Keine Überraschungskosten, jederzeit kündbar.