Alle Modelle
Die ID jedes Modells, der Mindesttarif und das Monatskontingent in Go, Plus und Pro.
Tencent Hunyuan destilliert Hy4 flash aus Hy4: Input kostet ein Zwölftel, Output ein Neuntel, und Büroaufgaben wie Präsentationen, Dokumente oder Tabellen liegen bei rund CNY 0.2 pro Aufgabe. Bei den Coding-Benchmarks im Anhang bricht das Modell jedoch ein – für lange Softwareprojekte bleibt Hy4 nötig. Alle Testergebnisse, Blindtest-Zahlen, Traffic-Rechnungen und Setup-Details im Überblick.
Am 16. November hat Tencent Hunyuan Hy4 flash vorgestellt – laut Hersteller das „bisher kosteneffizienteste Hy-Modell“. Die kompakte Variante von Hy4 kommt auf 224B Gesamtparameter (darunter 64B Engram-Parameter), aktiviert pro Token aber nur 12B Parameter, verarbeitet Text und Bilder nativ und unterstützt ein Kontextfenster von 1 Million Token. Per API kostet eine Million Token CNY 0.5 im Input, CNY 2 im Output und CNY 0.02 bei Cache-Hits; die Modellgewichte stehen gleichzeitig offen bereit.
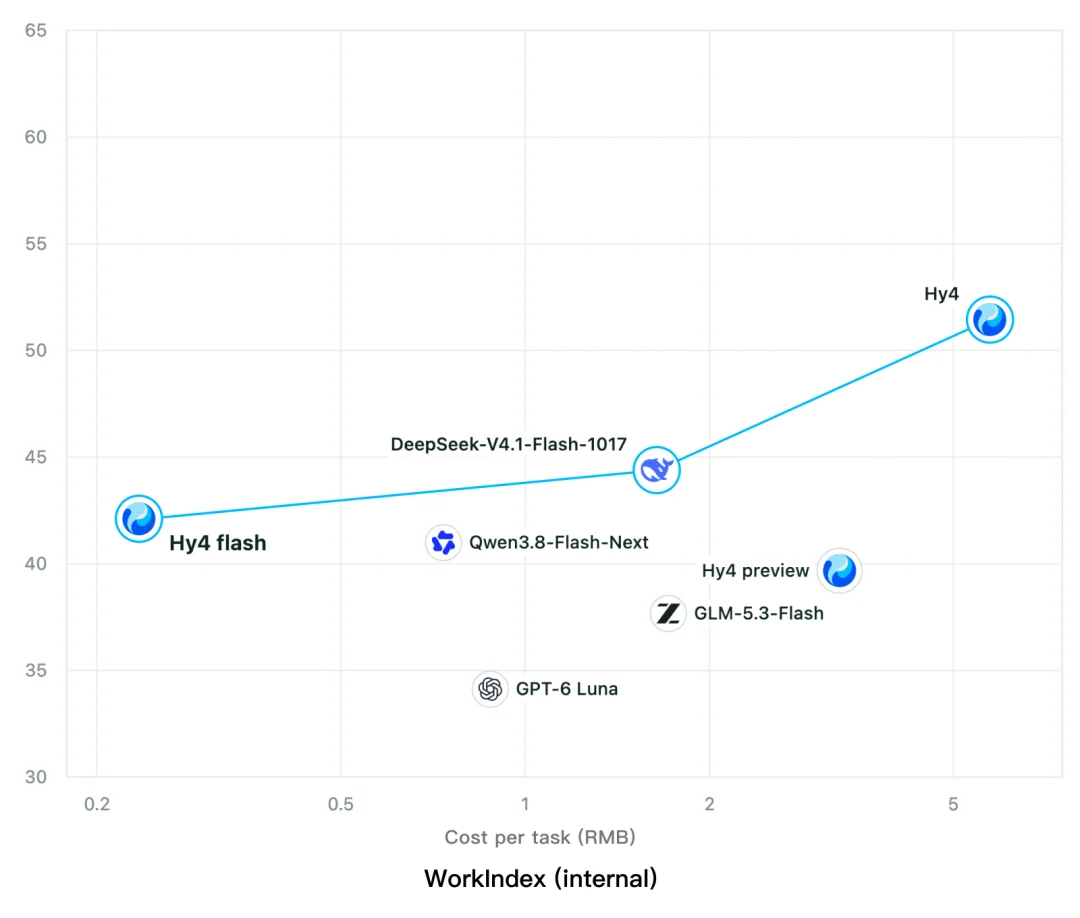
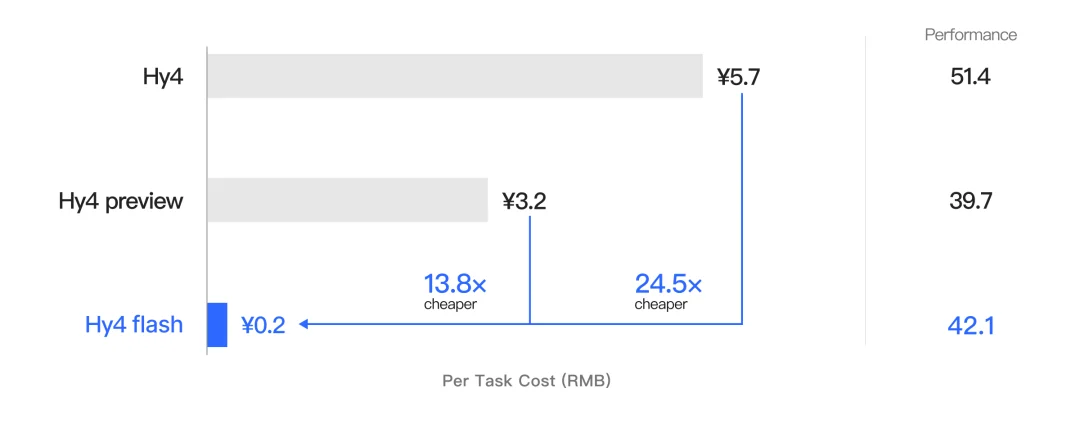
Statt auf öffentliche Ranglisten setzt Tencent bei der Präsentation vor allem auf den eigenen Benchmark WorkIndex. Bei typischen Büroaufgaben rund um Präsentationen, Dokumente und Tabellen erreicht Hy4 flash 42.1 Punkte und liegt damit leicht über Hy4 preview (39.7). Die Kosten pro Aufgabe sinken auf CNY 0.2 – bei Hy4 werden CNY 5.7 fällig.
Kurz gesagt: Für alltägliche Agent-Aufgaben wie Dokumente, Präsentationen, Recherche oder einfache Webseiten bietet Hy4 flash den niedrigsten Listenpreis im Vergleichsfeld. Umgerechnet auf das reale Traffic-Profil von CodingPass kostet eine Anfrage rund CNY 0.0064 – etwa ein Zwölftel von Hy4 und drei Zehntel von DeepSeek-V4.1-Flash in der Spitzenzeit. Für Softwareentwicklung taugt das Modell jedoch nicht: Im Anhang erreicht es bei Terminal-Bench 4.0 nur 19.2 Punkte (Hy4: 44.4, DeepSeek-V4.1-Flash: 40.0) und bei ProgramBench 16.0 (Hy4: 30.0). Selbst Tencent empfiehlt für langlaufendes Software-Engineering weiterhin Hy4.
Die niedrigen Betriebskosten beginnen bei der Architektur. Hy4 flash kombiniert Hybrid-Attention, LatentMoE und Engram und drückt den KV-Cache damit auf ein Vierundzwanzigstel von Hy3 bzw. ein Sechstel von Hy4. Laut Tencent wurden diese Änderungen vor dem Pretraining über umfangreiche Scaling-Ladder-Experimente abgesichert.
Das Post-Training läuft zweistufig: Zunächst destilliert Tencent das Modell aus Hy4 selbst (Self-Distillation), um die allgemeinen Fähigkeiten zu sichern; anschließend halbiert Reinforcement Learning die durchschnittliche Output-Länge bei End-to-End-Aufgaben um 50%. Auf Seite der Inferenz sorgen Megakernels, 4-Bit-Quantisierung und spekulatives Decoding über DFly2 für über 150 Token pro Sekunde.
Das offizielle README auf GitHub schlüsselt den Aufbau im Detail auf:
| Merkmal | Hy4 flash |
|---|---|
| Gesamtparameter | Backbone 155.5B + Engram 63.5B + Vision-Encoder 0.43B + DFly2 0.85B, zusammen rund 220B |
| Aktiv pro Token | Text 11.3B + Vision 0.43B |
| Schichten | 42 Schichten: 1 Dense-Schicht + 41 MoE-Schichten |
| Experten | Pro Schicht 512 geroutete Experten, davon 16 aktiv pro Token, plus 1 geteilter Experte; Berechnung im niedrigdimensionalen Latent-Space (LatentMoE) |
| Attention | Sparse Attention (IndexPool, wählt maximal 2,048 Positionen) im Wechsel 1:3 mit Sliding-Window-Attention (Fenster 512 Token) |
| Engram | Multi-Head-Hash-Lookup für gelernte Bigramm- und Trigramm-Repräsentationen in den Schichten 1, 11, 21 und 31 (ab 0 gezählt) |
| Vision-Encoder | Abgeleitet von SigLIP2-So400m, per MLP an das Backbone gekoppelt |
| Spekulatives Decoding | Integrierter 5-Schicht-Drafter DFly2; teilt KV-Cache und Sparse-Indizes des Hauptmodells ohne zusätzlichen KV-Speicherbedarf |
| Kontextfenster | 1,048,576 Token |
Kleine Unstimmigkeit in den Herstellerangaben: Der Blogpost nennt 224B Gesamtparameter, 64B Engram-Parameter und 12B aktive Parameter pro Token, während sich die Einzelposten im README auf rund 220B, 63.5B bzw. 11.7B summieren. Eine Erklärung dafür liefert Tencent nicht.
Hy4 flash ist bereits über Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima und Marvis verfügbar; eine Anbindung an OpenRouter ist angekündigt.
| Modell (CNY / Mio. Token) | Input (Cache-Hit) | Input | Output |
|---|---|---|---|
| Hy4 flash | 0.02 | 0.5 | 2 |
| Hy4 | 0.3 | 6 | 18 |
| DeepSeek-V4.1-Flash (Spitzenzeiten) | 0.04 | 2 | 8 |
| DeepSeek-V4.1-Flash (Nebenzeiten) | 0.02 | 1 | 4 |
| GLM-5.3-Flash | 0.23 | 0.8 | 2.8 |
Gegenüber Hy4 fällt der Input-Preis auf ein Zwölftel, der Output-Preis auf ein Neuntel und der Preis für Cache-Hits auf ein Fünfzehntel. Bis zum 30. November gewährt Tencent Cloud TokenHub zusätzlich 50% Rabatt auf die API; in WorkBuddy ist die Nutzung zeitweise kostenlos.
Als Vergleichsbasis für DeepSeek-V4.1-Flash zieht Tencent den Tarif der Spitzenzeiten heran (werktags 01:00–04:00 Uhr und 06:00–10:00 Uhr UTC, was 09:00–12:00 Uhr und 14:00–18:00 Uhr Pekinger Zeit entspricht). Laut der DeepSeek-Preisseite gilt in den Nebenzeiten der halbe Preis: Cache-Hits kosten dann ebenfalls CNY 0.02 wie bei Hy4 flash, regulärer Input und Output bleiben allerdings doppelt so teuer. Die Werte für GLM-5.3-Flash stammen von der Zhipu-Preisseite.
Rechnet man die Tarife auf das reale Traffic-Profil von CodingPass um, zeigt sich der Effekt deutlich. Eine typische Agent-Anfrage umfasst rund 100,000 Token, die sich zu etwa 5% auf neuen Input, 1% auf Output und 94% auf Cache-Reads verteilen:
Kosten pro Anfrage = 5K × Input-Preis + 94K × Cache-Hit-Preis + 1K × Output-PreisHy4 flash = 0.0025 + 0.00188 + 0.002 = CNY 0.00638| Modell | Pro Anfrage (CNY) | 10K / Monat (CNY) | 100K / Monat (CNY) | 1M / Monat (CNY) |
|---|---|---|---|---|
| Hy4 flash | 0.0064 | 64 | 638 | 6,380 |
| DeepSeek-V4.1-Flash (Nebenzeiten) | 0.0109 | 109 | 1,088 | 10,880 |
| DeepSeek-V4.1-Flash (Spitzenzeiten) | 0.0218 | 218 | 2,176 | 21,760 |
| GLM-5.3-Flash | 0.0284 | 284 | 2,842 | 28,420 |
| Hy4 | 0.0762 | 762 | 7,620 | 76,200 |
Da über 90% aller Token aus dem Cache gelesen werden, entscheidet vor allem der Cache-Hit-Preis über die Gesamtrechnung. GLM-5.3-Flash wirkt bei Input und Output günstig, verlangt für Cache-Hits aber CNY 0.23 – das 11.5-Fache von Hy4 flash – und landet in dieser Kalkulation sogar über dem Spitzenzeiten-Tarif von DeepSeek.
Die Tabelle unterstellt denselben Token-Verbrauch pro Modell. Falls Hy4 flash seine Output-Länge im Produktivbetrieb tatsächlich halbiert und mit weniger Runden auskommt, wächst der Abstand weiter. Umgekehrt gilt: Misslingt der erste Versuch und erfordert Nacharbeit, zählt am Ende der Quotient aus Einzelkosten und Erfolgsquote im ersten Durchlauf.
Tencent veröffentlicht zwei Testreihen. Die erste ist der interne Benchmark WorkIndex auf Basis typischer WorkBuddy-Aufgaben, kombiniert mit menschlicher Bewertung von Ergebnisqualität, Output-Länge pro Runde und Durchlaufzeit. Er umfasst acht interne Disziplinen: Präsentationserstellung, Präsentationsüberarbeitung, Co-Writing von Präsentationen, Markdown-Co-Writing, Dokumentbearbeitung, Tabellenreparatur, Audio-/Videoverarbeitung und visuelles Verständnis. Die zweite Testreihe bündelt sieben öffentliche Agent-Benchmarks: DeepSWE, ProgramBench, Terminal-Bench 4.0, APEX-Agents, AutomationBench, HLE und OSWorld 2.1. Beide Streudiagramme tragen auf der X-Achse die Kosten pro Aufgabe in CNY (logarithmisch). Auf WorkIndex sitzt Hy4 flash ganz links, rund zwei Punkte hinter DeepSeek-V4.1-Flash:
Bei den sieben öffentlichen Agent-Benchmarks öffnet sich die Schere deutlich stärker:
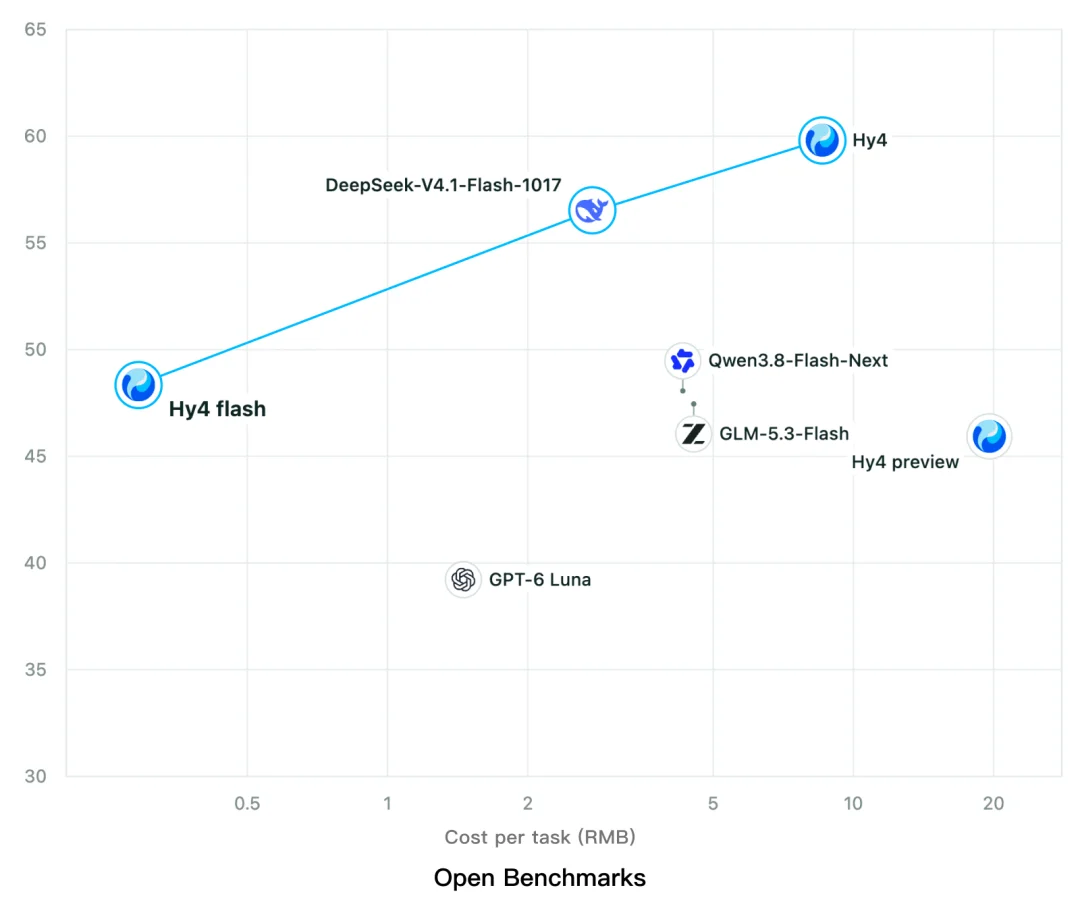
Hier liegt Hy4 flash punktgleich mit Qwen3.8-Flash-Next und GLM-5.3-Flash, rund acht Punkte hinter DeepSeek-V4.1-Flash, kostet pro Aufgabe aber etwa eine Größenordnung weniger.
Im Fazit stützt sich Tencent auf WorkIndex: Hy4 flash schneide etwas besser ab als Hy4 preview und koste pro Aufgabe nur ein Dreizehntel von Hy4 preview, ein Zwanzigstel von Hy4 und ein Achtel von DeepSeek-V4.1-Flash-1017 (Max-Stufe, Spitzenzeiten).
Der Anhang liefert die Einzelwerte aller 17 Tests samt Kosten pro Aufgabe:
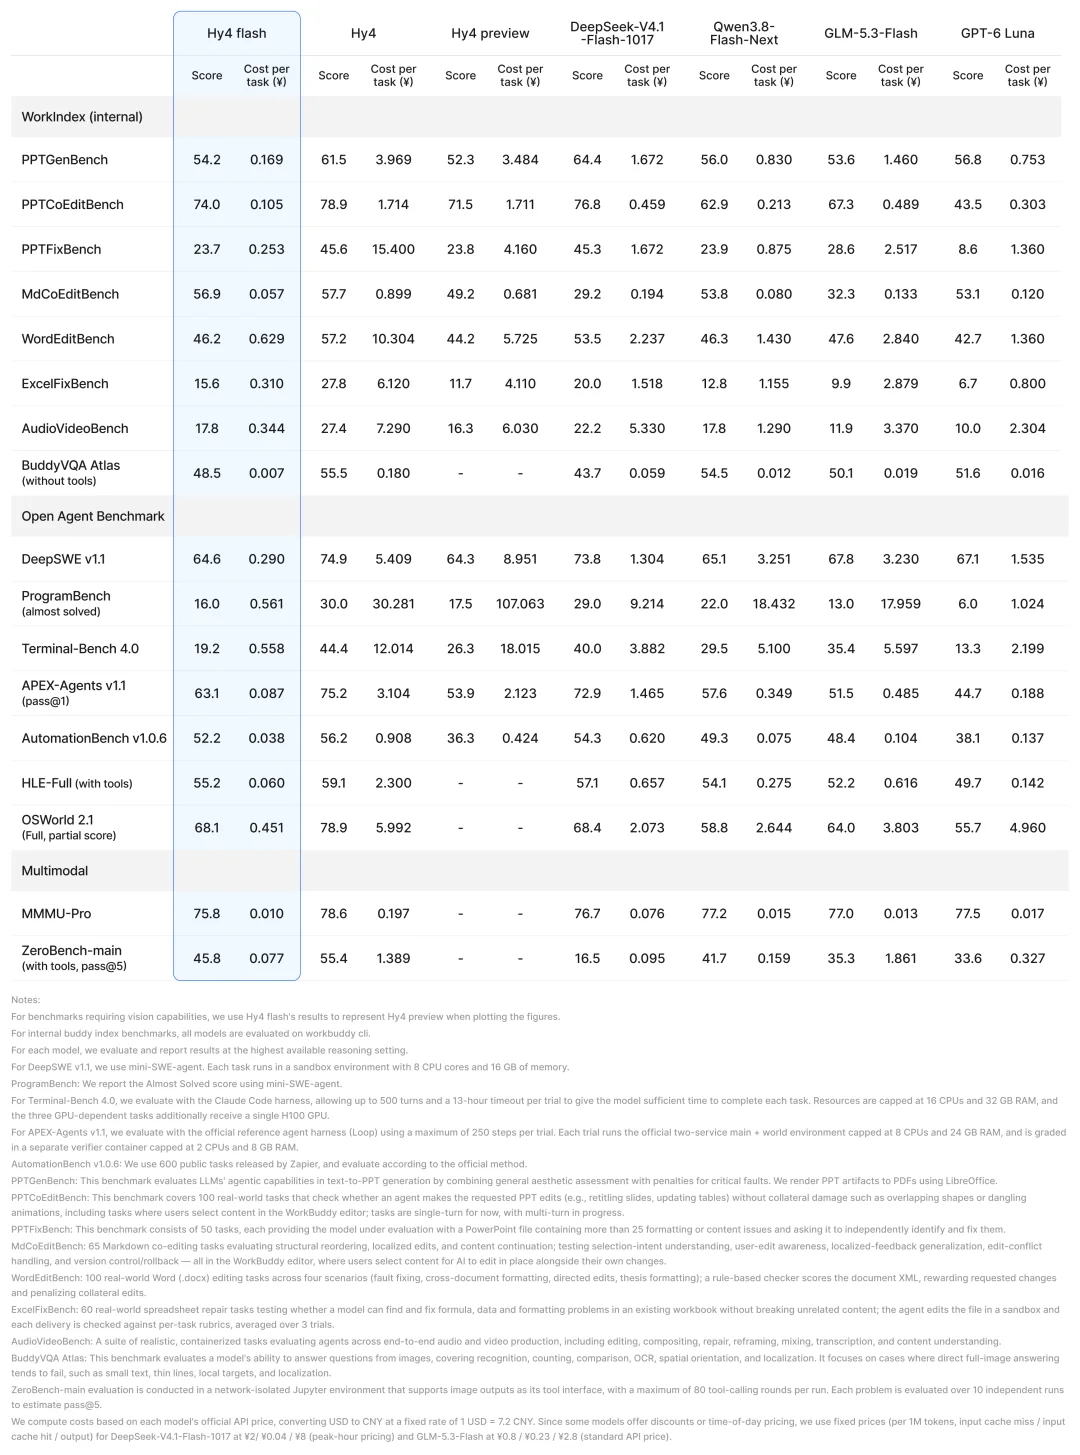
In den folgenden drei Tabellen sind die 17 Disziplinen aufgeschlüsselt. In Klammern stehen jeweils die Kosten pro Aufgabe in CNY; fett markiert ist der Bestwert unter den fünf Flash-Modellen (Hy4 flash, DeepSeek-V4.1-Flash, Qwen3.8-Flash-Next, GLM-5.3-Flash und GPT-6 Luna):
| WorkIndex (intern, 8 Tests) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| PPTGenBench | 54.2 (0.169) | 61.5 (3.969) | 52.3 (3.484) | 64.4 (1.672) | 56.0 (0.830) | 53.6 (1.460) | 56.8 (0.753) |
| PPTCoEditBench | 74.0 (0.105) | 78.9 (1.714) | 71.5 (1.711) | 76.8 (0.459) | 62.9 (0.213) | 67.3 (0.489) | 43.5 (0.303) |
| PPTFixBench | 23.7 (0.253) | 45.6 (15.400) | 23.8 (4.160) | 45.3 (1.672) | 23.9 (0.875) | 28.6 (2.517) | 8.6 (1.360) |
| MdCoEditBench | 56.9 (0.057) | 57.7 (0.899) | 49.2 (0.681) | 29.2 (0.194) | 53.8 (0.080) | 32.3 (0.133) | 53.1 (0.120) |
| WordEditBench | 46.2 (0.629) | 57.2 (10.304) | 44.2 (5.725) | 53.5 (2.237) | 46.3 (1.430) | 47.6 (2.840) | 42.7 (1.360) |
| ExcelFixBench | 15.6 (0.310) | 27.8 (6.120) | 11.7 (4.110) | 20.0 (1.518) | 12.8 (1.155) | 9.9 (2.879) | 6.7 (0.800) |
| AudioVideoBench | 17.8 (0.344) | 27.4 (7.290) | 16.3 (6.030) | 22.2 (5.330) | 17.8 (1.290) | 11.9 (3.370) | 10.0 (2.304) |
| BuddyVQA Atlas (ohne Tools) | 48.5 (0.007) | 55.5 (0.180) | — | 43.7 (0.059) | 54.5 (0.012) | 50.1 (0.019) | 51.6 (0.016) |
| Öffentliche Agent-Benchmarks (7 Tests) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 64.6 (0.290) | 74.9 (5.409) | 64.3 (8.951) | 73.8 (1.304) | 65.1 (3.251) | 67.8 (3.230) | 67.1 (1.535) |
| ProgramBench (almost solved) | 16.0 (0.561) | 30.0 (30.281) | 17.5 (107.063) | 29.0 (9.214) | 22.0 (18.432) | 13.0 (17.959) | 6.0 (1.024) |
| Terminal-Bench 4.0 | 19.2 (0.558) | 44.4 (12.014) | 26.3 (18.015) | 40.0 (3.882) | 29.5 (5.100) | 35.4 (5.597) | 13.3 (2.199) |
| APEX-Agents v1.1 (pass@1) | 63.1 (0.087) | 75.2 (3.104) | 53.9 (2.123) | 72.9 (1.465) | 57.6 (0.349) | 51.5 (0.485) | 44.7 (0.188) |
| AutomationBench v1.0.6 | 52.2 (0.038) | 56.2 (0.908) | 36.3 (0.424) | 54.3 (0.620) | 49.3 (0.075) | 48.4 (0.104) | 38.1 (0.137) |
| HLE-Full (mit Tools) | 55.2 (0.060) | 59.1 (2.300) | — | 57.1 (0.657) | 54.1 (0.275) | 52.2 (0.616) | 49.7 (0.142) |
| OSWorld 2.1 (Full, partial score) | 68.1 (0.451) | 78.9 (5.992) | — | 68.4 (2.073) | 58.8 (2.644) | 64.0 (3.803) | 55.7 (4.960) |
| Multimodal (2 Tests) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| MMMU-Pro | 75.8 (0.010) | 78.6 (0.197) | — | 76.7 (0.076) | 77.2 (0.015) | 77.0 (0.013) | 77.5 (0.017) |
| ZeroBench-main (mit Tools, pass@5) | 45.8 (0.077) | 55.4 (1.389) | — | 16.5 (0.095) | 41.7 (0.159) | 35.3 (1.861) | 33.6 (0.327) |
Über alle 17 Tests hinweg zeigt sich ein klares Muster:
Die Fußnoten im Anhang nennen die Testbedingungen: Alle Modelle liefen auf der jeweils höchsten verfügbaren Reasoning-Stufe. Interne Benchmarks wurden in der WorkBuddy CLI ausgeführt, DeepSWE und ProgramBench in mini-SWE-agent und Terminal-Bench 4.0 in Claude Code als Harness (maximal 500 Runden, Zeitlimit 13 Stunden pro Lauf). Die Kosten basieren auf den jeweiligen offiziellen API-Tarifen, umgerechnet zum Kurs von 1 USD = 7.2 CNY.
Zusätzlich ließ Tencent 85 interne WorkBuddy-Nutzer 259 Alltagsaufgaben aus 27 Kategorien im Blindtest bewerten. Die Vergleichsmodelle von DeepSeek, Claude Haiku und GLM liefen auf der Stufe high.
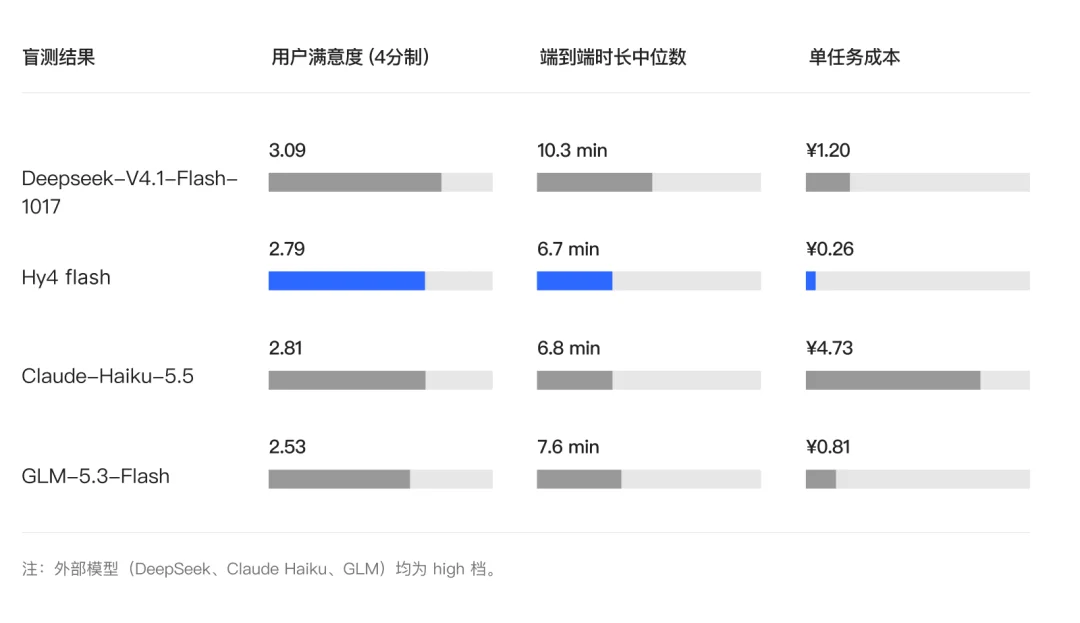
| Modell | Zufriedenheit (4-Punkte-Skala) | Median-Dauer (End-to-End) | Kosten pro Aufgabe |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 3.09 | 10.3 Min. | CNY 1.20 |
| Hy4 flash | 2.79 | 6.7 Min. | CNY 0.26 |
| Claude Haiku 5.5 | 2.81 | 6.8 Min. | CNY 4.73 |
| GLM-5.3-Flash | 2.53 | 7.6 Min. | CNY 0.81 |
Im Begleittext hebt Hunyuan die Nähe zu Claude Haiku 5.5 hervor (2.79 gegenüber 2.81). Unerwähnt bleibt, dass DeepSeek-V4.1-Flash mit 3.09 Punkten deutlich vorn liegt – 0.3 Punkte vor Hy4 flash. Dafür dauert DeepSeek im Median 10.3 Minuten und kostet CNY 1.20 pro Aufgabe, also das 1.5-Fache an Zeit und das 4.6-Fache an Geld. Claude Haiku 5.5 erreicht praktisch dieselbe Zufriedenheit wie Hy4 flash, kostet aber das 18-Fache.
Im Bericht des WorkBuddy-Teams heißt es, Hy4 flash senke die durchschnittliche Aufgabenzeit gegenüber Hy4 um 70% und die Kosten auf etwa ein Fünfzehntel, halte bei Büroaufgaben das Niveau und falle bei „langlaufenden Coding-Aufgaben leicht ab“. Ein Blick auf die drei Programmier-Benchmarks aus dem Anhang zeigt das Ausmaß genauer:
| Benchmark | Hy4 flash | Hy4 | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 19.2 (0.558) | 44.4 (12.014) | 40.0 (3.882) | 29.5 (5.100) |
| ProgramBench | 16.0 (0.561) | 30.0 (30.281) | 29.0 (9.214) | 22.0 (18.432) |
| DeepSWE v1.1 | 64.6 (0.290) | 74.9 (5.409) | 73.8 (1.304) | 65.1 (3.251) |
Auf Terminal-Bench 4.0 stürzt der Score von 44.4 auf 19.2 ab – weniger als die Hälfte von Hy4. Auch bei ProgramBench bleibt kaum mehr als die Hälfte übrig. Unter allen fünf Flash-Modellen erzielt Hy4 flash den niedrigsten Wert in DeepSWE und schlägt auf Terminal-Bench 4.0 lediglich GPT-6 Luna. Gemessen an den Zahlen aus dem Anhang ist „leicht abfallen“ eine Untertreibung.
Für Nutzer von Claude Code ist das besonders relevant, weil Terminal-Bench 4.0 direkt mit Claude Code als Harness gemessen wurde.
Genau an diesem Punkt entzündete sich auch die erste Diskussion in der Community. Auf r/LocalLLaMA merkte der Nutzer Hoppss nach dem Lesen der Model Card an, Qwen Flash Next wirke beim Programmieren stärker; mechkbfan hielt entgegen, man müsse die Kosten pro Aufgabe einrechnen – Hy4 flash sei womöglich schneller fertig und lasse Raum für mehrere Review-Schleifen. Die Anhangszahlen stützen beide Seiten: Auf Terminal-Bench 4.0 liegt Qwen3.8-Flash-Next mit 29.5 deutlich vor Hy4 flash (19.2), kostet pro Aufgabe aber CNY 5.10 statt CNY 0.56.
Tencent zieht die Grenze selbst klar: Deep Search, Dokumentverarbeitung, Präsentationen, einfache Frontend-Demos und Computer Use gehören zu Hy4 flash; für langlaufendes Software-Engineering empfiehlt der Hersteller Hy4 mit seiner höheren Intelligenz-Obergrenze. Wir finden: Als Hauptmodell zum Programmieren in Claude Code oder OpenCode ist Hy4 flash ungeeignet. Für massenhafte, klar umrissene Aufgaben wie Log-Auswertung, Dokumentaufbereitung oder einfache UI-Entwürfe ist es dagegen eine günstige Option.
Zusätzlich liefert der Blogpost interne Messwerte aus acht Produktteams bei Tencent:
| Produkt (Team / Kontakt) | Einsatzbereich | Vergleichsmodell | Gemeldete Ergebnisse |
|---|---|---|---|
| WorkBuddy (Product Manager Anne) | Alltägliche Büroaufgaben | Hy4 | Durchschnittliche Aufgabendauer -70%, Durchschnittskosten rund 1/15 von Hy4; Qualität bei Alltagsaufgaben etwa gleichauf, leichtes Minus bei langem Coding; nativ multimodal |
| Yuanbao (Product Lead Logan) | Agent-Aufgaben, allgemeiner Chat | Hy3, GLM-5.3-Flash | Agent-Fähigkeit +13.6% gegenüber Hy3, GSB in menschlicher Bewertung +7.56%; allgemeiner Chat +2.52% gegenüber GLM-5.3-Flash, stärkster Zuwachs bei Multi-Turn-Dialogen |
| WeChat Pay (Info Intelligence Lab yilin, Security Engineer Simba) | KI-gestützte Gerätetests der Zahlungs-App; statische Code-Analyse | DeepSeek-V4.1-Flash-1017 | Bei Ausführungspfad, Wissensnutzung, Abnahmeprüfung und Testaccount-Erstellung gleichauf oder besser, Schritte rund -6%, Output-Länge pro Zug rund -29%; statischer Scan -37% Laufzeit und -46% Token bei gleicher Qualität |
| WeCom (Algorithm Lead Dylan) | Unternehmenssuche, Datenanalyse, Dokumentaufbereitung | Hy4 | Ausgabegeschwindigkeit +88%, Output-Token im Thinking-Modus rund -60%; plant Tool-Aufrufe selbstständig bis zum Ergebnis |
| Honor of Kings (Project Management Lead TH) | Ursachenanalyse von Bugs in der Spielentwicklung (UI-Interaktion, Systemlogik) | DeepSeek-V4.1-Flash-1017, GLM-5.3-Flash | Ähnliche Treffergenauigkeit; Modellantworten -22.0% bis -39.1%, Token laut Request-Quittung -40.5% bis -61.2%; Tool-Aufrufe jedoch +51.2% bzw. +7.7% höher, Berichte um 13.8% bzw. 37.0% kürzer |
| ima (Product Manager Kaycee) | Wissensdatenbank-Q&A | DeepSeek-V4.1-Flash-1017, GLM-5.3-Flash | Durchschnittliche Wartezeit rund -18% bis -35%; Gesamtbewertung der Antworten +1.8%, Inhaltsqualität +8.1%, Chain-of-Thought-Qualität +2.1% |
| QQ (Xiao Q Tech Lead Red, Channel R&D Look) | Agent-Funktionen von Xiao Q; UGC-Interaktion des Channel-Assistenten | DeepSeek-V4.1-Flash | Zielerfüllung bei Musikempfehlungen, Channel-Interaktion, Qzone und langen Horoskop-Texten um 6.16, 2.84, 0.92 bzw. 2.22 Prozentpunkte höher; Bearbeitungszeit rund -11% bis -27%; beim Channel-Assistenten gleiche Intent-Genauigkeit, P90-Kommentarlatenz -39%, Spitzenlatenz -47%, Output-Token -30%, deutlich höhere Cache-Hit-Rate |
| Marvis (Algorithm Engineer Baihan) | KI-Assistent | DeepSeek-V4.1-Flash-1017 | Gesamtzufriedenheit gleichauf; App-Installationen +6.2%, Systemeinstellungen und Diagnose +4.4%, Dokumentverarbeitung und Rechercheberichte +6.9% |
Alle acht Fallstudien stammen aus Tencents eigenem Haus, treten meist gegen DeepSeek-V4.1-Flash an und wurden bisher nicht extern reproduziert. Ein Detail beim Team von Honor of Kings verdient Beachtung: Zwar sinken Modellanfragen und Token-Verbrauch, gegenüber DeepSeek steigen die Tool-Aufrufe aber um gut die Hälfte – gespart wird also bei den Token, nicht bei der Zahl der Werkzeugaufrufe.
Da sämtliche Benchmarks und Praxisberichte von Tencent selbst stammen, solltest du drei Rahmenbedingungen im Hinterkopf behalten:
high.Tencent stellt drei Varianten offen bereit: Hy4 flash, Hy4 flash-FP8 sowie die vortrainierte Basis Hy4 flash-base (kein Chat-Modell). Die Gewichte liegen auf Hugging Face, ModelScope und GitCode; Inferenz- und Finetuning-Skripte stehen auf GitHub. Das größere Modell Hy4 selbst ist noch nicht offen verfügbar, sondern als „demnächst Open Source“ angekündigt.
Für den Produktivbetrieb empfiehlt Tencent vLLM oder SGLang mit den FP8-Gewichten und 8-facher Tensor-Parallelität. Für vLLM existiert bereits ein fertiges Container-Image:
docker run --gpus all -p 8000:8000 --ipc=host \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \ --tensor-parallel-size 8 \ --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \ --attention-backend FLASHMLA_SPARSE \ --tool-call-parser hy_v4 \ --reasoning-parser hy_v4 \ --enable-auto-tool-choice \ --served-model-name hy4-flashNach dem Start stellt der Server eine OpenAI-kompatible API bereit. Die Reasoning-Stufe steuerst du über chat_template_kwargs, wobei no_think direkt ohne Denkpause antwortet:
from openai import OpenAI client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")resp = client.chat.completions.create( model="hy4-flash", messages=[{"role": "user", "content": "Fasse diesen Wochenbericht in drei Sätzen zusammen."}], extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}},)print(resp.choices[0].message.content)Das AngelSlim-Team von Tencent bietet zusätzlich eine GGUF-Fassung an; laut README dient diese jedoch nur für End-to-End-Tests, nicht für den Produktivbetrieb.
Die versprochenen 150+ Token pro Sekunde gelten für Tencents eigene Infrastruktur; unabhängige Messwerte anderer Anbieter liegen noch nicht vor. Auf Hacker News schrieb der Nutzer vcryan, das Modell gefalle ihm, wirke aber „etwas langsam“ (ohne Angabe des genutzten Endpunkts). Der Nutzer Rodmine hielt DeepSeek 4.1 Flash beim Preis-Leistungs-Verhältnis weiterhin für ungeschlagen, da es auf OpenRouter oft mit 200–400 Token pro Sekunde laufe – hoffte aber, dass Drittanbieter das kompakte Hy4 flash künftig noch schneller ausliefern.
Als Lizenz nutzt Tencent die Tencent Hy License 1.0, abgeleitet von Apache 2.0, ergänzt um eine kommerzielle MaaS-Klausel: Wer das Modell als Model-as-a-Service anbietet und weltweit über 50 Millionen US-Dollar Jahresumsatz oder mehr als 100 Millionen monatlich aktive Nutzer erreicht, benötigt eine gesonderte Lizenzvereinbarung mit Tencent. Die rein interne Nutzung ohne Weitergabe von Modell oder Ausgaben an Dritte bleibt davon unberührt.
| Workload | Empfehlung | Grund oder Kompromiss |
|---|---|---|
| Dokumente, Präsentationen, Tabellen, Deep Search | Hy4 flash | Auf WorkIndex rund CNY 0.2 pro Aufgabe; DeepSeek-V4.1-Flash punktet bei PPT und Dokumenten zwar höher, kostet aber das 4–10-Fache |
| Hohe Q&A- und Chat-Volumina mit Fokus auf Tempo | Hy4 flash | Im Blindtest mit 6.7 Min. Median-Dauer am schnellsten; 18%–35% kürzere Wartezeit bei ima |
| Programmieren und Terminal-Aufgaben in Claude Code / OpenCode | Hy4 oder DeepSeek-V4.1-Flash | Terminal-Bench 4.0: Hy4 flash 19.2, Hy4 44.4, DeepSeek-V4.1-Flash 40.0 |
| Höhere Ergebnisqualität ohne Zeitdruck | DeepSeek-V4.1-Flash | Mit 3.09 höchste Zufriedenheit im Blindtest; 10.3 Min. und CNY 1.20 pro Aufgabe, in den Nebenzeiten zum halben Preis |
| Visuelles Reasoning mit Tool-Nutzung | Hy4 flash | ZeroBench 45.8 (Bestwert im Feld), bei MMMU-Pro mit 75.8 allerdings Schlusslicht |
| Self-Hosting oder Weiterverkauf als API | Erst Lizenz und Hardware prüfen | FP8 benötigt 8-fache Tensor-Parallelität; große MaaS-Anbieter brauchen eine separate Lizenz |
Auf CodingPass ist aktuell Hy4 (Modell-ID hy4) in den Tarifen Go, Plus und Pro verfügbar und wird zu offiziellen API-Preisen abgerechnet; Hy4 flash ist derzeit noch nicht eingebunden. Für langlaufendes Coding ist Hy4 ohnehin die bessere Wahl. Wer dagegen ausschließlich günstige Büro- und Massentasks mit Hy4 flash fahren möchte, fährt direkt über Tencent Cloud TokenHub günstiger – erst recht mit dem 50%-Rabatt bis zum 30. November – und braucht dafür kein Abo. Alle Kontingente stehen auf der Modellseite.
CodingPass bietet Hy4, DeepSeek, Claude, GPT, Gemini und weitere Modelle, abgerechnet zu offiziellen API-Preisen. Keine Überraschungskosten, jederzeit kündbar.