Todos los modelos
ID de cada modelo, plan mínimo y cuota mensual en Go, Plus y Pro.
Tencent Hunyuan destila Hy4 flash desde Hy4 con tarifas 12 veces menores en entrada y 9 veces menores en salida, dejando tareas de diapositivas, documentos u hojas de cálculo en unos CNY 0.2. Sin embargo, los benchmarks de programación del apéndice se desploman y para desarrollo largo sigue haciendo falta Hy4. Repasamos todas las cifras, la prueba a ciegas, el coste por volumen y el despliegue local.
El 16 de noviembre, Tencent Hunyuan presentó Hy4 flash, al que define como “su modelo Hy más rentable hasta la fecha”. Se trata de una variante ligera de Hy4 con 224B parámetros totales —64B de ellos en capas Engram—, 12B parámetros activos por token, entrada multimodal de texto e imagen y una ventana de contexto de 1M de tokens. Sus pesos ya están abiertos y su API sale a CNY 0.5 por millón de tokens de entrada, CNY 2 de salida y CNY 0.02 en acierto de caché.
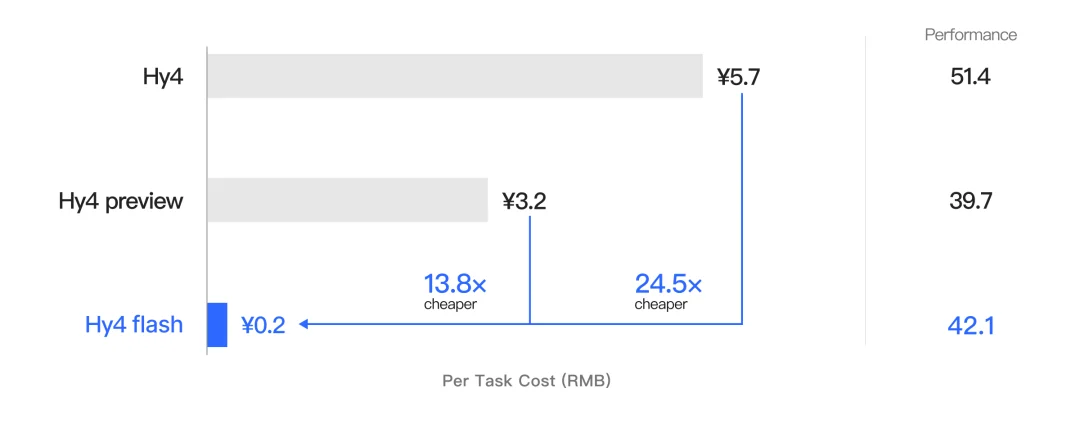
En lugar de centrar el lanzamiento en rankings públicos, Tencent apoya su discurso en WorkIndex, un conjunto interno de pruebas de oficina (diapositivas, documentos y hojas de cálculo). Allí, Hy4 flash logra 42.1 puntos, ligeramente por encima de Hy4 preview (39.7), con un coste por tarea de CNY 0.2 frente a los CNY 5.7 de Hy4.
En resumen: para tareas cotidianas de agente —documentos, presentaciones, búsqueda o interfaces web sencillas—, Hy4 flash tiene el precio unitario más bajo entre los modelos de su categoría. Con la distribución real de tráfico de CodingPass, cada solicitud sale por unos CNY 0.0064: alrededor de 1/12 de Hy4 y 3/10 de DeepSeek-V4.1-Flash en horas pico. Para programar no sirve: en el apéndice marca 19.2 en Terminal-Bench 4.0 (Hy4 logra 44.4 y DeepSeek-V4.1-Flash, 40.0) y 16.0 en ProgramBench (Hy4, 30.0). La propia Tencent recomienda Hy4 para ingeniería de software de largo recorrido.
El recorte de costes empieza en el diseño de la red. Hy4 flash combina atención híbrida, LatentMoE y Engram para reducir la caché KV a 1/24 de la de Hy3 y 1/6 de la de Hy4. Según Hunyuan, cada cambio se validó antes del preentrenamiento mediante experimentos de escalado (scaling ladder).
El postentrenamiento se divide en dos fases: primero una autodestilación desde Hy4 para heredar capacidades generales y después aprendizaje por refuerzo para recortar en un 50% la longitud media de salida por tarea. En inferencia, la suma de megakernels, cuantización a 4 bits y decodificación especulativa con DFly supera los 150 tokens por segundo (tps) según cifras oficiales.
El README de GitHub detalla la ficha técnica completa:
| Componente | Hy4 flash |
|---|---|
| Parámetros totales | Troncal 155.5B + Engram 63.5B + codificador visual 0.43B + DFly2 0.85B (unos 220B en total) |
| Activos por token | Texto 11.3B + visión 0.43B |
| Capas | 42 capas: 1 densa + 41 MoE |
| Expertos | 512 expertos enrutados por capa (16 activos por token) y 1 experto compartido; los enrutados operan en un espacio latente de baja dimensión (LatentMoE) |
| Atención | Atención dispersa (IndexPool, hasta 2,048 posiciones por paso) y atención de ventana deslizante (ventana de 512 tokens) alternadas en proporción 1:3 |
| Engram | Tabla hash multicabeza para bigramas y trigramas conectada en las capas 1, 11, 21 y 31 (empezando desde 0) |
| Codificador visual | Adaptado de SigLIP2-So400m y acoplado al troncal mediante un MLP |
| Decodificación especulativa | Borrador integrado DFly2 de 5 capas que reutiliza la caché KV y los índices dispersos del modelo principal sin consumo extra de memoria KV |
| Ventana de contexto | 1,048,576 tokens |
Conviene señalar un descuadre sin explicar: el blog oficial habla de 224B totales, 64B en Engram y 12B activos, mientras que la suma de las cifras del README da 220B, 63.5B y 11.7B.
Hy4 flash ya está disponible en Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima y Marvis, y llegará próximamente a OpenRouter.
| Modelo (CNY / millón de tokens) | Entrada (acierto de caché) | Entrada | Salida |
|---|---|---|---|
| Hy4 flash | 0.02 | 0.5 | 2 |
| Hy4 | 0.3 | 6 | 18 |
| DeepSeek-V4.1-Flash (horas pico) | 0.04 | 2 | 8 |
| DeepSeek-V4.1-Flash (horas valle) | 0.02 | 1 | 4 |
| GLM-5.3-Flash | 0.23 | 0.8 | 2.8 |
Frente a Hy4, la tarifa de entrada de Hy4 flash baja a 1/12, la de salida a 1/9 y el acierto de caché a 1/15. Además, hasta el 30 de noviembre ofrece un 50% de descuento en Tencent Cloud TokenHub y uso gratuito por tiempo limitado dentro de WorkBuddy.
En su comparativa con DeepSeek-V4.1-Flash, Tencent toma como referencia el horario de horas pico (01:00–04:00 y 06:00–10:00 UTC de lunes a viernes, es decir, 09:00–12:00 y 14:00–18:00 hora de Pekín). Según la página de precios de DeepSeek, en horas valle la tarifa se reduce a la mitad: iguala los CNY 0.02 de acierto de caché de Hy4 flash, aunque la entrada y la salida siguen costando el doble. Los precios de GLM-5.3-Flash proceden de la página de tarifas de Zhipu.
Si trasladamos estas cifras a la distribución real de tráfico de CodingPass —una llamada de agente suele mover unos 100K tokens, repartidos en un 5% de entrada nueva, un 1% de salida y un 94% de lectura de caché—, la factura queda así:
Coste por solicitud = 5K × entrada + 94K × acierto de caché + 1K × salidaHy4 flash = 0.0025 + 0.00188 + 0.002 = 0.00638 CNY| Modelo | Por solicitud (CNY) | 10,000 / mes (CNY) | 100,000 / mes (CNY) | 1,000,000 / mes (CNY) |
|---|---|---|---|---|
| Hy4 flash | 0.0064 | 64 | 638 | 6,380 |
| DeepSeek-V4.1-Flash (horas valle) | 0.0109 | 109 | 1,088 | 10,880 |
| DeepSeek-V4.1-Flash (horas pico) | 0.0218 | 218 | 2,176 | 21,760 |
| GLM-5.3-Flash | 0.0284 | 284 | 2,842 | 28,420 |
| Hy4 | 0.0762 | 762 | 7,620 | 76,200 |
Como más del 90% de los tokens en un agente vienen de caché, la tarifa de lectura de caché es la que manda en la factura. GLM-5.3-Flash tiene precios contenidos en entrada y salida, pero su acierto de caché cuesta CNY 0.23 —11.5 veces más que Hy4 flash—, lo que lo vuelve incluso más caro que DeepSeek en horas pico.
La tabla asume un consumo idéntico de tokens entre modelos. Si Hy4 flash cumple con el recorte del 50% en tokens de salida y resuelve en menos turnos, la brecha a su favor crece; por el contrario, si falla al primer intento y obliga a reintentar, el gasto real pasa a medirse como “coste por ejecución ÷ tasa de éxito en el primer intento”.
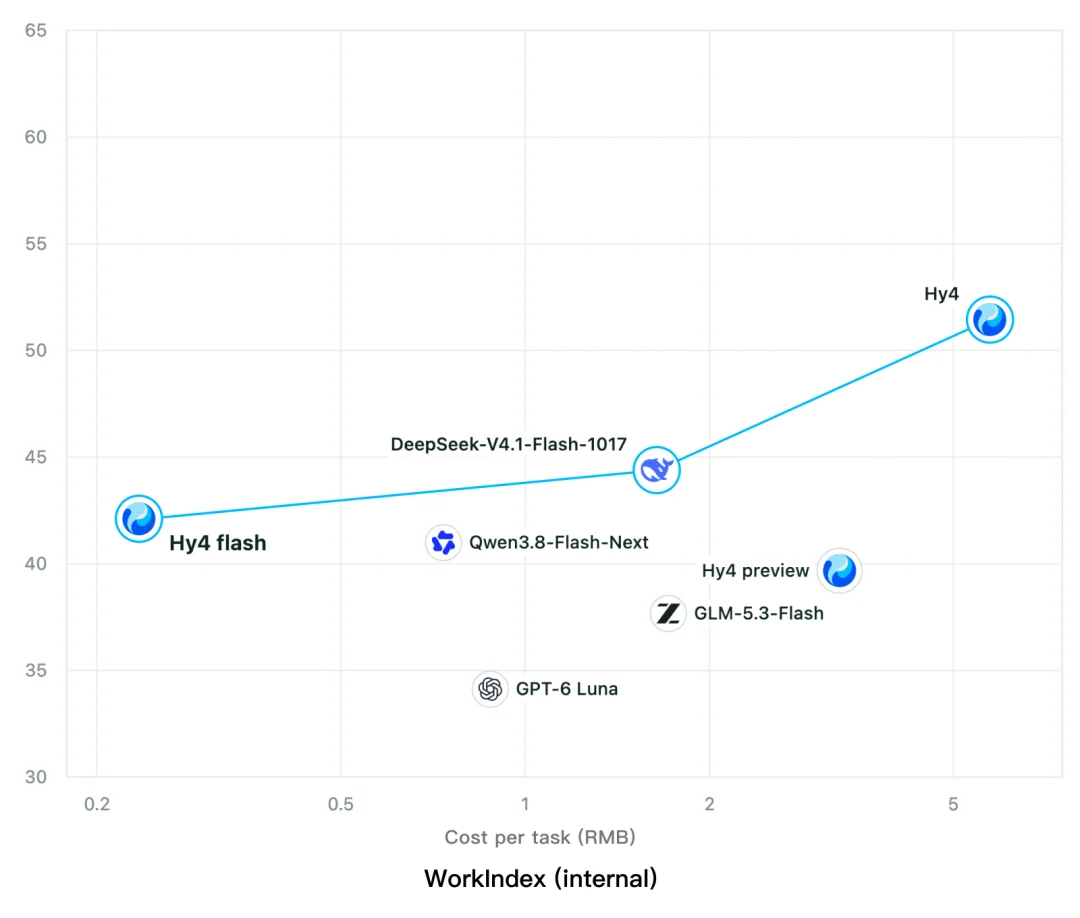
Hunyuan publicó dos baterías de pruebas. La primera es WorkIndex, creada con tareas reales de WorkBuddy y evaluación humana sobre calidad del entregable, longitud de salida por turno y tiempo total; abarca ocho apartados internos (creación y edición de diapositivas, coescritura en PPT y Markdown, edición de documentos, reparación de hojas de cálculo, audio/vídeo y comprensión visual). La segunda reúne siete benchmarks públicos de agentes: DeepSWE, ProgramBench, Terminal-Bench 4.0, APEX-Agents, AutomationBench, HLE y OSWorld 2.1. En ambas gráficas, el eje horizontal mide el coste por tarea en CNY en escala logarítmica. En WorkIndex, Hy4 flash aparece en el extremo izquierdo, unos 2 puntos por debajo de DeepSeek-V4.1-Flash:
Al pasar a los siete benchmarks públicos de agentes, la distancia en puntuación aumenta:
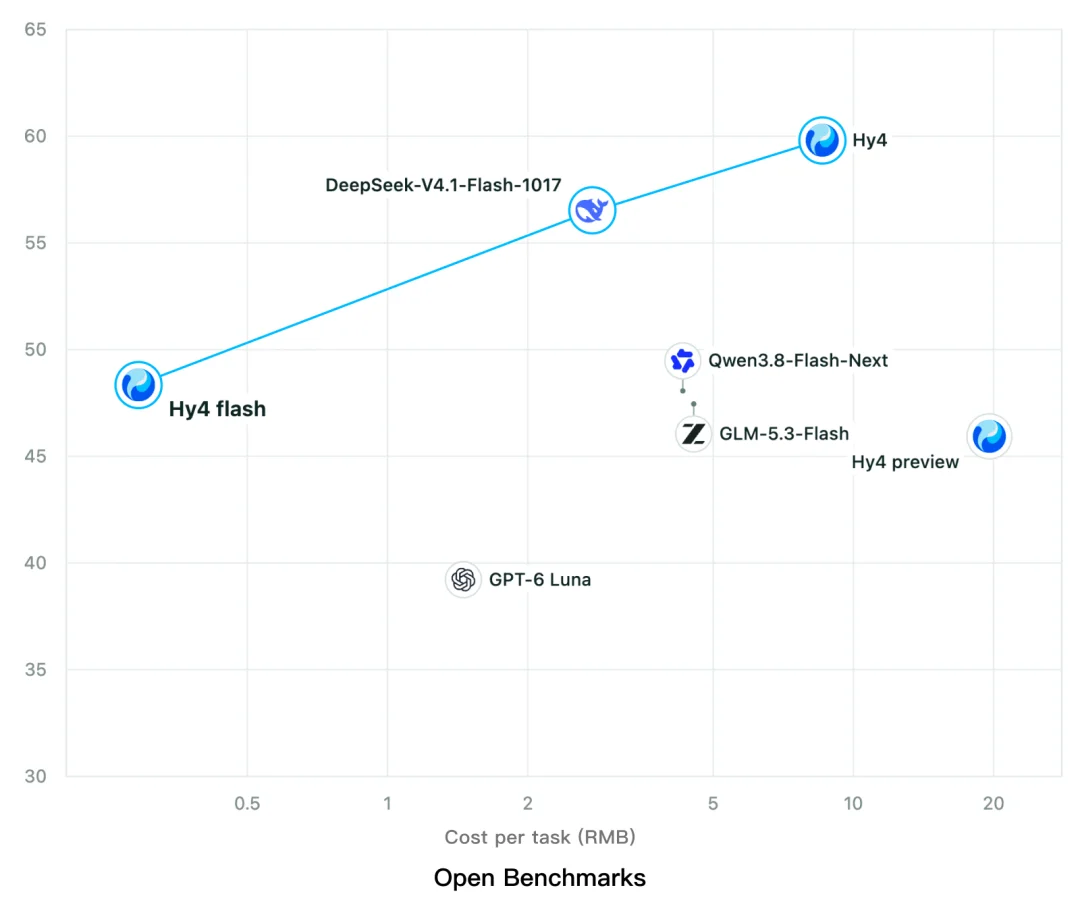
En las pruebas públicas, Hy4 flash empata prácticamente con Qwen3.8-Flash-Next y GLM-5.3-Flash, queda unos 8 puntos por debajo de DeepSeek-V4.1-Flash y mantiene un coste por tarea un orden de magnitud inferior.
El argumento principal de Tencent se apoya en WorkIndex: Hy4 flash supera ligeramente a Hy4 preview gastando 1/13 de su coste, 1/20 del de Hy4 y 1/8 del de DeepSeek-V4.1-Flash-1017 (en nivel Max y horas pico).
El apéndice incluye el desglose de las 17 pruebas con su puntuación y coste por tarea:
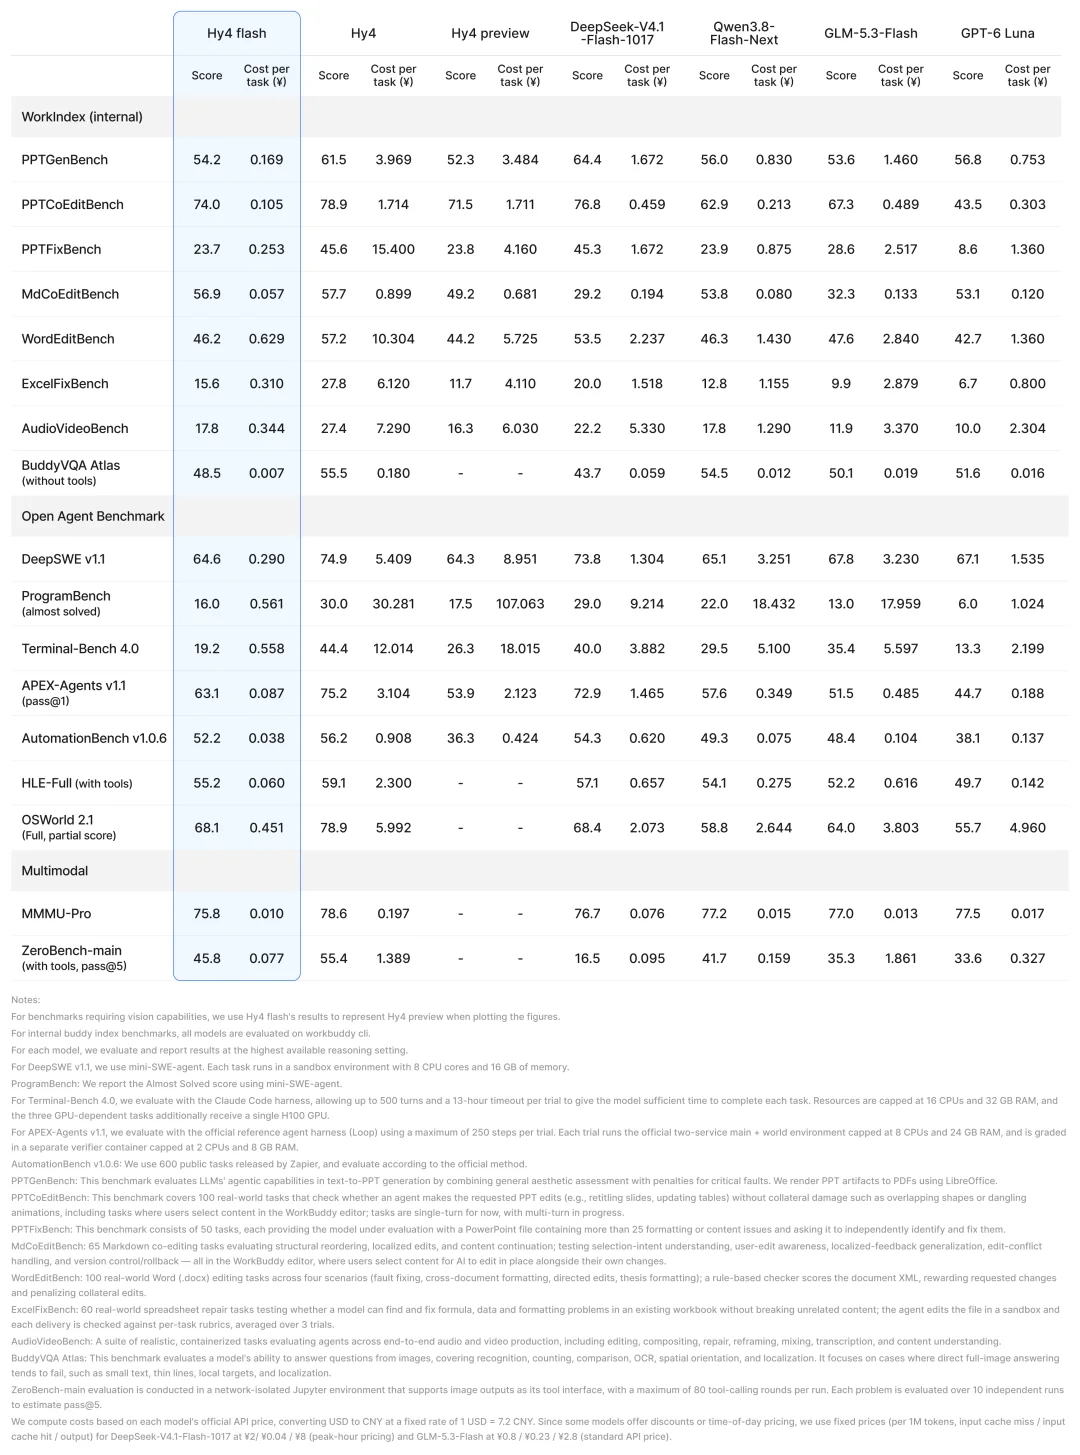
Dividimos la tabla original en tres bloques. Entre paréntesis figura el coste por tarea (en CNY) y en negrita la puntuación más alta entre los cinco modelos de gama Flash (Hy4 flash, DeepSeek-V4.1-Flash, Qwen3.8-Flash-Next, GLM-5.3-Flash y GPT-6 Luna):
| WorkIndex (interno, 8 pruebas) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| PPTGenBench | 54.2 (0.169) | 61.5 (3.969) | 52.3 (3.484) | 64.4 (1.672) | 56.0 (0.830) | 53.6 (1.460) | 56.8 (0.753) |
| PPTCoEditBench | 74.0 (0.105) | 78.9 (1.714) | 71.5 (1.711) | 76.8 (0.459) | 62.9 (0.213) | 67.3 (0.489) | 43.5 (0.303) |
| PPTFixBench | 23.7 (0.253) | 45.6 (15.400) | 23.8 (4.160) | 45.3 (1.672) | 23.9 (0.875) | 28.6 (2.517) | 8.6 (1.360) |
| MdCoEditBench | 56.9 (0.057) | 57.7 (0.899) | 49.2 (0.681) | 29.2 (0.194) | 53.8 (0.080) | 32.3 (0.133) | 53.1 (0.120) |
| WordEditBench | 46.2 (0.629) | 57.2 (10.304) | 44.2 (5.725) | 53.5 (2.237) | 46.3 (1.430) | 47.6 (2.840) | 42.7 (1.360) |
| ExcelFixBench | 15.6 (0.310) | 27.8 (6.120) | 11.7 (4.110) | 20.0 (1.518) | 12.8 (1.155) | 9.9 (2.879) | 6.7 (0.800) |
| AudioVideoBench | 17.8 (0.344) | 27.4 (7.290) | 16.3 (6.030) | 22.2 (5.330) | 17.8 (1.290) | 11.9 (3.370) | 10.0 (2.304) |
| BuddyVQA Atlas (sin herramientas) | 48.5 (0.007) | 55.5 (0.180) | — | 43.7 (0.059) | 54.5 (0.012) | 50.1 (0.019) | 51.6 (0.016) |
| Benchmarks públicos (7 pruebas) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 64.6 (0.290) | 74.9 (5.409) | 64.3 (8.951) | 73.8 (1.304) | 65.1 (3.251) | 67.8 (3.230) | 67.1 (1.535) |
| ProgramBench (almost solved) | 16.0 (0.561) | 30.0 (30.281) | 17.5 (107.063) | 29.0 (9.214) | 22.0 (18.432) | 13.0 (17.959) | 6.0 (1.024) |
| Terminal-Bench 4.0 | 19.2 (0.558) | 44.4 (12.014) | 26.3 (18.015) | 40.0 (3.882) | 29.5 (5.100) | 35.4 (5.597) | 13.3 (2.199) |
| APEX-Agents v1.1 (pass@1) | 63.1 (0.087) | 75.2 (3.104) | 53.9 (2.123) | 72.9 (1.465) | 57.6 (0.349) | 51.5 (0.485) | 44.7 (0.188) |
| AutomationBench v1.0.6 | 52.2 (0.038) | 56.2 (0.908) | 36.3 (0.424) | 54.3 (0.620) | 49.3 (0.075) | 48.4 (0.104) | 38.1 (0.137) |
| HLE-Full (con herramientas) | 55.2 (0.060) | 59.1 (2.300) | — | 57.1 (0.657) | 54.1 (0.275) | 52.2 (0.616) | 49.7 (0.142) |
| OSWorld 2.1 (Full, partial score) | 68.1 (0.451) | 78.9 (5.992) | — | 68.4 (2.073) | 58.8 (2.644) | 64.0 (3.803) | 55.7 (4.960) |
| Multimodalidad (2 pruebas) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| MMMU-Pro | 75.8 (0.010) | 78.6 (0.197) | — | 76.7 (0.076) | 77.2 (0.015) | 77.0 (0.013) | 77.5 (0.017) |
| ZeroBench-main (con herramientas, pass@5) | 45.8 (0.077) | 55.4 (1.389) | — | 16.5 (0.095) | 41.7 (0.159) | 35.3 (1.861) | 33.6 (0.327) |
De las 17 filas salen dos conclusiones muy nítidas:
Las notas al pie del apéndice precisan el protocolo: todos los modelos corrieron en su nivel máximo de razonamiento; las pruebas internas se ejecutaron en la CLI de WorkBuddy; DeepSWE y ProgramBench usaron mini-SWE-agent; Terminal-Bench 4.0 utilizó Claude Code como entorno de ejecución con un tope de 500 turnos y 13 horas por intento; los costes se calcularon con tarifas oficiales de API aplicando un tipo de cambio de 1 USD = 7.2 CNY.
Hunyuan reunió a 85 usuarios internos de WorkBuddy para evaluar a ciegas 259 tareas cotidianas repartidas en 27 categorías. Los modelos externos (DeepSeek, Claude Haiku y GLM) se configuraron en nivel high.
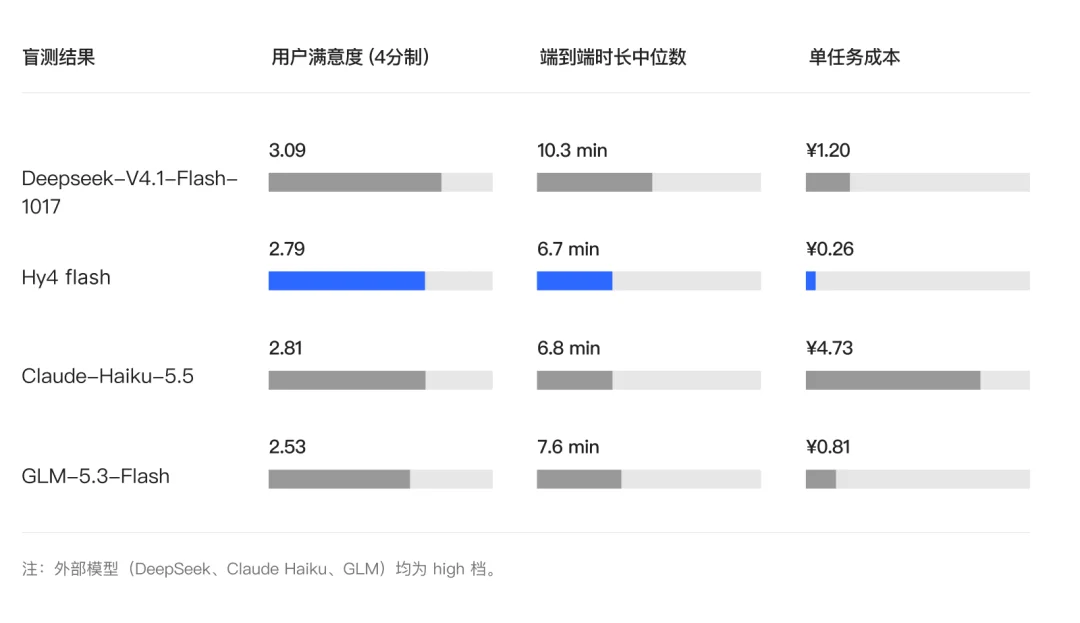
| Modelo | Satisfacción (sobre 4) | Duración mediana | Coste por tarea |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 3.09 | 10.3 min | CNY 1.20 |
| Hy4 flash | 2.79 | 6.7 min | CNY 0.26 |
| Claude Haiku 5.5 | 2.81 | 6.8 min | CNY 4.73 |
| GLM-5.3-Flash | 2.53 | 7.6 min | CNY 0.81 |
El texto oficial subraya que Hy4 flash casi empata con Claude Haiku 5.5 en satisfacción (2.79 frente a 2.81) costando 18 veces menos por tarea, pero omite comentar que el ganador real de la prueba fue DeepSeek-V4.1-Flash con 3.09 puntos (+0.3 sobre Hy4 flash), a costa de tardar 1.5 veces más (10.3 minutos de mediana) y costar 4.6 veces más (CNY 1.20).
El equipo de WorkBuddy resume su evaluación diciendo que Hy4 flash recorta un 70% el tiempo medio, cuesta alrededor de 1/15 que Hy4, mantiene el nivel en trabajo de oficina y sufre “una ligera caída en tareas largas de código”. Al aislar los benchmarks de programación del apéndice, el descenso es bastante más pronunciado:
| Benchmark | Hy4 flash | Hy4 | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 19.2 (0.558) | 44.4 (12.014) | 40.0 (3.882) | 29.5 (5.100) |
| ProgramBench | 16.0 (0.561) | 30.0 (30.281) | 29.0 (9.214) | 22.0 (18.432) |
| DeepSWE v1.1 | 64.6 (0.290) | 74.9 (5.409) | 73.8 (1.304) | 65.1 (3.251) |
En Terminal-Bench 4.0 baja de 44.4 a 19.2 —menos de la mitad que Hy4— y en ProgramBench apenas conserva algo más de la mitad. Entre los cinco modelos Flash, registra la peor marca en DeepSWE y solo supera a GPT-6 Luna en Terminal-Bench 4.0. Con esos números sobre la mesa, hablar de “ligera caída” se queda corto.
El dato afecta de lleno a quienes usan Claude Code, ya que Terminal-Bench 4.0 se ejecutó precisamente con Claude Code como entorno.
La comunidad reaccionó rápido en esa misma línea. En r/LocalLLaMA, el usuario Hoppss comentó tras revisar la ficha que Qwen Flash Next parecía mejor opción para programar, a lo que mechkbfan respondió que también convenía mirar el coste por tarea porque Hy4 flash quizá permitiera iterar y revisar más veces. El apéndice da la razón a ambos: en Terminal-Bench 4.0, Qwen3.8-Flash-Next saca 29.5 frente a 19.2, pero cuesta CNY 5.10 por tarea frente a CNY 0.56.
La propia Tencent marca la frontera: recomienda Hy4 flash para búsqueda profunda, procesamiento de documentos, diapositivas, demos frontend sencillas y uso de ordenador (computer use), y reserva Hy4 —con mayor techo de inteligencia— para ingeniería de software de largo recorrido. En nuestra opinión, no conviene usarlo como modelo principal para escribir código en Claude Code u OpenCode; encaja mejor en trabajos repetitivos y poco complejos como leer logs, ordenar documentación o generar interfaces simples.
El anuncio también recoge pruebas internas de ocho equipos de producto dentro de Tencent:
| Producto (evaluador) | Escenario | Referencia | Resultados |
|---|---|---|---|
| WorkBuddy (PM Anne) | Tareas diarias de oficina | Hy4 | 70% menos de tiempo medio y aprox. 1/15 del coste; calidad similar en oficina, ligera caída en código largo; multimodalidad nativa |
| Yuanbao (responsable de producto Logan) | Agentes y conversación general | Hy3, GLM-5.3-Flash | +13.6% en tareas de agente frente a Hy3 y +7.56% en evaluación humana GSB; +2.52% en diálogo general frente a GLM-5.3-Flash, con mayor ventaja en múltiples turnos |
| WeChat Pay (Info Intelligence Lab yilin, ingeniero de seguridad Simba) | Pruebas en dispositivos reales y análisis estático de código | DeepSeek-V4.1-Flash-1017 | Igual o mejor puntuación en ruta de ejecución, uso de conocimiento, validación y creación de cuentas, con un 6% menos de pasos y salida 29% más corta; análisis estático 37% más rápido y con un 46% menos de tokens |
| WeCom (responsable de algoritmos Dylan) | Búsqueda empresarial, análisis y organización documental | Hy4 | Velocidad de salida 88% superior y aprox. un 60% menos de tokens en modo de pensamiento; planifica herramientas de forma autónoma |
| Honor of Kings (responsable de proyecto TH) | Localización de causa raíz de bugs (IU y lógica) | DeepSeek-V4.1-Flash-1017, GLM-5.3-Flash | Precisión similar; 22.0%–39.1% menos solicitudes al modelo y 40.5%–61.2% menos tokens facturados, aunque hace un 51.2% y 7.7% más llamadas a herramientas y entrega informes un 13.8% y 37.0% más cortos |
| ima (PM Kaycee) | Preguntas sobre base de conocimiento | DeepSeek-V4.1-Flash-1017, GLM-5.3-Flash | Espera media reducida en un 18%–35%; mejora del 1.8% en nota global, 8.1% en calidad de contenido y 2.1% en cadena de pensamiento |
| QQ (líder técnico Red, desarrollo Look) | Capacidades de agente en Xiao Q y moderación/UGC en canales | DeepSeek-V4.1-Flash | Tasa de acierto superior en recomendación musical (+6.16 pp), canales (+2.84 pp), Qzone (+0.92 pp) y textos largos (+2.22 pp); 11%–27% menos tiempo; latencia P90 y pico en comentarios reducidas un 39% y 47%, con 30% menos tokens de salida |
| Marvis (ingeniero de algoritmos Baihan) | Asistente IA | DeepSeek-V4.1-Flash-1017 | Satisfacción global similar; mejoras en descarga e instalación de apps (+6.2%), ajustes y diagnóstico (+4.4%) e informes y documentos (+6.9%) |
Los ocho casos son internos de Tencent, se comparan sobre todo contra DeepSeek-V4.1-Flash y carecen de réplica independiente. El caso de Honor of Kings ilustra bien el matiz: aunque baja el total de solicitudes y tokens, frente a DeepSeek hace un 51.2% más de llamadas a herramientas. Ahorra tokens, no necesariamente ciclos de ejecución.
Al revisar juntas las tablas y las notas al pie aparecen tres puntos que condicionan la lectura:
high.Tencent libera tres variantes: Hy4 flash, Hy4 flash-FP8 y el modelo base preentrenado Hy4 flash-base (no ajustado para chat). Están disponibles en Hugging Face, ModelScope y AtomGit (GitCode), con código de inferencia y ajuste fino en GitHub. Hy4 completo sigue cerrado, aunque la compañía promete abrirlo “pronto”.
Para producción, la recomendación oficial es vLLM o SGLang con los pesos FP8 en paralelismo tensorial de 8 GPUs. Existe imagen lista de vLLM:
docker run --gpus all -p 8000:8000 --ipc=host \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \ --tensor-parallel-size 8 \ --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \ --attention-backend FLASHMLA_SPARSE \ --tool-call-parser hy_v4 \ --reasoning-parser hy_v4 \ --enable-auto-tool-choice \ --served-model-name hy4-flashEl servidor expone una API compatible con OpenAI. El nivel de esfuerzo de razonamiento se pasa mediante chat_template_kwargs, usando no_think para desactivar el pensamiento:
from openai import OpenAI client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")resp = client.chat.completions.create( model="hy4-flash", messages=[{"role": "user", "content": "Resume este informe semanal en tres frases"}], extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}},)print(resp.choices[0].message.content)El equipo AngelSlim de Tencent también publicó una versión GGUF, aunque el README aclara que es solo para pruebas de extremo a extremo y remite a vLLM o SGLang para uso en producción.
La cifra de 150 tps corresponde a la infraestructura propia de Tencent y todavía no hay datos públicos de terceros. En el hilo de lanzamiento en Hacker News, el usuario vcryan señaló que el modelo le gustaba pero le parecía “un poco lento” (sin especificar proveedor), mientras que Rodmine opinó que nada supera a DeepSeek 4.1 Flash en relación calidad-precio —suele rondar los 200–400 tps en OpenRouter—, aunque esperaba que el menor tamaño de Hy4 flash permita a terceros servirlo más rápido.
La licencia es Tencent Hy License 1.0, derivada de Apache 2.0 con una cláusula adicional para proveedores de Model-as-a-Service (MaaS): las empresas cuya actividad principal sea ofrecer modelos como servicio y superen los $50 millones de ingresos brutos anuales globales o los 100 millones de usuarios activos mensuales deben firmar una autorización aparte con Tencent. El uso estrictamente interno, sin exponer el modelo ni sus salidas a terceros, queda exento.
| Carga de trabajo | Recomendación | Motivo o peaje |
|---|---|---|
| Documentos, diapositivas, hojas de cálculo y búsqueda profunda | Hy4 flash | Unos CNY 0.2 por tarea en WorkIndex; DeepSeek-V4.1-Flash puntúa más alto pero cuesta entre 4 y 10 veces más |
| Chat y consultas de alto volumen con prioridad en rapidez | Hy4 flash | Mediana de 6.7 min en la prueba a ciegas (la más rápida); espera un 18%–35% menor en ima |
| Programación y terminal en Claude Code u OpenCode | Hy4 o DeepSeek-V4.1-Flash | Terminal-Bench 4.0: Hy4 flash 19.2, Hy4 44.4, DeepSeek-V4.1-Flash 40.0 |
| Máxima calidad de entrega sin prisa | DeepSeek-V4.1-Flash | Mayor satisfacción en la prueba a ciegas (3.09); mediana de 10.3 min y CNY 1.20 por tarea (mitad de precio en horas valle) |
| Razonamiento visual con herramientas | Hy4 flash | Primero de su gama en ZeroBench (45.8), aunque último en MMMU-Pro (75.8) |
| Despliegue propio para servir a terceros | Revisar hardware y licencia | FP8 requiere paralelismo tensorial de 8 GPUs; grandes operadores MaaS necesitan licencia comercial |
CodingPass incluye actualmente Hy4 (ID de modelo hy4) en los planes Go, Plus y Pro, tarificado a precios oficiales de API; Hy4 flash no está disponible por ahora en el catálogo. Si tu foco es programar tareas largas, la propia Tencent recomienda usar directamente Hy4. En cambio, si solo buscas ejecutar grandes volúmenes de tareas rutinarias con Hy4 flash, te saldrá más a cuenta contratar directamente Tencent Cloud TokenHub —que mantiene el 50% de descuento hasta el 30 de noviembre— que suscribirte a un plan. Puedes consultar las cuotas por modelo en la página de modelos.
CodingPass reúne Hy4, DeepSeek, Claude, GPT y Gemini tarificados a precios oficiales de API. Sin cargos sorpresa, cancela cuando quieras.