Google вернул себе первое место с Gemini 4 Carbon
Официальные бенчмарки Carbon и независимые тесты, почему при той же цене за токен задача обходится дороже и подорожание 1 декабря.
Ради мелких деталей Krypton сжигает в 5,7 раза больше токенов рассуждений, чем Carbon, а тестируемой на части аккаунтов GPT-6.2 Sol приписывают первое место и $1.19 за задачу. Оба релиза ещё не вышли в широкий доступ, но те, кто каждый день гоняет модели в работе, уже разделили обязанности: одну — на глубокую проработку, другую — на поток, третью — на код.
Среди разработчиков разошёлся пост со сравнением двух невышедших моделей: Gemini 4 Krypton от Google и GPT-6.2 Sol от OpenAI поставили рядом, чтобы выяснить, кто справляется лучше.
Но за самим спором интересно другое: тестеры, которые сидят в моделях с утра до вечера, уже перестали искать одну универсальную и меняют их под конкретную работу. Где нужна глубина — запускают одну, на рутину и поток — ставят другую, а код и оркестрацию оставляют третьей. Плотная волна релизов 2026 года окончательно закрыла идею «одной модели на всё».
Коротко: Krypton готова жечь впятеро больше токенов рассуждений ради проработки деталей, а GPT-6.2 Sol метит на первое место при цене задачи на порядок ниже конкурентов. Но обе модели пока либо в закрытом тесте, либо раскатываются на часть аккаунтов, а скриншоты с баллами Sol на сайте Artificial Analysis не подтверждаются. Зато прямо сейчас в работе доступны Carbon, Argon, GPT-6.1 Sol и Opus 5.5 — ниже разберём на цифрах и счетах, какую под что ставить.
Начнём с Gemini 4 Krypton. Громче всего она выстрелила в творческих задачах: по одному промпту модель собирает целый воксельный мир — портовый городок с маяком, цветущей сакурой, замком и парусником, причём сразу с водой и поставленным светом.
Видео генерации от Krypton (очень ранний чекпоинт), Carbon и Argon выложили рядом: каждый ролик длится чуть больше сорока секунд, у всех один и тот же воксельный портовый городок, и разница в плотности деталей видна с первого взгляда.
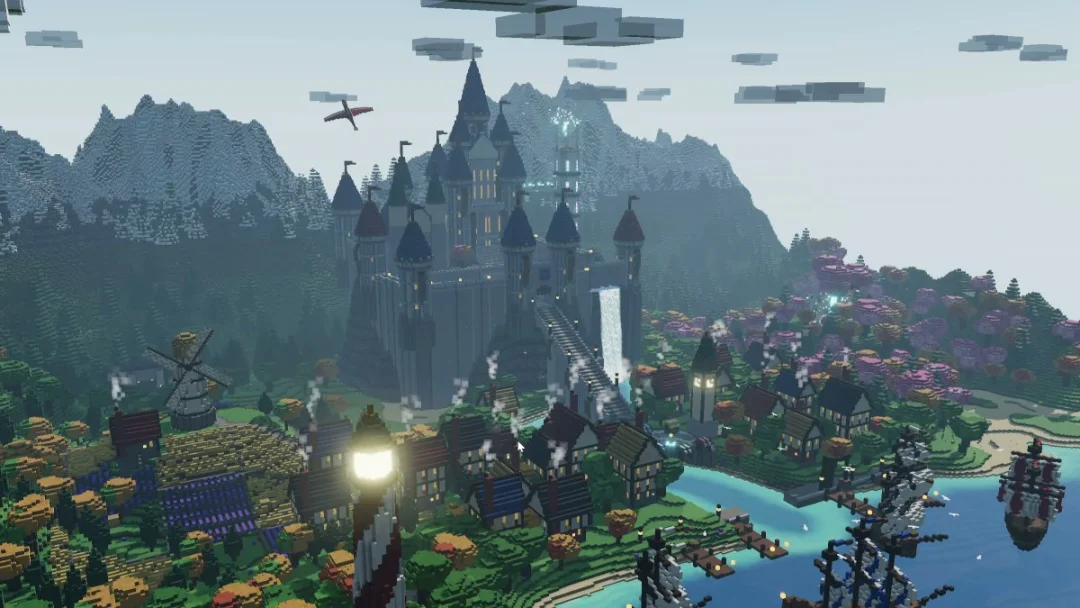 X · @lyraxanaGemini 4 Krypton vs Carbon vs ArgonСмотреть в X
За счёт чего такая проработка? Модель не жалеет токенов рассуждений. Прежде чем выдавать ответ, она долго просчитывает мелочи — вплоть до того, чтобы аккуратно вырисовать логотип PlayStation на геймпаде в чистом SVG.
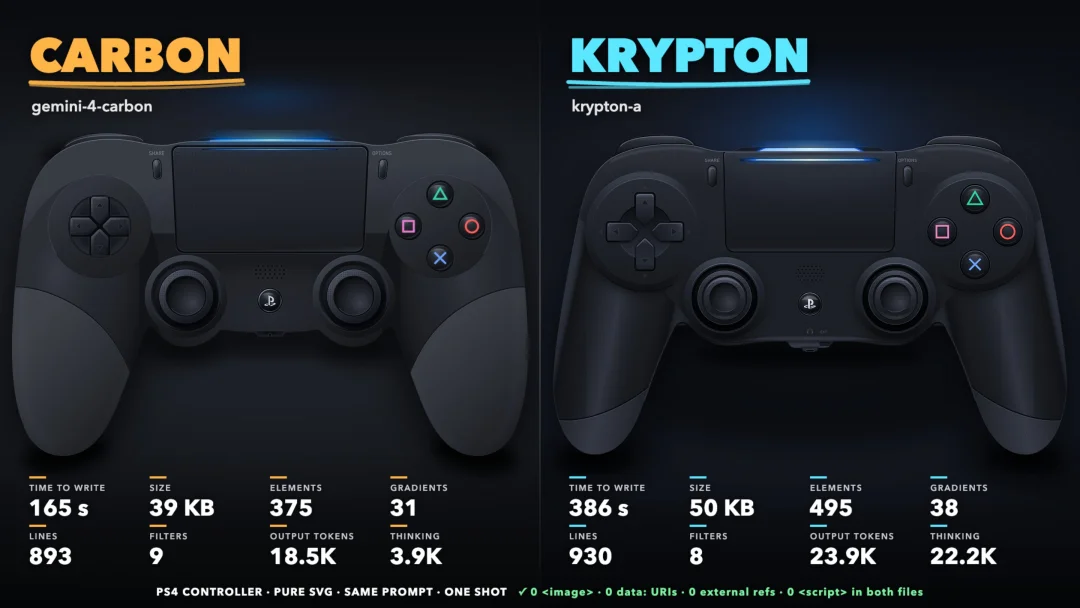
На том же самом промпте Krypton тратит вдвое больше времени, но выдаёт самую детальную картинку среди всех моделей Google — достаточно взглянуть на значок PS по центру геймпада.
| Показатель | Gemini 4 Carbon | Krypton | Krypton / Carbon |
|---|---|---|---|
| Время генерации | 165 с | 386 с | в 2,3 раза |
| Токены рассуждений | 3,9K | 22,2K | в 5,7 раза |
| Выходные токены | 18,5K | 23,9K | в 1,3 раза |
| Размер файла | 39 КБ | 50 КБ | в 1,3 раза |
| Строк кода | 893 | 930 | в 1,04 раза |
Времени ушло более чем вдвое больше, а итоговый код вырос всего на 4% по числу строк. Весь дополнительный объём ушёл в размышления — в 5,7 раза больше токенов, чем у Carbon. Каждая кривая и каждая тень продуманы до начала записи кода, а не взяты раздуванием файла.
Обмен долгих размышлений на точность деталей прослеживается у всего семейства Gemini 4. Векторный геймпад PS5 от Krypton — из той же серии, а глава Google AI Studio Логан Килпатрик говорит так: «Carbon — отличная модель, но команда продолжает готовить новое».
Платить за это приходится напрямую. Когда Carbon запустили в Google Antigravity на высоком уровне рассуждений параллельно в нескольких проектах примерно на 7 часов, недельный лимит просел с 88% до 23% — ушло больше шестидесяти процентов за один заход.
Чем выше уровень рассуждений, тем чище результат — и тем дольше ожидание и длиннее счёт за токены. К этой закономерности мы ещё вернёмся на других моделях ниже.
Теперь к GPT-6.2 Sol. Главный повод для обсуждений в последние дни — разошедшийся по сети скриншот якобы первых замеров из Artificial Analysis (AA):
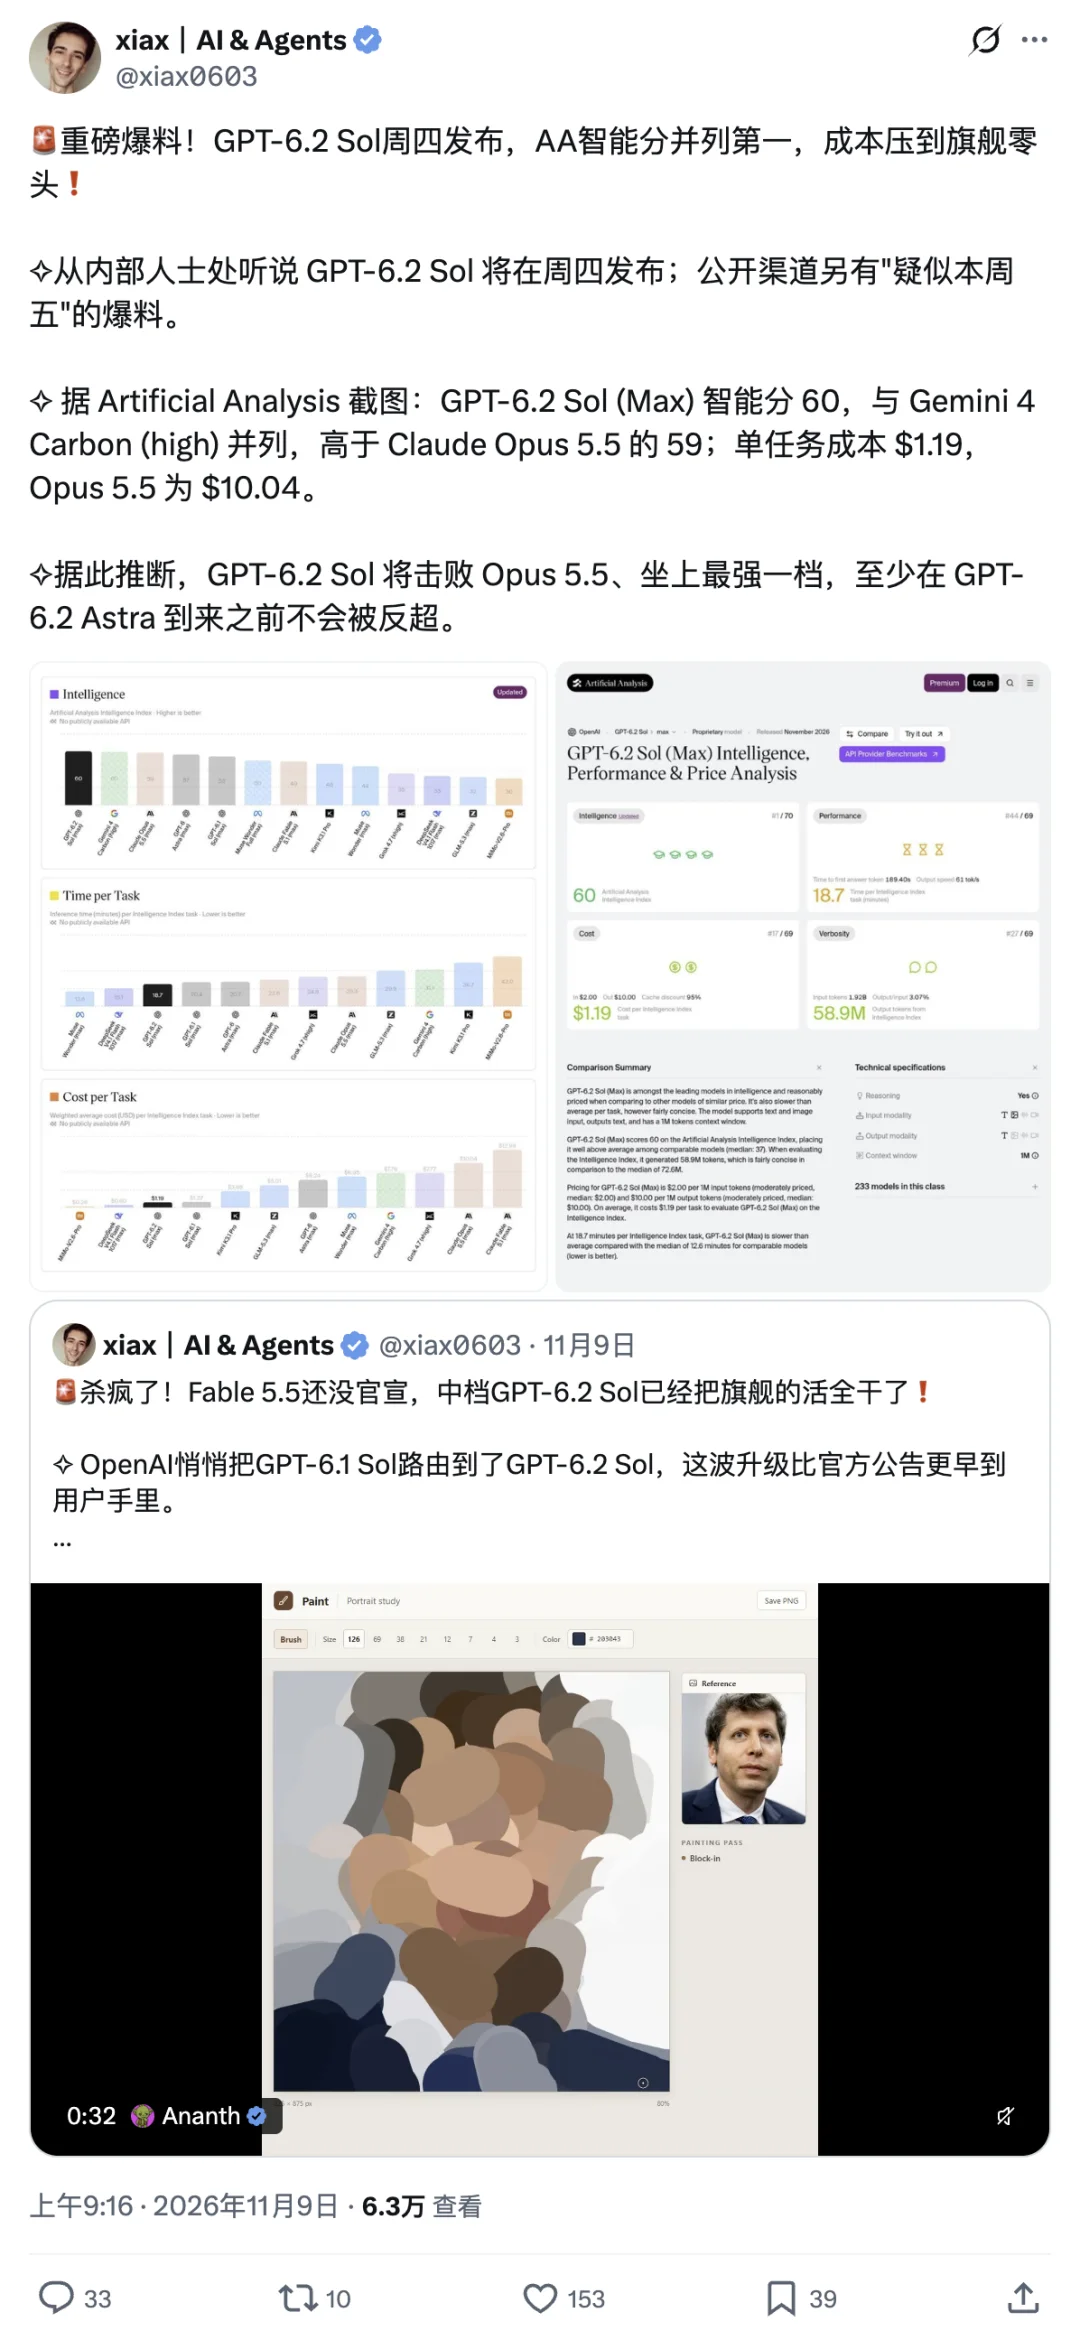
Если верить картинке, в Intelligence Index модель набирает 60 баллов: делит первое место с Google Gemini 4 Carbon, обходит Claude Opus 5.5 (59 баллов), прибавляет сразу 5 баллов к результату прошлой GPT-6.1 Sol и даже опережает старшую GPT-6 Astra — становясь первой моделью OpenAI, которая явно обошла Opus 5.5.
Инженерные и финансовые метрики на скриншоте ещё интереснее: среднее время на сложную задачу снижено до 18,7 минуты, а стоимость задачи — всего $1.19, примерно в восемь раз дешевле Opus 5.5 ($10.04).
Но принимать эти цифры за свершившийся факт рано. Мы проверили сайт Artificial Analysis и документацию OpenAI: по состоянию на 12 ноября никакой GPT-6.2 Sol в рейтинге AA нет, а URL карточки модели со скриншота отдаёт 404. Если поставить цифры из утечки рядом с актуальными данными уже вышедших флагманов на сайте AA, картина становится понятнее:
| Показатель AA | GPT-6.2 Sol (скриншот из сети) | GPT-6.1 Sol (max) | Claude Opus 5.5 (max) | Gemini 4 Carbon (high) |
|---|---|---|---|---|
| Intelligence Index | 60 | 55 | 59 | 60 |
| Время на задачу | 18,7 мин | 21,9 мин | 25,0 мин | 25,7 мин |
| Стоимость задачи | $1.19 | $1.27 | $10.04 | $7.76 |
| Выходные токены за прогон индекса | 58,9 млн | 63,7 млн | 218 млн | 205 млн |
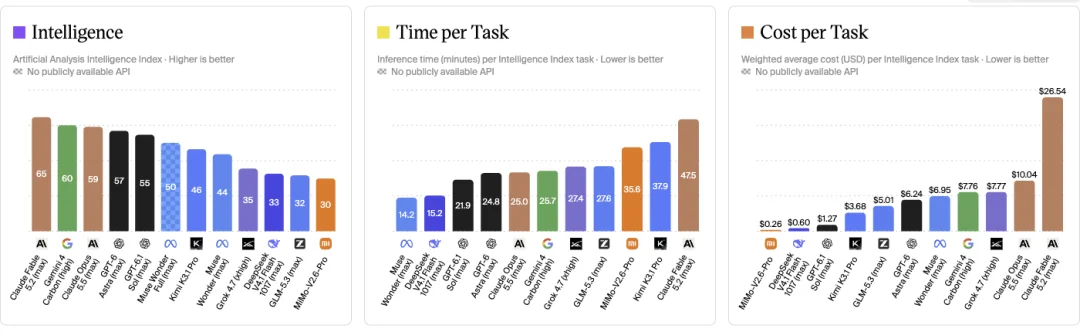
Сначала о времени. 18,7 минуты со скриншота — это примерно на четверть быстрее и Opus 5.5 (25,0 минуты), и Carbon (25,7 минуты), то есть лучший результат среди перечисленных тяжеловесов. Но с одной оговоркой: медиана по моделям того же класса в AA составляет 12,8 минуты, так что быстрой её можно назвать только на фоне самых тяжёлых флагманов, а не по таблице в целом.
Главный же шум поднялся вокруг счёта в $1.19 — в восемь раз дешевле Opus 5.5 и впятеро дешевле GPT-6 Astra ($6.24). Однако если посмотреть на соседний столбец с официальными данными, видно: низкая цена задачи — вообще не новшество версии 6.2. У давно работающей GPT-6.1 Sol задача стоит $1.27 — всего на 8 центов дороже цифр со скриншота. На наш взгляд, если вам нужна недорогая замена тяжёлым флагманам, брать в расчёт можно уже нынешнюю 6.1 Sol, не дожидаясь выхода 6.2.
Сам прайс-лист за токен у линейки Sol самый обычный: GPT-6.1 Sol стоит $2 за миллион входных токенов и $10 за миллион выходных при контекстном окне в 1 млн токенов — стандартные цифры для этого класса. Секрет дешёвой задачи в том, что модель меньше льёт воды: на полный прогон Intelligence Index у 6.1 Sol уходит 63,7 млн выходных токенов, тогда как Opus 5.5 и Carbon переваливают за 200 млн. Ответы короче в несколько раз — отсюда и скромный чек.
Здесь же кроется частая ловушка в расчётах: и у OpenAI, и у Google токены рассуждений тарифицируются по цене выходных. Если не ограничивать глубину размышлений, один запрос легко обходится в несколько раз дороже обычного ответа.
Демо-ролики тоже не заставили себя ждать. По одному промпту пользователи, попавшие в тестовую выборку Sol, получают готовые 3D-сцены на Three.js в одном HTML-файле — без Blender и внешних ассетов: чёрные дыры, парусники и Колизей сразу крутятся в браузере, и эти сцены напрямую сравнивают с выдачей Opus 5.5. Один из тестеров просидел в модели 3 часа подряд, собрал несколько сцен на Three.js и результат понравился ему больше, чем у Opus 5.5.
Для обычных пользователей главный вопрос — как модель ведёт себя в подписке. Для владельцев ChatGPT Plus обновление до Sol называют чуть ли не главным апгрейдом за всё время: в повседневных задачах она обходит Opus 5.5 и при этом не выжигает лимиты использования слишком быстро даже внутри 5-часового окна, так что подписка за $20 снова начинает окупаться.
Впрочем, такие оценки идут в основном от аккаунтов, которые собирают утечки и инсайды до релиза, и написаны в будущем времени. Звучит заманчиво, но мы считаем, что до официального запуска к этим обещаниям лучше относиться со здоровым скепсисом.
Чтобы проверить, переключили ли ваш аккаунт на новую модель при скрытой раскатке, в сообществе используют простой способ: выбирают GPT-6.1 Sol (на уровне Max или xhigh), отключают веб-поиск и память и спрашивают, знает ли она про недавно вышедшую Claude Fable 5 — если отвечает по делу, значит, запрос ушёл уже на новую версию. Те, кому модель уже попалась, отмечают ещё одну приятную деталь: из ответов пропала привычка в каждом абзаце перестраховываться и стелить соломку — тон стал намного прямее.
Вокруг даты релиза тоже хватало ложных тревог. 9 ноября аккаунт разработчиков OpenAI выложил 14-секундный тизер с одним словом «Tomorrow.», ролик собрал больше 2,4 млн просмотров, и вся лента решила, что завтра выкатят модель:
 X · @OpenAIDevsTomorrow.Смотреть в X
На следующий день выяснилось, что модель тут ни при чём: тизер анонсировал ретро-консоль в духе Game Boy в магазине мерча OpenAI (ModRetro Chromatic).
А обещанная слухами «в четверг» GPT-6.2 Sol к четвергу, 12 ноября, в официальной документации OpenAI так и не появилась.
Пока всё это остаётся отзывами с узкой раскатки и скриншотами неизвестного происхождения; окончательные выводы можно будет делать, когда модель выйдет официально и Artificial Analysis проведёт собственный прогон.
Помимо Krypton, в четвёртом поколении Google постоянно сравнивают между собой уже вышедшие Carbon и Argon — и характер у них совсем разный.
| Показатель | Gemini 4 Carbon (high) | Gemini 4 Argon (high) | Источник |
|---|---|---|---|
| Intelligence Index | 60 | 50 | AA |
| Скорость вывода | 80 ток/с | 65 ток/с | AA |
| Время до первого токена ответа | 67 с | 37 с | AA |
| Время на задачу | 25,7 мин | 30,0 мин | AA |
| Уровень галлюцинаций | 11% | 4% | AA-Omniscience |
| Vibe Code Bench | 89,06% | 91,91% | Vals AI (OpenHands) |
| Контекстное окно | 1 млн токенов | 1 млн токенов | |
| Цена за 1 млн токенов (ввод / вывод) | $2 / $10, с 1 декабря $4 / $20 | $2 / $10, с 1 декабря $4 / $20 | Страница цен Google |
У Carbon 60 баллов в Intelligence Index и контекстное окно в 1 млн токенов — её стихия это большие объёмы материалов, задачи по кибербезопасности и долгие автономные прогоны. Минусы тоже на виду: на высоком уровне рассуждений уровень галлюцинаций достигает 11%, а первого токена ответа приходится ждать больше минуты.
Argon по общему индексу ступенью ниже — 50 баллов, зато берёт стабильностью: уровень галлюцинаций всего 4%, а в прикладном кодинговом тесте Vibe Code Bench она набирает 91,91% — выше и Carbon (89,06%), и Opus 5.5 (90,29%). Да и время до первого токена ответа у неё около 37 секунд.
Правда, быстрый старт ответа ещё не означает быструю задачу целиком: по замерам AA, среднее время на задачу у Argon составляет 30,0 минуты — на 4 с лишним минуты дольше, чем у Carbon (25,7 минуты).
Обе модели до 30 ноября идут по вводной цене $2 за миллион входных и $10 за миллион выходных токенов, а с 1 декабря тариф вернётся к $4 и $20. На старте Carbon давали только узкому кругу команд по киберзащите, с 10 ноября API открыт для всех платных разработчиков, но на бесплатном уровне обе модели недоступны.
Медлительность — главная претензия к Carbon в реальной работе. Theo (t3.gg) прогнал одну и ту же задачу по программированию: Opus 5.5 на уровне high справилась за 9 минут 33 секунды, а Carbon даже на минимальном уровне low возилась 22 минуты 21 секунду.
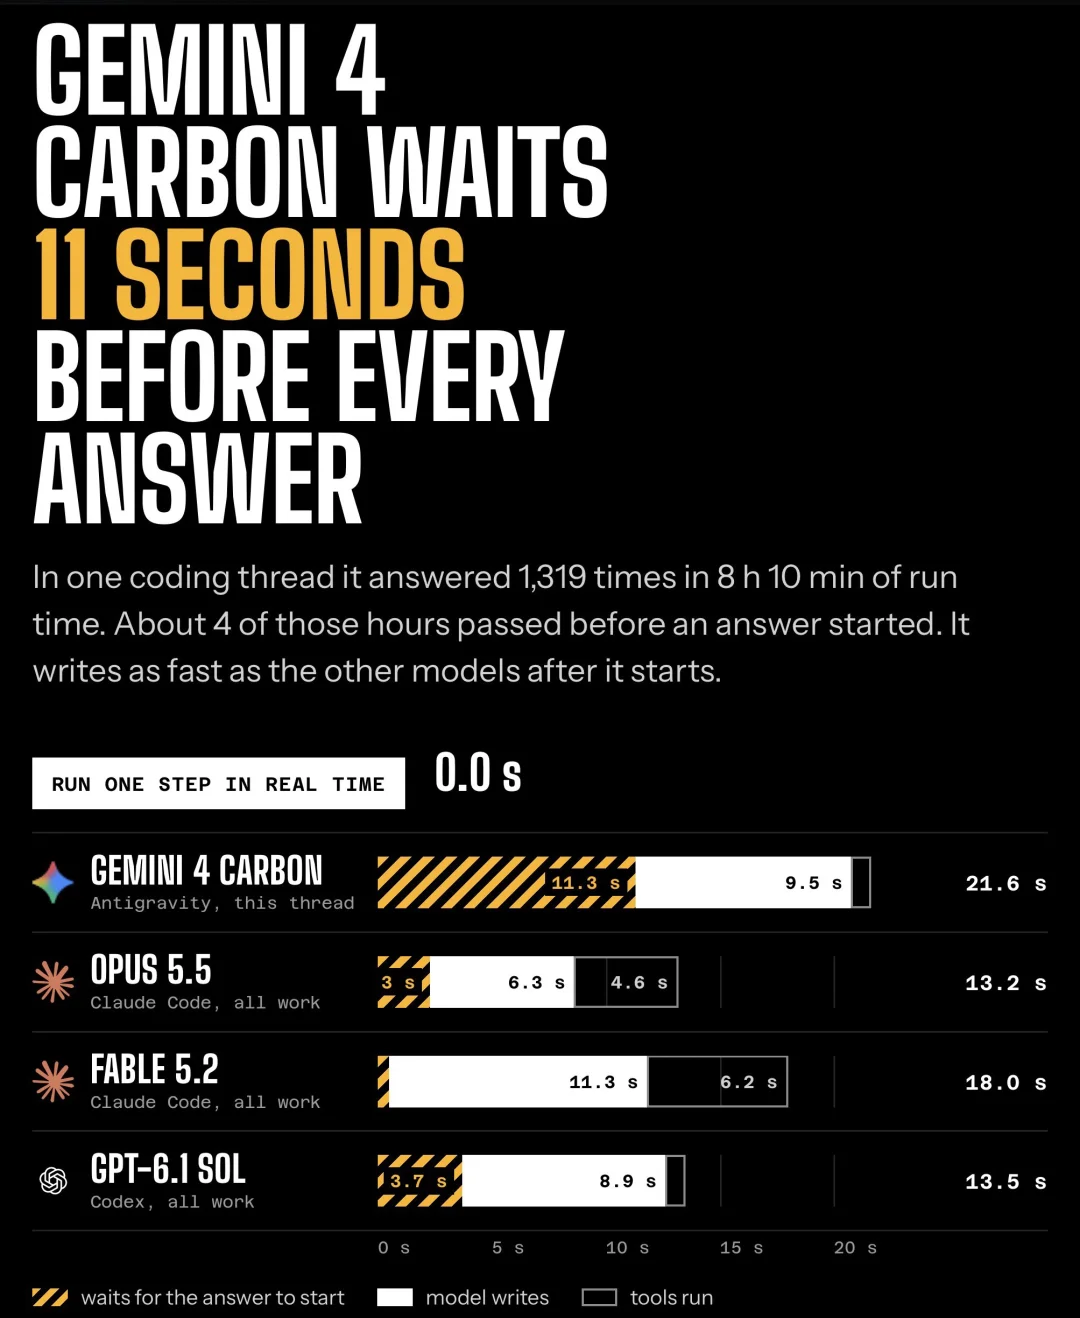
Если разложить один шаг по секундам, видно, где теряется время: перед каждым ответом Carbon просто молчит по 11 с лишним секунд, а когда начинает писать, печатает не медленнее остальных. За сессию длиной 8 часов 10 минут модель ответила 1,319 раз, и около 4 часов из них ушло на ожидание старта генерации. Проблема здесь явно на стороне серверов инференса Google, а не в самой модели.
К задержкам добавляются жёсткие квоты. Даже в максимальной подписке Google за $200 в месяц квота на полноценную Gemini 4 крошечная и выгорает моментально. Технология сильная, но как массовый пользовательский продукт она пока буксует.
Отдельно стоит сравнить расход токенов по методике AA Intelligence Index: за полный прогон всех тестов Carbon выдаёт 205 млн выходных токенов, Argon — 113 млн, а GPT-6.1 Sol — 63,7 млн. При одинаковом прайсе за токен итоговый чек расходится в разы: по расчётам AA, задача на Argon стоит $9.95, на Carbon — $7.76, а на GPT-6.1 Sol — $1.27. Всё упирается в то, как долго модель думает и сколько текста генерирует — та же самая экономика токенов рассуждений, с которой мы столкнулись в начале.
И ещё одна деталь при чтении рейтингов — приписка в скобках после названия модели: Carbon и Argon в AA тестировали на уровне high, а Opus 5.5 и Sol — на max. Уровни рассуждений и оснастка (harness) у разных прогонов не совпадают, поэтому разницу в один-два балла в таблице не стоит воспринимать как безусловную победу.
Практичнее всего к вопросу подошли тестеры, которые просто поделили работу между тремя семействами:
Модели, которая выигрывала бы везде, сейчас нет. Даже если Sol действительно догонит Carbon по баллам, на задачу она всё равно тратит больше времени, чем медиана по классу; Carbon сильна на длинной дистанции, но заставляет мириться с долгим ожиданием и 11% галлюцинаций; Argon надёжнее, но уступает ступень по общему индексу. Что до Opus 5.5, она заметно дороже Sol и за токен, и за задачу, а в замерах AA первого токена ответа от неё ждут почти 6 минут — дорого и неспешно, но в коде её репутация по-прежнему самая крепкая. Разница в пару баллов в бенчмарке и реальное удобство на вашей задаче — совершенно разные вещи.
Пока Krypton и GPT-6.2 Sol ещё в пути, эту же схему разделения труда можно собрать из четырёх уже работающих моделей. На CodingPass все они доступны по одному API-ключу — чтобы сменить модель, достаточно поменять её ID (месячные квоты по тарифам собраны на странице всех моделей):
| Модель | ID модели | Статус | Минимальный тариф CodingPass |
|---|---|---|---|
| Gemini 4 Krypton | — | Внутренний тест в Google | — |
| GPT-6.2 Sol | — | Тест на части аккаунтов, не вышла | — |
| Gemini 4 Argon | gemini-4-argon | Доступна | Go |
| Gemini 4 Carbon | gemini-4-carbon | Доступна | Go |
| GPT-6.1 Sol | gpt-6.1-sol | Доступна | Plus |
| Claude Opus 5.5 | claude-opus-5-5 | Доступна | Plus |
Выбирая модель под конкретное дело, полезнее сначала решить, что вам сейчас важнее — вылизать детали или быстро прогнать объём, — и уже под это выставить уровень рассуждений, чем всматриваться в один-два балла разницы в таблицах. На сложной визуализации или архитектуре выкрутите уровень рассуждений на максимум и дайте модели подумать; на быстрых вопросах прижмите его пониже, чтобы не оплачивать длинную цепочку самопроверок ради простого ответа. Именно этот переключатель чаще всего решает и скорость работы, и сумму в счёте.
Волна релизов 2026 года вернула выбор инструмента самому разработчику. Вместо того чтобы ждать одну модель-победителя на все случаи жизни, проще разбить задачи по типам и ставить на каждую ту, что справляется лучше. Когда инструментов много, умение переключать их экономит больше, чем ожидание следующего релиза.
Переключайте модели по одному ключу со списанием по официальным ценам API. Никаких неожиданных списаний, отмена в любой момент.