Claude Fable 5.2 发布:跑分、价格和小编体感
Fable 5.2 的官方跑分、降价后的价格、推理强度怎么选,以及在 CodingPass Pro 上怎么切换。
OpenAI 这次所有官方图表的横轴都是“每项任务花多少钱”。省钱是真的,Astra 在 Agents' Last Exam 上的单任务成本只有 Fable 5.2 的 5%。可写代码没进步,幻觉变多,做方案的可读性被实测者吐槽。本文把官方数字、AA 评测和社区反馈对着看。
OpenAI 发布了 GPT-6.2 Astra 和 GPT-6.2 Sol。Astra 是新的旗舰,官方说给“最棘手的项目”用;Sol 是日常主力。ChatGPT、Codex 和 API 同一天上线,API 里的模型 ID 是 gpt-6.2-astra 和 gpt-6.2-sol。
从 11 月初就有人在 ChatGPT 里灰测到 GPT-6.2 Sol,正式发布拖了将近 20 天。等来的版本,卖点只有一个:便宜。OpenAI 发布页里几乎每张图的横轴都是“每项任务成本”,Astra 官方价降了 20%,单任务成本动辄只有对手的几分之一。
可是把发布页、Artificial Analysis(AA)的独立评测和开发者实测放在一起看,这一代在写代码上没有进步,幻觉率反而升了,做方案和沟通依旧是短板。开发者社区的反馈更差:发布第二天,不少人已经切回 Claude。
一句话:GPT-6.2 省钱是真的,变强只在科研、3D 和法律文档这些地方。AA 编程 Agent 指数上 Astra 和 GPT-6 Astra 持平(53),Sol 比 GPT-6.1 Sol 还低 3 分;幻觉率 Astra 从 50% 升到 59%。真拿它干长活的开发者,抱怨集中在跑长任务原地打转、跑完说不清做了什么。写代码继续用 Claude,审代码换成 GPT-6.2 Sol 最划算。
发布页上全是好看的成本曲线,开发者社区的风向却在一天之内转了。Hacker News 的发布讨论和 X 上,对 Astra 的抱怨明显多过夸奖,问题也很集中。
长任务原地打转。反响最大的一篇来自 T3 Code 的作者 Theo:早期测试期间他给 OpenAI 写了一封长信,11 月 17 日全文公开,标题就叫“Why I hate GPT-6.2 Astra”,一天浏览超过 175 万。他拿一个用 Rust 重写 TypeScript 编译器的项目测新模型,此前 OpenAI 的模型在上面烧了 30 多万美元的 token 也没做出进展,Opus 不到两周、约 2 万美元就做完了。换成 GPT-6.2 Astra,连跑 7 天没落下一处改进,还执着于“顺便把体积做小”,把编译器拖慢了 56%;让它改攻性能,又跑了 4 天,零改动。另一个任务跑到第 2 个小时,它停下来问他一个内部中间文件该叫哪个名字,把自己卡住了。
跑完说不清做了什么。这和后面实测里“方案读起来云里雾里”是同一个毛病。Theo 已经养成习惯:Astra 长任务跑完,切到 Opus 5.5 让它总结一遍。他问一台机器上的 worktree 为什么比另外三台慢,Astra 写了四段 pnpm 缓存机制,Opus 5.5 只回了一句“SSD 慢”。改系统提示词、让它“讲简单点”,都没用。
工程判断要人盯着。HN 上有人说 Astra 很聪明,但要大量盯着、仔细写提示词,这些 Opus 5.5 都不需要;也有人说 Sol 还是爱过度设计,Astra 的代码质量配不上这个价。审查结论也会注水:有人让 Astra 审一段生产代码,列出 12 个问题、其中 8 个 P2,交给 Fable 5.2 一起过了一遍,最后只剩 8 个 P3。
速度没变。有人实测两款新模型都在每秒 20–80 token,和上一代一样,约是 Anthropic 模型的五分之一。还有人直接说 OpenAI 这两个月状态不好,自己已经从 Astra 换回 Opus 5.5。
好评也有,而且落在跑分强的地方:Theo 自己也承认 Astra 是很好的代码审查者,3D 和游戏世界一流,电脑操作很强;HN 上有人觉得 Sol 比 Opus 5.5 好用,UI 设计稿第一次追上 Claude。
我们觉得,跑分和体感对不上的地方,恰好是跑分不太测的东西:长任务里会不会自己卡住、跑完能不能把话说清楚。成本曲线算的是单次任务,没算人盯着它、再找另一个模型翻译它输出的时间。
Astra 的输入、输出价各降 20%,缓存读取从每百万 token $1 降到 $0.40。Sol 价格不变。Astra 的 $8 / $40 和 Fable 5.2 降价后的官方价一模一样,上一代 GPT-6 Astra 定价时也是和 Fable 5 对齐的。
| 模型 | 输入 | 缓存读取 | 缓存写入 | 输出 | 知识截止 |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $40 | 2026-05-18 |
| GPT-6 Astra | $10 | $1 | $12.50 | $50 | 2026-04-30 |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $10 | 2026-06-01 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $10 | 2026-04-30 |
两款都是 1,050,000 token 上下文、最多 128,000 token 输出。价格表下面还有几行小字,长任务用户要看清楚(出自 OpenAI 的模型文档):
知识截止往后挪了半个月到一个月。灰测期间,大家就是靠这一点分辨新旧版本的:断网问它知不知道 Fable 5,GPT-6 Astra 和 GPT-6.1 Sol 都不知道。
OpenAI 主打的是 Agents' Last Exam,评的是多步骤的长程专业工作。Astra 开到超高(xhigh)推理强度得 78.3%,单任务 $2.89;Fable 5.2 开到 Max 是 72.8%、$60.05。OpenAI 的说法是“高 5.5 分,成本只有 5%”。
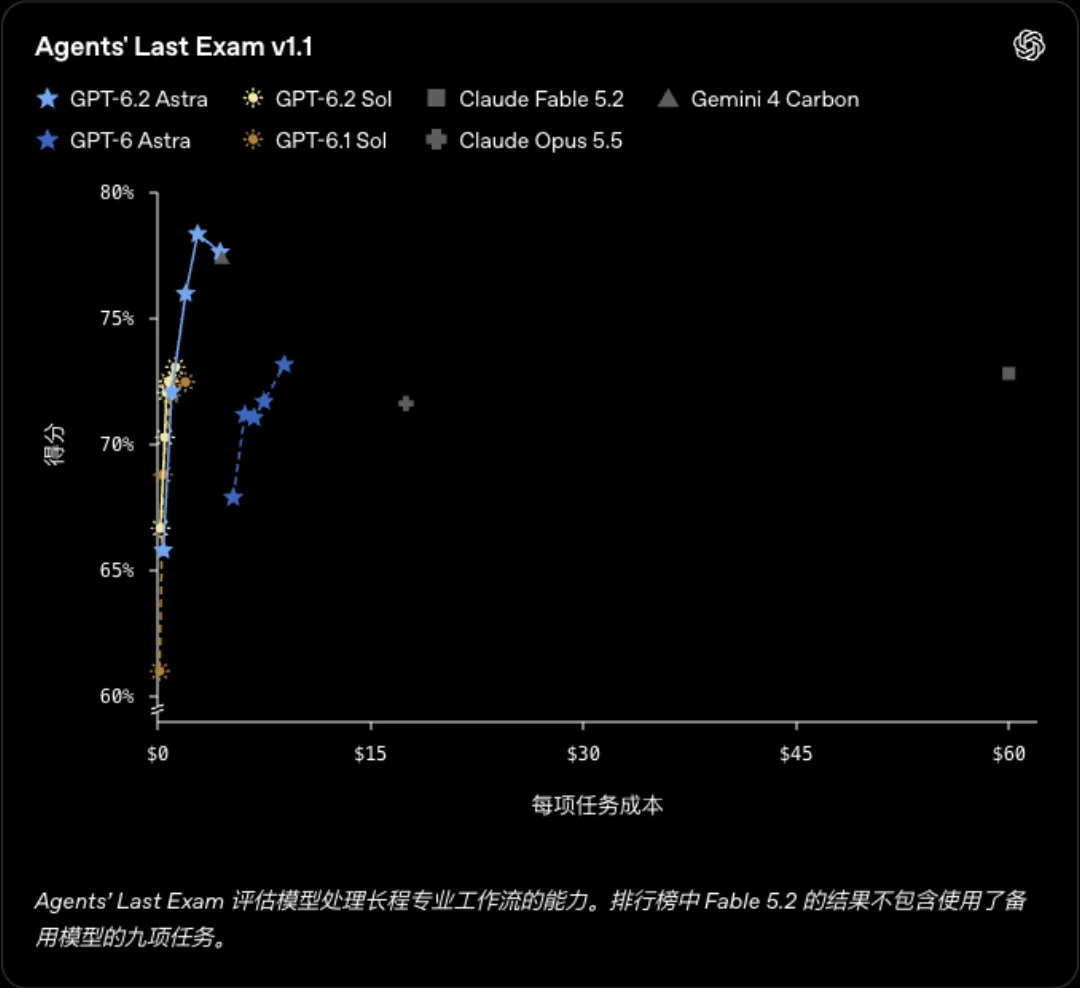
这张图值得多看两眼:
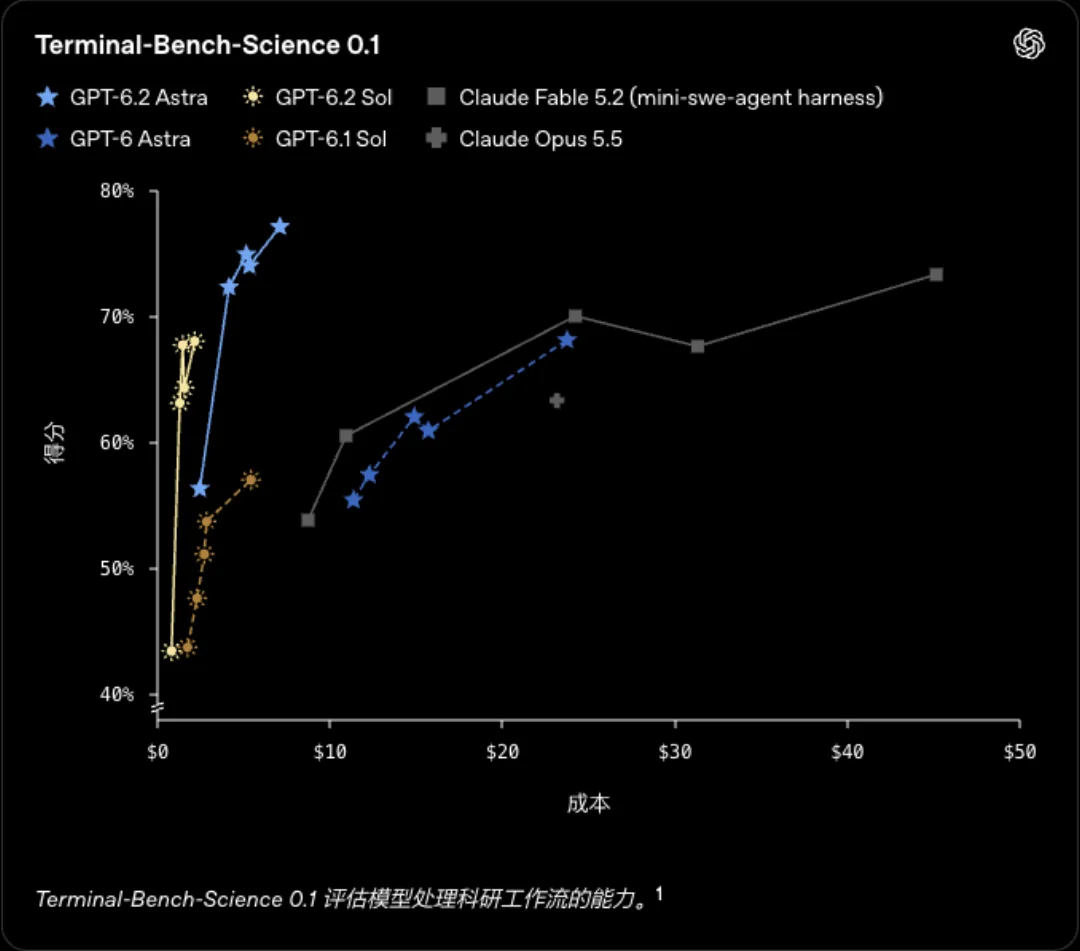
其他几项官方评测,数字整理如下(都取各模型的最高分档位):
| 评测 | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | Claude Fable 5.2 |
|---|---|---|---|---|
| Agents' Last Exam | 78.3%($2.89) | 73.0%($1.32) | 73.1%($8.99) | 72.8%($60.05) |
| Terminal-Bench-Science 0.1 | 77.1%($7.15) | 68.0%($2.21) | 68.1%($23.80) | 73.3%($45.21)* |
| FrontierCode 2.0 | 44.2%($5.97) | 43.8%($1.29) | 42.8%($6.68) | 49.1%($14.19) |
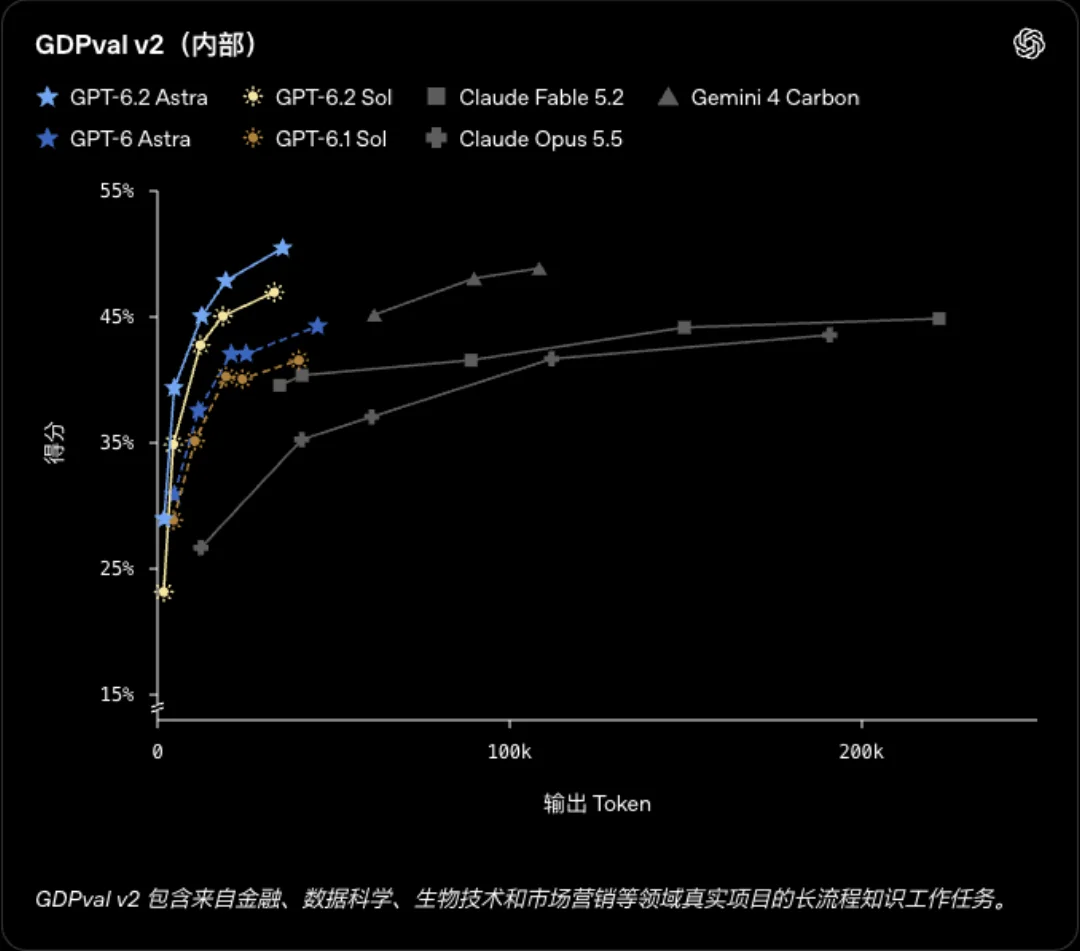
| GDPval v2(OpenAI 内部) | 50.4% | 46.9% | 44.2% | 44.8% |
| Harvey LAB-AA v1.1 | 15.0%($6.35) | 11.1%($1.92) | 8.6%($13.67) | 7.2%($39.84) |
| LifeVal | 86.1%($4.23) | 83.8%($1.27) | 79.8%($9.04) | — |
* Fable 5.2 的 Terminal-Bench-Science 成绩来自 AA,跑在 mini-swe-agent 框架里。脚注里 OpenAI 自己也写了:Anthropic 报告的 Fable 5.2 在 Claude Code 里开 Max 是 74.6%。
科研是这次最硬的一项。Terminal-Bench-Science 评的是在终端里做科研,Astra 比 GPT-6 Astra 高 9 个百分点,成本不到三分之一。OpenAI 因此把 Astra 称为“全球最适合科学家的模型”,Vals Science Index 上它也是第一。做科研的人一直拿 GPT 当主力,这一代把优势又拉大了。
GDPval v2 和法律任务。GDPval v2 是 OpenAI 内部的评测,用咨询、金融、设计等真实项目里的长流程工作来考。Astra 比 GPT-6 Astra 高 6.2 个百分点,输出 token 少用 22%;Sol 比 GPT-6.1 Sol 高 5.3 分。法律评测 Harvey LAB-AA 上,Astra 的通过率是 Fable 5.2 的两倍多,成本约六分之一。但这项评测只在交付物满足全部要求、且没有实质性幻觉时才算通过,Astra 的 15% 意味着 85% 的任务仍然不合格。
低推理强度明显变差。LifeVal 测的是筛幼儿园、找房、做膳食计划这类日常事务。开到 Max,Sol 83.8%、成本是 GPT-6 Astra 的七分之一;可开到低(low),Sol 只有 25.3%,GPT-6.1 Sol 在同一档是 66.8%。Astra 的低档也从 67.5% 掉到 46.3%。想靠低推理强度省钱的,这一代反而要多掂量。
OpenAI 在发布页上说 Astra 的代码“更简洁”“更擅长在现有代码库里实现和测试复杂改动”。可它自己放出的 FrontierCode 2.0 图,讲的是另一件事。
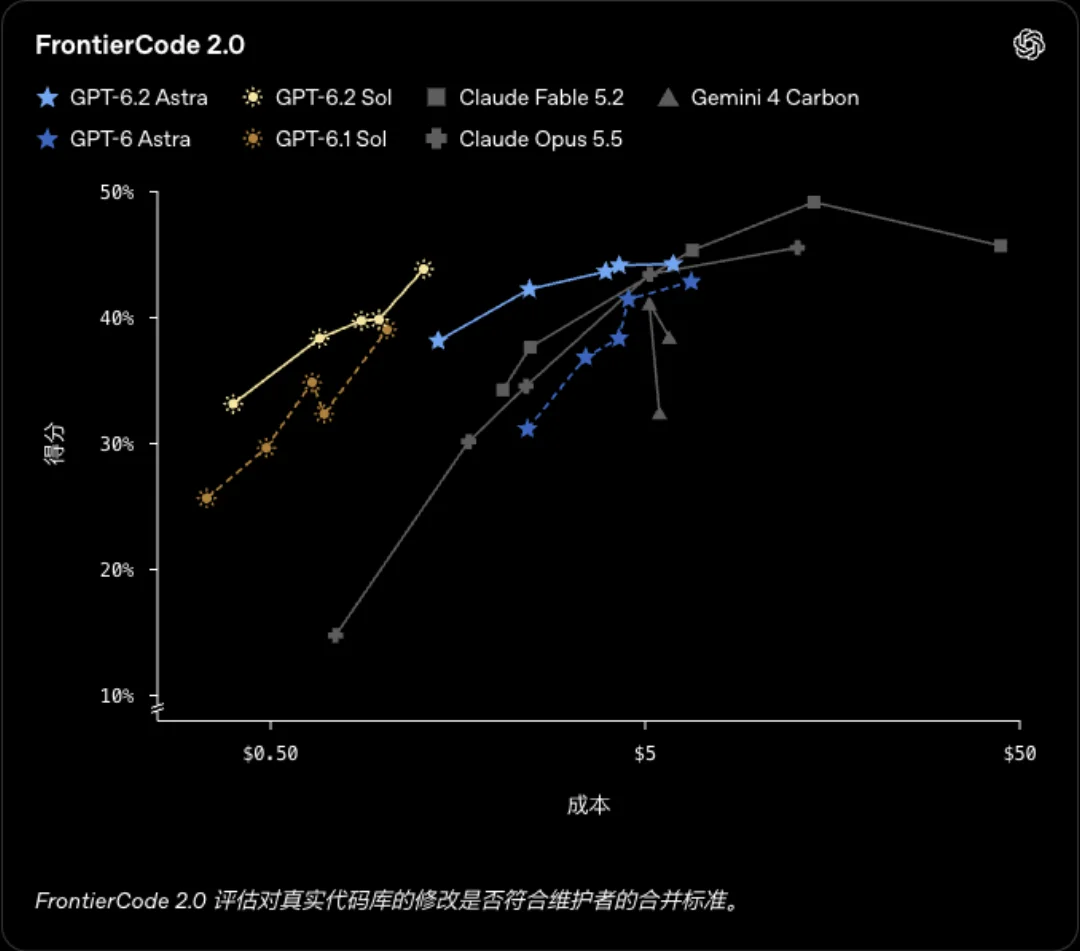
FrontierCode 2.0 评的是改动能不能达到维护者的合并标准。Astra 最好成绩 44.2%,低于 Fable 5.2 的 49.1%,也低于上一代 Claude Opus 5.5 的 45.5%;比 GPT-6 Astra 只高 1.4 分。发布页挑出来讲的是另一个数字:Sol 和 Astra 相差不到 0.5 分,成本约五分之一。
AA 的独立评测更直接。在 AA 编程 Agent 指数(用 Codex 框架、开到 Max)上,GPT-6.2 Astra 53 分,和 GPT-6 Astra 一样;GPT-6.2 Sol 49 分,比 GPT-6.1 Sol 低 3 分。Claude Code 里的 Fable 5.2 和 Opus 5.5 都是 58。
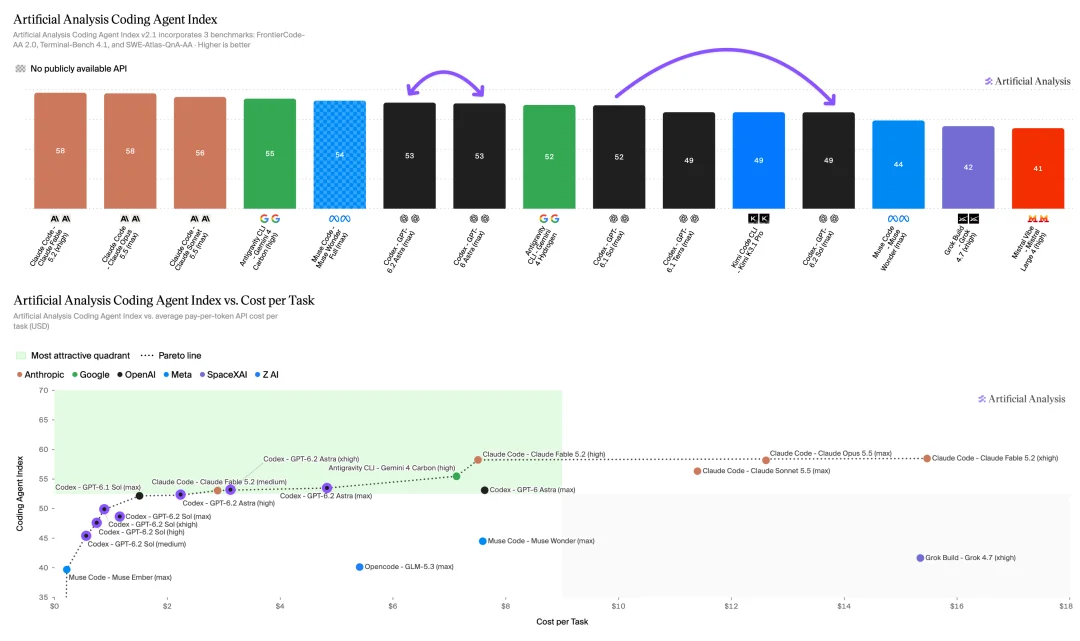
AA 给的原因是:Sol 在 SWE-Atlas-QnA-AA 上掉了 14 分,回答里比上一代更容易漏掉关键事实。AA 也承认,按单任务成本算,Astra 和 Sol 的好几档推理强度都在帕累托前沿上,省钱这点没有争议。
AA 智能指数 v5 整合了九项评测。GPT-6.2 Astra 开到 Max 得 62 分,比 GPT-6 Astra 高 5 分,超过 Gemini 4 Carbon(60)和 Claude Opus 5.5(59),排在 Claude Fable 5.2(65)之后,第二。GPT-6.2 Sol 57 分,比 GPT-6.1 Sol 高 2 分,和 GPT-6 Astra 持平,单任务成本约是后者的 15%。
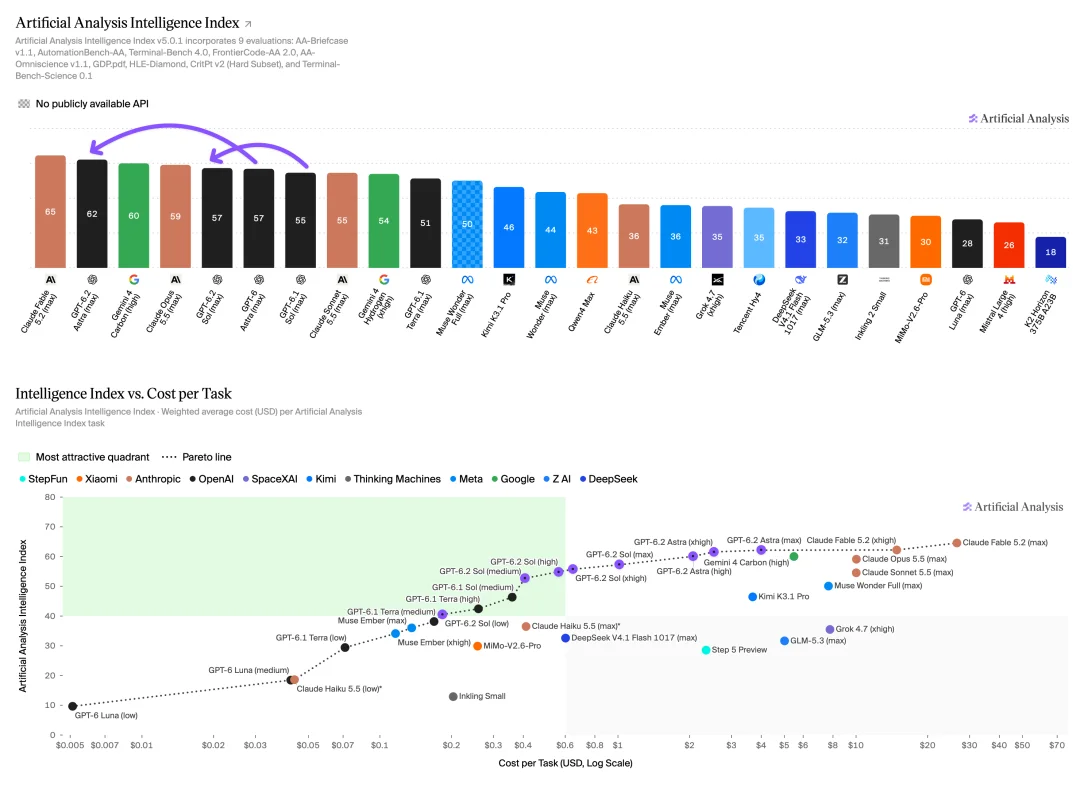
灰度期间网上传过 GPT-6.2 Sol 的 AA 指数是 60、追平第一。实际出分是 57,比传言低 3 分。
成本低的原因在输出 token。AA 统计了跑一项智能指数任务平均要输出多少 token:
| 模型(档位) | 输出 token / 任务 | 输出价(每百万) | 输出费用 / 任务 |
|---|---|---|---|
| GPT-6.2 Sol(Max) | 40K | $10 | $0.40 |
| GPT-6.2 Astra(Max) | 41K | $40 | $1.64 |
| GPT-6 Astra(Max) | 52K | $50 | $2.60 |
| Gemini 4 Carbon(High) | 123K | $10 | $1.23 |
| Claude Fable 5.2(Max) | 274K | $40 | $10.96 |
Fable 5.2 和 Astra 每百万 token 一个价,跑同一项任务,Fable 5.2 输出的 token 是 Astra 的 6.7 倍。纸面价一样,账单差出一个数量级。有开发者拿 $200 的 ChatGPT Pro 做过对比:用 Astra 跑了 4 个视频和 3D 案例、2 份大方案和近百次代码审查,花掉 6% 的周额度;之前用 Fable 5.2 跑 10 个案例,烧掉了近 30%。
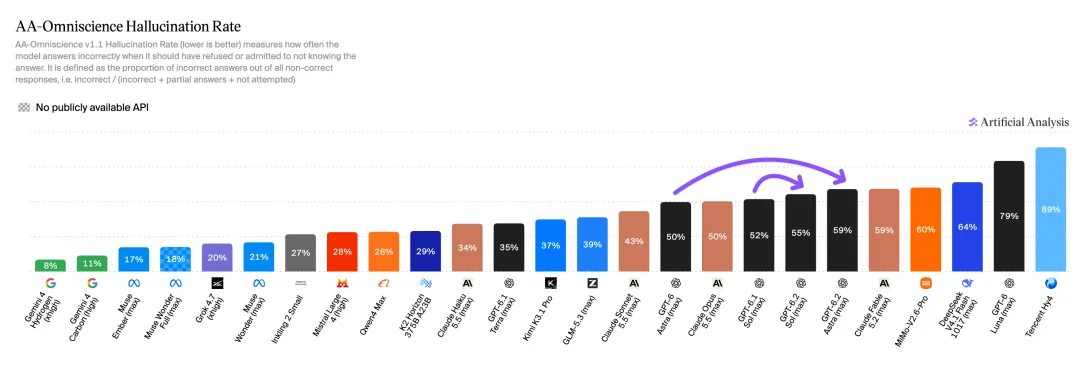
省下来的 token 有代价。AA-Omniscience 测的是模型不知道答案时会不会硬猜,GPT-6.2 Astra 的幻觉率是 59%,GPT-6 Astra 是 50%;Sol 从 GPT-6.1 Sol 的 52% 升到 55%。Gemini 4 Carbon 只有 11%。
有开发者用自己的项目跑了几组测试,结果和上面的数字对得上:擅长的更强了,不擅长的还是老样子。
代码审查进步最大。拿 Claude 写完的代码交给 GPT 审,最多三轮,这是不少人现在的固定流程。在实测者自建的小评测集上,都开到 xhigh:GPT-6.1 Sol 找出 65% 的问题,GPT-6.2 Sol 84%,GPT-6.2 Astra 96%。Astra 比 Sol 慢一倍、贵 4 倍,多找出十几个 bug。实测者的结论是 GPT-6.2 Sol xhigh 以后就是默认的审查模型。
做方案和沟通依旧吃力。同一个需求(给一个个人维护的资讯站加留言区,要合规、成本最低),Gemini 4 Carbon 5 分钟交出方案:先列出实名制、先审后发等合规要求,再给最小成本设计(不开自定义昵称、不做多层盖楼、只放精选),审核复用站里已有的 Agent 自动审查,最后列对比让人选。GPT-6.2 Astra 跑了 24 分钟,回复不长,但读起来云里雾里,还建议前期用人工审核,对一个人维护的项目并不现实。实测者的感受是,Astra 在可读性和主动规划上甚至不如初期的 GPT-6 Astra。
审美两极。同一个提示词做一支 ChatGPT 四周年致敬动效视频,Fable 5.2 和 Gemini 4 Carbon 的成片都能看,Astra 的成片被实测者形容为“看完都沉默了”。3D 是例外:第一人称跑酷游戏、Three.js 做的秋日乡村火车站、按参考图重建的古希腊城邦,Astra 的效果都超出预期,最后一个跑了一个多小时。
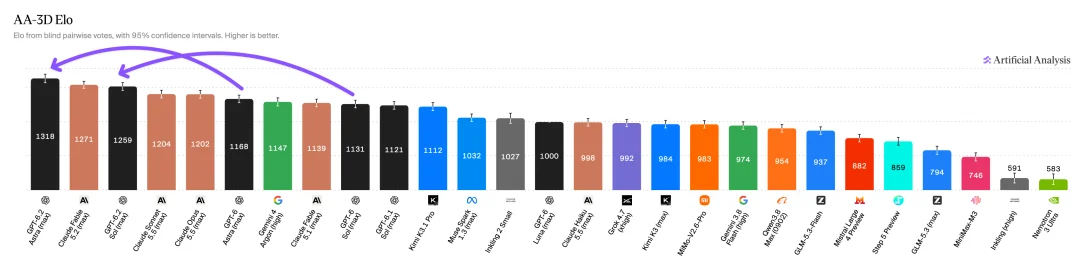
AA 的 3D 评测给了同样的结论。AA-3D 由人类评审盲选两个作品里更喜欢的一个,GPT-6.2 Astra 以 1,318 分第一,Fable 5.2 1,271,GPT-6.2 Sol 1,259。AA 的机器人评测(研究预览版)上,Astra 79、Sol 78,也高于 Fable 5.2 的 75。
OpenAI 发布页还放了几个 Astra 的案例:按 8% 折现率、3% 永续增长率建一份可编辑的估值工作簿;照公司模板做 19 页的幻灯片,字号都对得上;在 CAD 和仿真工具里逐个零件给遥控越野车和直列六缸发动机建模;做了一款能玩的竞速游戏 Meridian Sound Racing。AA 的 AA-AnalystAgent 上,Astra 有 62.5% 的问题五次独立尝试全对。
几处不足,OpenAI 在发布页和 GPT-6.2 系统卡里自己写了:
官方单价没法直接比,下面用 OpenAI 发布页公布的单任务成本,按 100 次和 1,000 次任务算一笔账。“按得分折算”是单次成本除以得分,粗略估计做成一次要花多少,没算人工返工的时间。
| 模型(档位) | 得分 | 单任务 | 100 次 | 1,000 次 | 按得分折算 |
|---|---|---|---|---|---|
| GPT-6.2 Sol(Max) | 73.0% | $1.32 | $132 | $1,320 | $1.81 |
| GPT-6.2 Astra(xhigh) | 78.3% | $2.89 | $289 | $2,890 | $3.69 |
| Gemini 4 Carbon(High) | 77.4% | $4.60 | $460 | $4,600 | $5.94 |
| GPT-6 Astra(Max) | 73.1% | $8.99 | $899 | $8,990 | $12.30 |
| Claude Opus 5.5(Max) | 71.6% | $17.57 | $1,757 | $17,570 | $24.54 |
| Claude Fable 5.2(Max) | 72.8% | $60.05 | $6,005 | $60,050 | $82.49 |
Gemini 4 Carbon 的单任务成本按引入期价格算,12 月 1 日起 Carbon 的单价翻倍。
写代码换成 FrontierCode 2.0 再算一遍,看做出一个能合并的改动大概要花多少(单任务成本 ÷ 得分):GPT-6.2 Sol $2.95,GPT-6.2 Astra $13.51,Claude Opus 5.5 $28.18,Claude Fable 5.2 $28.90。我们觉得,GPT-6.2 真正的位置在这张表里:Sol 用不到 Fable 5.2 九成的分数,换来约十分之一的成本;Astra 在写代码上夹在中间,比 Sol 贵 4.6 倍,分数只高 0.4 分。
| 工作负载 | 推荐 | 理由或代价 |
|---|---|---|
| 写代码、大型重构 | Claude Fable 5.2 / Opus 5.5 | FrontierCode 和 AA 编程 Agent 指数都领先;Fable 5.2 很费 token |
| 代码审查、找 bug | GPT-6.2 Sol(xhigh) | 实测查出率 84%,单价是 Astra 的四分之一;要 96% 再开 Astra |
| 科研、数据分析、终端里跑实验 | GPT-6.2 Astra | Terminal-Bench-Science 第一,成本约是 Fable 5.2 的六分之一 |
| 3D、Three.js、游戏原型 | GPT-6.2 Astra | AA-3D 第一;视频、动效类审美仍弱 |
| 方案规划、和人沟通 | Gemini 4 Carbon / Claude | GPT-6.2 可读性差、耗时长 |
| 查事实、写需要准确引用的内容 | Gemini 4 Carbon | GPT-6.2 幻觉率 55%–59%,Carbon 11% |
| 大批量、低成本 Agent 任务 | GPT-6.2 Sol(中档以上) | 不要开低档,LifeVal 上低档只有 25.3% |
一个常见的组合是让 Claude 或 Gemini 出方案、写代码,GPT-6.2 去执行严谨的子任务和审查。GPT 系列严谨、听话、信息密度高,做科研和算法的人用着顺手;但要它主动规划、把话说清楚,这一代还是不行。
GPT-6.2 Sol 在 Plus(每月 $30)、Pro 和团队套餐可用,Plus 上每月最多 $200。GPT-6.2 Astra 在 Pro(每月 $100)和团队套餐可用,Pro 上每月最多 $500。额度按 OpenAI 官方 API 价计量,缓存读取同样按官方价扣。
codex -m gpt-6.2-sol # 审代码、日常 Agentcodex -m gpt-6.2-astra # 科研、3D接入步骤见 Codex 接入指南,OpenCode、Cline 等工具在模型列表里填同样的 ID。只写代码、不需要 GPT 的话,不必为它升级:Go 的 Claude Sonnet 5.5 和 Plus 的 Opus 5.5 写代码都比 GPT-6.2 稳。