全部模型
每个模型的 ID、最低档位,以及在 Go、Plus、Pro 上的月额度。
腾讯混元从 Hy4 自蒸馏出 Hy4 flash,输入、输出单价分别是 Hy4 的 1/12 和 1/9,PPT、文档、表格这类办公任务单任务约 0.2 元。附录里的编程评测掉得厉害,长程写代码还得用 Hy4。本文整理完整跑分、盲测、按调用量算的账单和本地部署要求。
11 月 16 日,腾讯混元发布了 Hy4 flash,官方的定位是“迄今为止最高性价比的 Hy 模型”。它是 Hy4 的轻量版:总参数 224B,其中 64B 是 Engram 参数,每 token 激活 12B,支持图文多模态输入和 1M 上下文。API 每百万 token 输入 0.5 元、输出 2 元,缓存命中 0.02 元,权重同时开源。
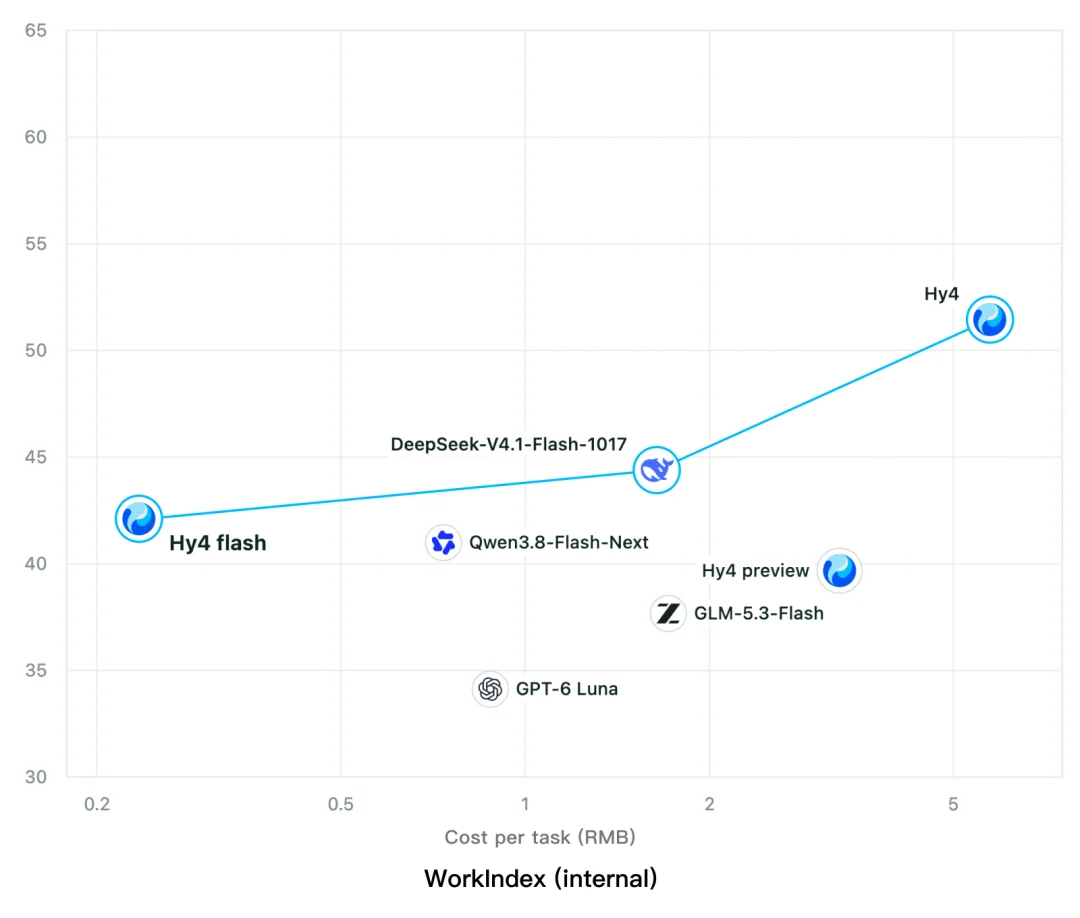
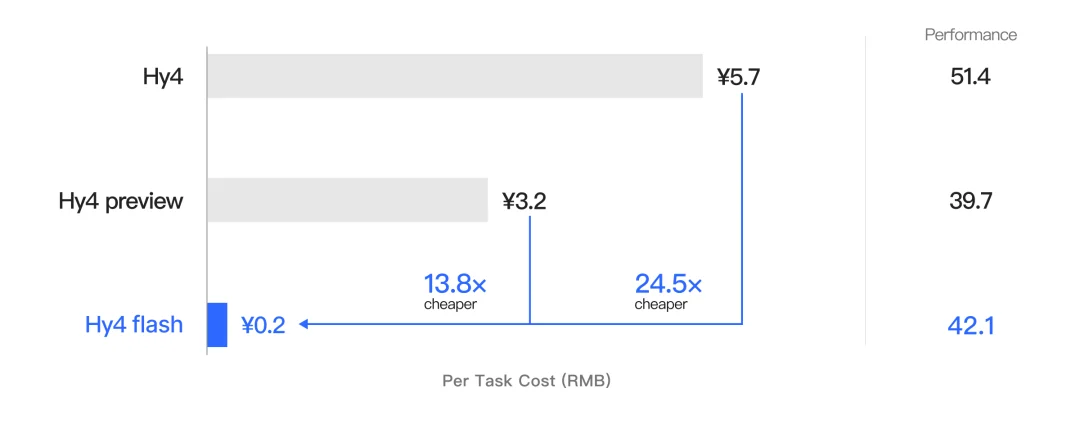
这次混元没有拿公开榜单当主角,主打的是自建评测集 WorkIndex。在 PPT、文档、表格这类日常办公任务上,Hy4 flash 拿到 42.1 分,比 Hy4 preview(39.7)略高;单任务成本 0.2 元,Hy4 要 5.7 元。
结论:做文档、PPT、搜索、简单页面这类日常 Agent 任务,Hy4 flash 在同档对比的几个模型里单价最低。按 CodingPass 的实际流量结构算,每次请求约 0.0064 元,约为 Hy4 的 1/12、DeepSeek-V4.1-Flash 高峰价的 3/10。写代码不要用它:附录里 Terminal-Bench 4.0 只有 19.2(Hy4 44.4,DeepSeek-V4.1-Flash 40.0),ProgramBench 16.0(Hy4 30.0)。官方自己也建议,长程软件工程用 Hy4。
降成本先落在架构上:Hy4 flash 加入了混合注意力、LatentMoE、Engram 等架构特性,KV cache 只有 Hy3 的 1/24、Hy4 的 1/6。混元说,这些改动在预训练前用大量 scaling ladder 实验验证过。
训练分两步:先从 Hy4 自蒸馏,得到综合能力;再用强化学习,把端到端任务的输出长度减少 50%。推理侧结合 megakernel、4bit 量化和 DFly 投机解码,官方给的解码速度是 150 tps 以上。
GitHub 上的 README 给了更细的结构:
| 项目 | Hy4 flash |
|---|---|
| 总参数 | 主干 155.5B + Engram 63.5B + 视觉编码器 0.43B + DFly2 0.85B,合计约 220B |
| 每 token 激活 | 文本 11.3B + 视觉 0.43B |
| 层数 | 42 层:1 层稠密 + 41 层 MoE |
| 专家 | 每层 512 个路由专家,每 token 激活 16 个,另有 1 个共享专家;路由专家在低维潜空间里计算(LatentMoE) |
| 注意力 | 稀疏注意力(IndexPool,每次最多选 2,048 个位置)与滑动窗口注意力(窗口 512 token)按 1:3 交错 |
| Engram | 用多头哈希查表取出二元、三元词组的表示,接在第 1、11、21、31 层(从 0 开始计) |
| 视觉编码器 | 改自 SigLIP2-So400m,经 MLP 接入主干 |
| 投机解码 | 内置 5 层 drafter DFly2,复用主模型的 KV cache 和稀疏注意力选出的位置,不额外占 KV 显存 |
| 上下文 | 1,048,576 token |
博客写的 224B、64B、12B 和 README 逐项相加的 220B、63.5B、11.7B 对不上,官方没有说明原因。
Hy4 flash 已经在腾讯云 TokenHub、WorkBuddy、元宝、企业微信、QQ、ima 和 Marvis 上线,OpenRouter 也会接入。
| 模型(元 / 百万 token) | 输入(缓存命中) | 输入 | 输出 |
|---|---|---|---|
| Hy4 flash | 0.02 | 0.5 | 2 |
| Hy4 | 0.3 | 6 | 18 |
| DeepSeek-V4.1-Flash(高峰时段) | 0.04 | 2 | 8 |
| DeepSeek-V4.1-Flash(空闲时段) | 0.02 | 1 | 4 |
| GLM-5.3-Flash | 0.23 | 0.8 | 2.8 |
和 Hy4 比,Hy4 flash 的输入单价是 1/12,输出是 1/9,缓存命中是 1/15。11 月 30 日前,腾讯云 TokenHub 的 API 打 5 折,WorkBuddy 里限时免费。
腾讯拿来对比的 DeepSeek-V4.1-Flash,用的是高峰时段价(北京时间工作日 9–12 点、14–18 点)。按 DeepSeek 定价页,其余时段只收一半,缓存命中也是 0.02 元,和 Hy4 flash 一样;输入、输出仍是 Hy4 flash 的 2 倍。GLM-5.3-Flash 的价格出自智谱定价页。
我们按 CodingPass 上的实际流量结构算了一笔账:一次 Agent 请求约 10 万 token,其中输入约 5%、输出约 1%、缓存读取约 94%。
单次费用 = 5K × 输入价 + 94K × 缓存命中价 + 1K × 输出价Hy4 flash = 0.0025 + 0.00188 + 0.002 = 0.00638 元| 模型 | 单次请求(元) | 每月 1 万次(元) | 每月 10 万次(元) | 每月 100 万次(元) |
|---|---|---|---|---|
| Hy4 flash | 0.0064 | 64 | 638 | 6,380 |
| DeepSeek-V4.1-Flash(空闲) | 0.0109 | 109 | 1,088 | 10,880 |
| DeepSeek-V4.1-Flash(高峰) | 0.0218 | 218 | 2,176 | 21,760 |
| GLM-5.3-Flash | 0.0284 | 284 | 2,842 | 28,420 |
| Hy4 | 0.0762 | 762 | 7,620 | 76,200 |
缓存读取占了九成以上的 token,账单拉开差距主要靠缓存单价。GLM-5.3-Flash 的输入、输出都不贵,但缓存命中 0.23 元,是 Hy4 flash 的 11.5 倍,在这张表里比 DeepSeek 高峰价还贵。
表里假设每家用掉的 token 一样多。官方说 Hy4 flash 的端到端输出长度降了 50%,输出少、轮数少的话,差距还会拉大;反过来,一次做不对要返工,就得按“单次成本 ÷ 首轮成功率”折算。
混元公布了两组评测。一组是自建的 WorkIndex,题目取自 WorkBuddy 上的典型任务,配合人工评估,看交付物质量、单轮输出长度和端到端用时,包含 8 个内部评测集:PPT 制作、PPT 修改、PPT 人机双写、Markdown 人机双写、文档编辑、表格修复、音视频处理、视觉理解。另一组是 7 个公开 Agent 评测:DeepSWE、ProgramBench、Terminal-Bench 4.0、APEX-Agents、AutomationBench、HLE、OSWorld 2.1。两张图的横轴都是单任务成本(人民币,对数坐标)。先看 WorkIndex,Hy4 flash 在最左边,分数比 DeepSeek-V4.1-Flash 低 2 分左右:
换成 7 个公开 Agent 评测,差距拉开了:
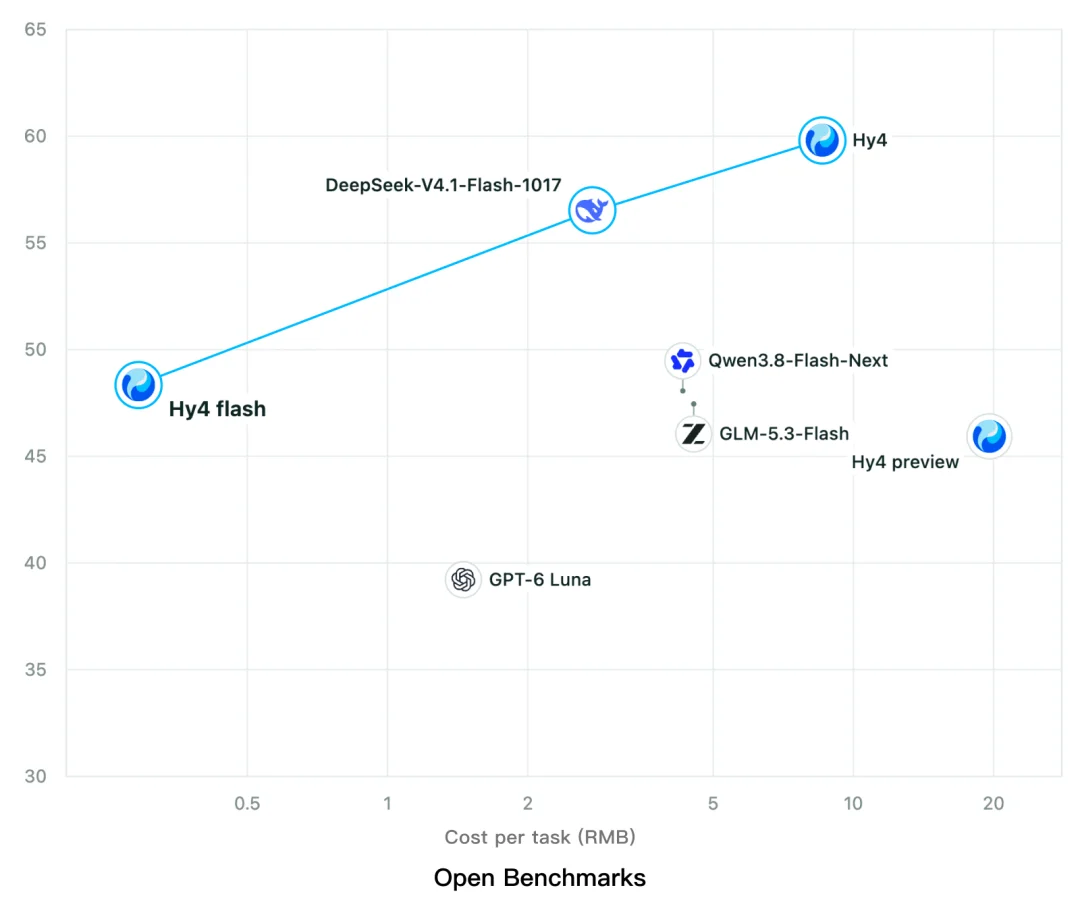
这张图上,Hy4 flash 和 Qwen3.8-Flash-Next、GLM-5.3-Flash 分数差不多,比 DeepSeek-V4.1-Flash 低 8 分左右,单任务成本低一个数量级。
官方的结论落在 WorkIndex 上:Hy4 flash 综合效果略优于 Hy4 preview,单任务成本是 Hy4 preview 的 1/13、Hy4 的 1/20、DeepSeek-V4.1-Flash-1017(max 档、高峰价)的 1/8。
附录给了每一项的分数和单任务成本:
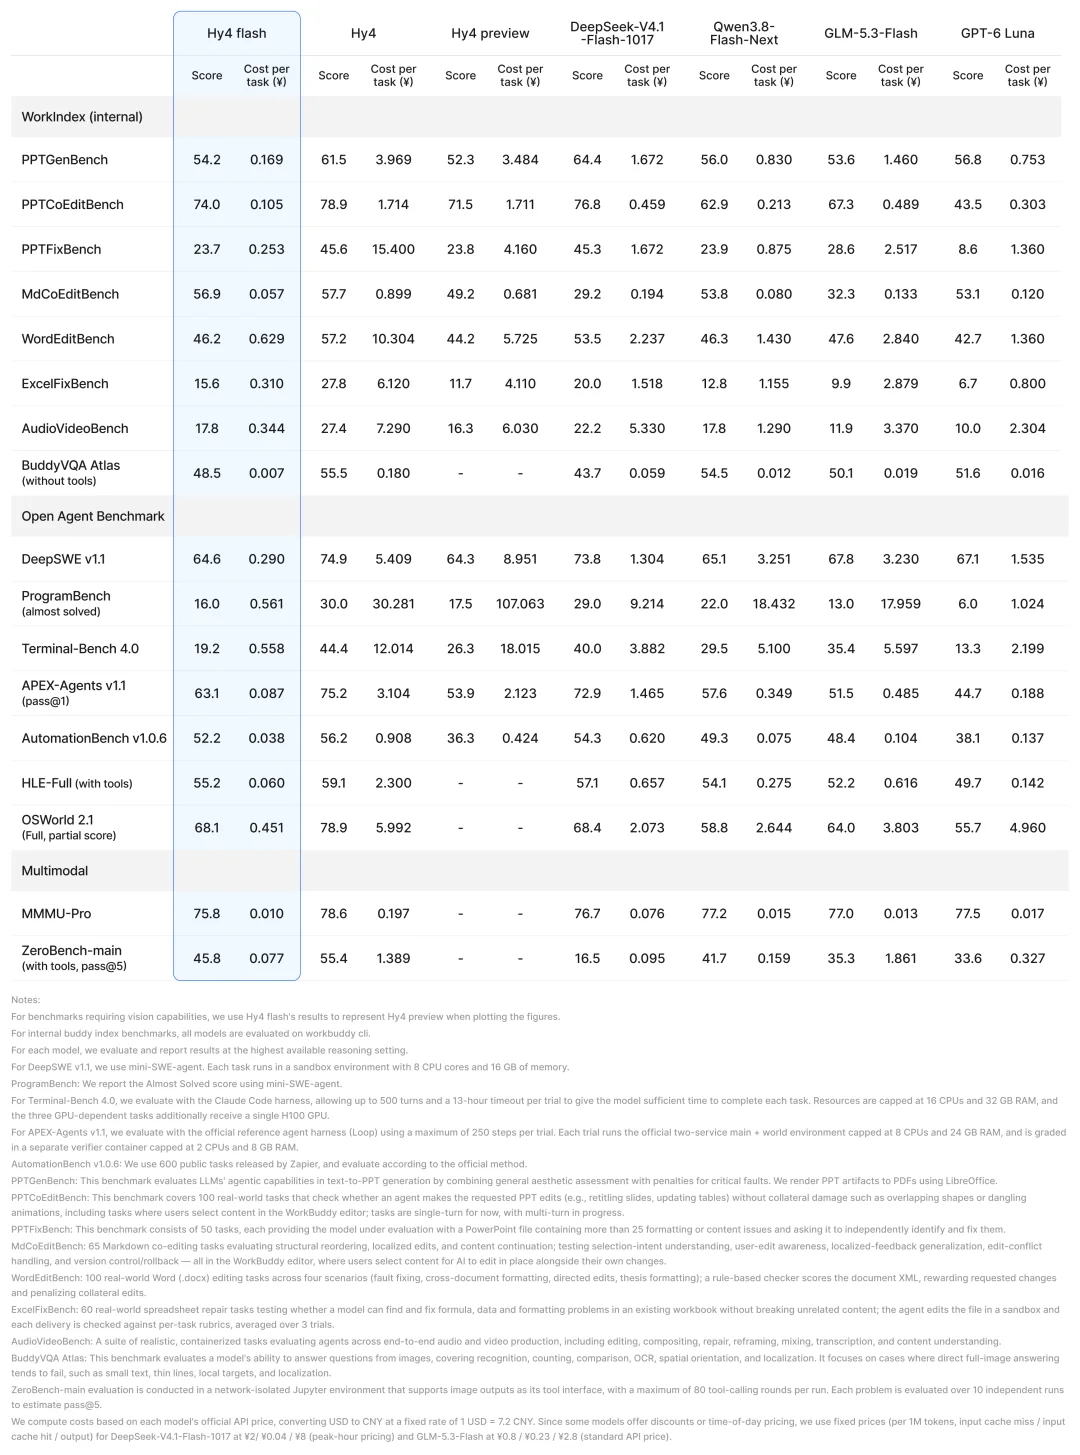
按原表拆成三张,括号里是单任务成本(元),加粗的是五个 Flash 档模型(Hy4 flash、DeepSeek-V4.1-Flash、Qwen3.8-Flash-Next、GLM-5.3-Flash、GPT-6 Luna)里的最高分:
| WorkIndex(腾讯内部,8 项) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| PPTGenBench | 54.2(0.169) | 61.5(3.969) | 52.3(3.484) | 64.4(1.672) | 56.0(0.830) | 53.6(1.460) | 56.8(0.753) |
| PPTCoEditBench | 74.0(0.105) | 78.9(1.714) | 71.5(1.711) | 76.8(0.459) | 62.9(0.213) | 67.3(0.489) | 43.5(0.303) |
| PPTFixBench | 23.7(0.253) | 45.6(15.400) | 23.8(4.160) | 45.3(1.672) | 23.9(0.875) | 28.6(2.517) | 8.6(1.360) |
| MdCoEditBench | 56.9(0.057) | 57.7(0.899) | 49.2(0.681) | 29.2(0.194) | 53.8(0.080) | 32.3(0.133) | 53.1(0.120) |
| WordEditBench | 46.2(0.629) | 57.2(10.304) | 44.2(5.725) | 53.5(2.237) | 46.3(1.430) | 47.6(2.840) | 42.7(1.360) |
| ExcelFixBench | 15.6(0.310) | 27.8(6.120) | 11.7(4.110) | 20.0(1.518) | 12.8(1.155) | 9.9(2.879) | 6.7(0.800) |
| AudioVideoBench | 17.8(0.344) | 27.4(7.290) | 16.3(6.030) | 22.2(5.330) | 17.8(1.290) | 11.9(3.370) | 10.0(2.304) |
| BuddyVQA Atlas(不带工具) | 48.5(0.007) | 55.5(0.180) | — | 43.7(0.059) | 54.5(0.012) | 50.1(0.019) | 51.6(0.016) |
| 公开 Agent 评测(7 项) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 64.6(0.290) | 74.9(5.409) | 64.3(8.951) | 73.8(1.304) | 65.1(3.251) | 67.8(3.230) | 67.1(1.535) |
| ProgramBench(almost solved) | 16.0(0.561) | 30.0(30.281) | 17.5(107.063) | 29.0(9.214) | 22.0(18.432) | 13.0(17.959) | 6.0(1.024) |
| Terminal-Bench 4.0 | 19.2(0.558) | 44.4(12.014) | 26.3(18.015) | 40.0(3.882) | 29.5(5.100) | 35.4(5.597) | 13.3(2.199) |
| APEX-Agents v1.1(pass@1) | 63.1(0.087) | 75.2(3.104) | 53.9(2.123) | 72.9(1.465) | 57.6(0.349) | 51.5(0.485) | 44.7(0.188) |
| AutomationBench v1.0.6 | 52.2(0.038) | 56.2(0.908) | 36.3(0.424) | 54.3(0.620) | 49.3(0.075) | 48.4(0.104) | 38.1(0.137) |
| HLE-Full(带工具) | 55.2(0.060) | 59.1(2.300) | — | 57.1(0.657) | 54.1(0.275) | 52.2(0.616) | 49.7(0.142) |
| OSWorld 2.1(Full,partial score) | 68.1(0.451) | 78.9(5.992) | — | 68.4(2.073) | 58.8(2.644) | 64.0(3.803) | 55.7(4.960) |
| 多模态(2 项) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| MMMU-Pro | 75.8(0.010) | 78.6(0.197) | — | 76.7(0.076) | 77.2(0.015) | 77.0(0.013) | 77.5(0.017) |
| ZeroBench-main(带工具,pass@5) | 45.8(0.077) | 55.4(1.389) | — | 16.5(0.095) | 41.7(0.159) | 35.3(1.861) | 33.6(0.327) |
这 17 项有两个很一致的结果:
附录脚注交代了评测条件:每个模型都开到最高可用的推理档;内部评测全部在 WorkBuddy CLI 里跑;DeepSWE 和 ProgramBench 用 mini-SWE-agent;Terminal-Bench 4.0 用 Claude Code 当 harness,最多 500 轮、单次 13 小时;成本按各家官方 API 价算,美元按 1:7.2 换成人民币。
混元请了 85 位 WorkBuddy 内部用户,在 27 类共 259 个日常工作任务上盲测。外部模型(DeepSeek、Claude Haiku、GLM)都用 high 档。
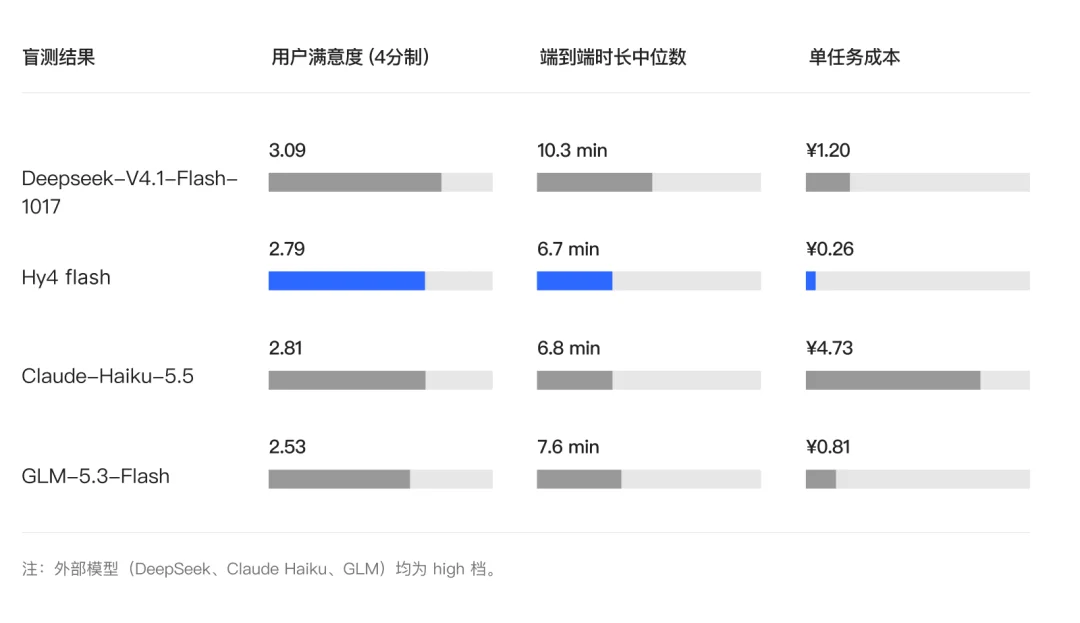
| 模型 | 用户满意度(4 分制) | 端到端时长中位数 | 单任务成本 |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 3.09 | 10.3 分钟 | 1.20 元 |
| Hy4 flash | 2.79 | 6.7 分钟 | 0.26 元 |
| Claude Haiku 5.5 | 2.81 | 6.8 分钟 | 4.73 元 |
| GLM-5.3-Flash | 2.53 | 7.6 分钟 | 0.81 元 |
混元只提了满意度接近 Claude Haiku 5.5(2.79 对 2.81),没写出来的是 DeepSeek-V4.1-Flash 拿了最高的 3.09 分,比 Hy4 flash 高 0.3。它的代价是时长中位数 10.3 分钟、单任务 1.20 元,分别是 Hy4 flash 的 1.5 倍和 4.6 倍。Claude Haiku 5.5 分数和 Hy4 flash 差不多,单任务成本是它的 18 倍。
WorkBuddy 团队的评测里有一句:和 Hy4 比,Hy4 flash 平均任务耗时减少 70%,成本约 1/15,日常工作任务效果基本持平,“Coding 长程任务小幅下降”。把附录里的编程评测单拎出来看:
| 评测 | Hy4 flash | Hy4 | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 19.2(0.558) | 44.4(12.014) | 40.0(3.882) | 29.5(5.100) |
| ProgramBench | 16.0(0.561) | 30.0(30.281) | 29.0(9.214) | 22.0(18.432) |
| DeepSWE v1.1 | 64.6(0.290) | 74.9(5.409) | 73.8(1.304) | 65.1(3.251) |
Terminal-Bench 4.0 从 44.4 掉到 19.2,不到 Hy4 的一半;ProgramBench 也只剩一半多一点。在五个 Flash 档模型里,Hy4 flash 的 DeepSWE 最低,Terminal-Bench 4.0 只比 GPT-6 Luna 高。和附录放在一起看,“小幅下降”说轻了。
这组数字和 Claude Code 用户的关系最直接:Terminal-Bench 4.0 正是用 Claude Code 当 harness 跑的。
社区的第一反应也在这里。r/LocalLLaMA 上有人看完模型卡就说,编程上 Qwen Flash Next 看起来更好;紧跟着有人回,也要看单任务成本,Hy4 flash 也许能更快做完,多审几遍。看附录,两边都有道理:Terminal-Bench 4.0 上 Qwen3.8-Flash-Next 29.5 分,Hy4 flash 19.2 分,但前者单任务 5.10 元,后者 0.56 元。
官方的推荐写得很清楚:深度搜索、文档处理、PPT 生成、简单前端展示和 computer use 用 Hy4 flash,长程软件工程这类复杂任务用智能上限更高的 Hy4。我们觉得,在 Claude Code、OpenCode 里拿它当主力写代码不合适;读日志、整理文档、生成简单页面这类量大、单个不难的活,可以交给它。
混元还放出了 8 个腾讯产品团队的评测:
| 产品(评测人) | 场景 | 对照 | 评测结果 |
|---|---|---|---|
| WorkBuddy(产品经理 Anne) | 日常办公任务 | Hy4 | 平均任务耗时减少 70%,平均成本约为 Hy4 的 1/15;日常任务效果基本持平,长程 Coding 小幅下降;原生多模态 |
| 元宝(产品负责人 Logan) | Agent 任务、通用对话 | Hy3、GLM-5.3-Flash | Agent 能力比 Hy3 提升 13.6%,人工对比评估 GSB 提升 7.56%;通用对话比 GLM-5.3-Flash 提升 2.52%,多轮对话提升最明显 |
| 微信支付(信息智能实验室 yilin、安全工程师 Simba) | AI 操作真机测试支付客户端;代码静态扫描 | DeepSeek-V4.1-Flash-1017 | 执行路径、知识利用、验收检查、造号准确性四个流程均分持平或更高,执行步数减少约 6%,单次输出缩短约 29%;静态扫描耗时降 37%、token 降 46%,效果持平 |
| 企业微信(算法负责人 Dylan) | 企业信息检索、资料分析、文档整理 | Hy4 | 输出速度提升 88%,思考模式下输出 token 减少约 60%;能自主规划工具调用并交付结果 |
| 王者荣耀(项目管理负责人 TH) | 游戏研发 Bug 根因定位(UI 交互、系统逻辑) | DeepSeek-V4.1-Flash-1017、GLM-5.3-Flash | 定位效果接近两者;模型请求次数减少 22.0%–39.1%,按请求回执统计的 token 减少 40.5%–61.2%;工具调用次数反而分别多 51.2% 和 7.7%,报告篇幅短 13.8% 和 37.0% |
| ima(产品经理 Kaycee) | 知识库问答 | DeepSeek-V4.1-Flash-1017、GLM-5.3-Flash | 平均等待时间缩短约 18%–35%;回答整体评分提升 1.8%,内容质量提升 8.1%,思维链质量提升 2.1% |
| QQ(小 Q 技术负责人 Red、频道研发 Look) | 小 Q 的 Agent 能力;频道助手的 UGC 互动 | DeepSeek-V4.1-Flash | 音乐推荐、频道互动、QQ 空间、星座长篇解析的达标率分别高 6.16、2.84、0.92、2.22 个百分点;聊天陪伴、音乐推荐、星座解析完成时间缩短约 11%–27%;频道助手意图判断准确率持平,评论 P90 耗时缩短 39%、峰值耗时缩短 47%,输出 token 减少 30%,缓存命中率大幅提升 |
| Marvis(算法工程师 Baihan) | AI 管家 | DeepSeek-V4.1-Flash-1017 | 整体满意度持平;应用下载安装提升 6.2%,系统设置与诊断提升 4.4%,文档处理与调研报告生成提升 6.9% |
8 个案例都来自腾讯自家产品,对照组大多是 DeepSeek-V4.1-Flash,目前没有外部复现。王者荣耀那条可以细看:请求次数和 token 都少了,对 DeepSeek 的工具调用次数却多了一半,省下来的是 token,调用并没有少。
跑分和案例都出自腾讯自己,看这组数字时有几个前提要留意:
这次开放了三个权重:Hy4 flash、Hy4 flash-FP8,以及预训练底座 Hy4 flash-base(不是对话模型)。权重放在 Hugging Face、ModelScope 和 AtomGit(GitCode)上,GitHub 仓库里有推理和微调代码。Hy4 本身还没开源,官方说“即将开源”。
官方推荐用 vLLM 或 SGLang 部署,FP8 权重用 8 卡张量并行。vLLM 有现成的镜像:
docker run --gpus all -p 8000:8000 --ipc=host \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \ --tensor-parallel-size 8 \ --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \ --attention-backend FLASHMLA_SPARSE \ --tool-call-parser hy_v4 \ --reasoning-parser hy_v4 \ --enable-auto-tool-choice \ --served-model-name hy4-flash启动后是 OpenAI 兼容接口。思考档位通过 chat_template_kwargs 传,no_think 表示关闭思考:
from openai import OpenAI client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")resp = client.chat.completions.create( model="hy4-flash", messages=[{"role": "user", "content": "用三句话总结这份周报"}], extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}},)print(resp.choices[0].message.content)腾讯的 AngelSlim 团队还放了 GGUF 版本,README 写明只供端到端测试,生产部署仍建议 vLLM 或 SGLang。
150 tps 是腾讯自家部署的速度,别的渠道还没有公开数字。Hacker News 的发布讨论里,有用户说喜欢这个模型,但“有点慢”,没说用的哪个渠道;另一位用户认为性价比还是 DeepSeek 4.1 Flash 最好,它在 OpenRouter 上常见 200–400 tps,他希望 Hy4 flash 体积小,第三方能跑得更快。
许可证是 Tencent Hy License 1.0,改自 Apache 2.0,多了一节 MaaS 商用条款:以模型即服务为业务的公司,全球年收入超过 5,000 万美元,或者产品月活超过 1 亿,要先找腾讯单独签授权。只在内部使用、模型和输出都不提供给第三方的,不受这条限制。
| 工作负载 | 推荐 | 理由或代价 |
|---|---|---|
| 文档、PPT、表格整理,深度搜索 | Hy4 flash | WorkIndex 单任务约 0.2 元;同档里 DeepSeek-V4.1-Flash 在 PPT 和文档编辑上分更高,单任务贵 4–10 倍 |
| 大批量问答、对话,看重响应快 | Hy4 flash | 盲测时长中位数 6.7 分钟,四个模型里最短;ima 知识库问答等待时间短 18%–35% |
| 在 Claude Code、OpenCode 里写代码、跑终端任务 | Hy4 或 DeepSeek-V4.1-Flash | Terminal-Bench 4.0:Hy4 flash 19.2,Hy4 44.4,DeepSeek-V4.1-Flash 40.0 |
| 更看重交付质量,不赶时间 | DeepSeek-V4.1-Flash | 盲测满意度 3.09 最高;时长 10.3 分钟、单任务 1.20 元;空闲时段半价 |
| 带工具的看图推理 | Hy4 flash | ZeroBench 45.8,同档最高;MMMU-Pro 75.8,同档最低 |
| 自己部署、对外提供服务 | 先看许可证和硬件 | FP8 要 8 卡张量并行;大型 MaaS 业务要单独签授权 |
CodingPass 目前有 Hy4(模型 ID hy4),Go、Plus、Pro 都能用,额度按官方 API 价计量;Hy4 flash 暂时没有上架。按官方的建议,长程写代码本来就该用 Hy4。如果只打算用 Hy4 flash 跑大批量的日常任务,直接用腾讯云 TokenHub 更省,11 月 30 日前还有 5 折,没必要为它订套餐。各模型的额度见模型页。