Все модели
ID каждой модели, минимальный тариф и месячная квота в Go, Plus и Pro.
Alibaba представила проприетарный флагман Qwen4-Max: 2.4T параметров при 71B активных на токен, первое место в 4 из 16 официальных тестов и попадание в кэш от ¥0.5 за миллион токенов в материковом Китае. Разбираем официальные и независимые бенчмарки, китайские и международные цены API, счета за два реальных прогона, уровни рассуждений и подходящие задачи.
16 ноября Alibaba выпустила новую флагманскую модель Qwen4-Max. Она построена на разреженной архитектуре Mixture-of-Experts (sparse MoE) поколения Qwen4: 2.4T базовых параметров, 71B активных на каждый токен и ещё 328B параметров в слое N-gram Embedding. Модель поддерживает контекстное окно в 1 млн токенов и нативный визуальный ввод, а работает только через облачный API и официальные приложения.
За неделю до релиза ранняя сборка появилась в IDE для программирования Qoder под анонимным именем, после чего обновилась до Qwen4-Max-Preview. 16 ноября команда Qwen опубликовала полные результаты бенчмарков, описание архитектуры и прайс-лист API. Ниже собраны официальные замеры, независимые рейтинги, тарифы и реальные счета от разработчиков.
Главное: сильные стороны Qwen4-Max — длительные агентные задачи, исправление кода на уровне репозитория (DeepSWE 75.7) и дешёвое попадание в кэш (¥0.5 за 1 млн токенов в материковом Китае и $0.075 на международном QwenCloud; средняя стоимость задачи в Work360 снизилась на 62% по сравнению с прошлым поколением). Слабые места — работа в терминале (Terminal-Bench 4.0 — 48.5), воссоздание ПО по принципу «чёрного ящика» (ProgramBench — 31.5) и низкая скорость на высоких уровнях рассуждений (в среднем 32.1 минуты на задачу в Artificial Analysis). Модель подходит для многошаговых инженерных и документных задач с длинным контекстом; в повседневной работе достаточно уровня по умолчанию high, а для сложного фулстека и терминальных агентов стоит переключаться на xhigh.
В разреженную MoE-архитектуру Qwen4-Max внесли три изменения, чтобы снизить вычислительные затраты на длинных последовательностях и сократить число активируемых на каждом шаге параметров:
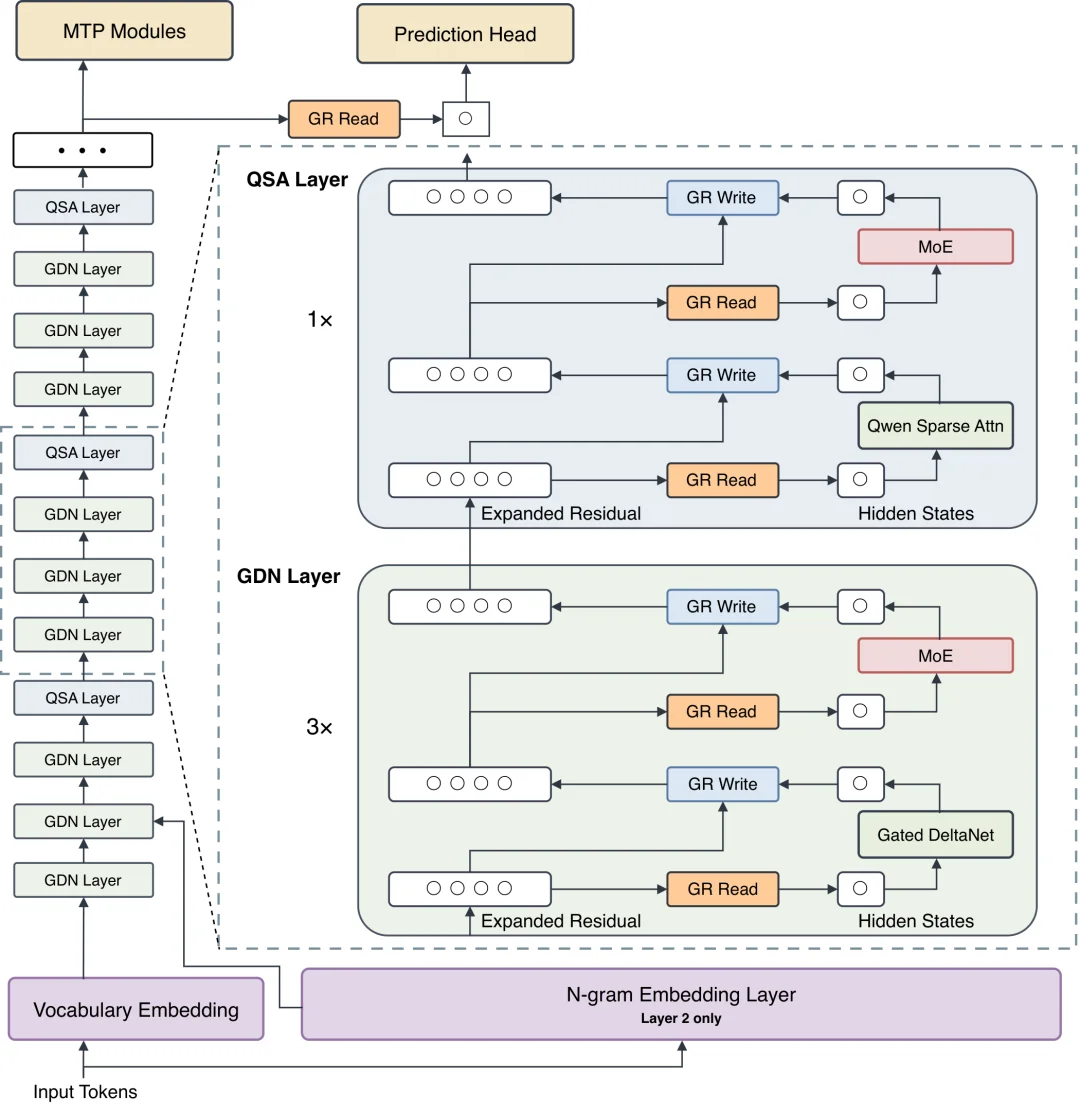
За счёт этой схемы Qwen4-Max активирует 71B параметров на токен — примерно на 25% меньше, чем у предыдущей Qwen3.8-Max (95B), а предобучение на масштабе 2.4T прошло без единого скачка функции потерь (no loss spikes throughout the run). Во внутренних тестах базовой модели по четырём направлениям — знания (Knowledge), код (Code), вопросы и ответы (QA) и STEM — чекпоинт Qwen4-Max-Base показал самый низкий показатель бит на байт (BPB, чем ниже, тем лучше) среди всех 5 участников сравнения, снизив его на 5%–13% относительно Qwen3.8-Max-Base. В официальной сноске при этом уточняется, что участвовавшие в сравнении GLM-5.3 и Kimi-K3.1-Pro представляют собой чекпоинты после постобучения (post-trained checkpoints), что может влиять на прямое сопоставление с базовыми моделями.
Хронология недели перед релизом: 6 ноября официальный аккаунт Qwen в X опубликовал тизер «The becoming begins.»; 7 ноября в IDE Qoder появилась бесплатная для индивидуальных пользователей анонимная модель Qoduck, которая за 4 дня анонимного теста обновлялась ежедневно; 11 ноября Qoder раскрыла модель и обновила её до Qwen4-Max-Preview (пост набрал более 5.4 млн просмотров); 16 ноября вышла финальная версия.
Сейчас Qwen4-Max (ID модели qwen4-max) доступна по API с оплатой за токены в материковом Китае через Alibaba Cloud Model Studio и на международной платформе QwenCloud, а также входит в подписку Token Plan в сингапурском регионе. В пользовательских продуктах модель можно выбрать в QwenWork, Qoder, приложении Qwen и Qwen Studio.
Веса самой Qwen4-Max закрыты. В конце официального анонса команда лишь упомянула, что «модели малого и среднего размера из серии Qwen4 будут последовательно выходить с открытыми весами», не назвав ни точного числа параметров, ни сроков. В комментариях под постом с анонсом пользователи массово флешмобят фразой «Qwen-4 27B > GTA VI», требуя скорейшего релиза компактных версий.
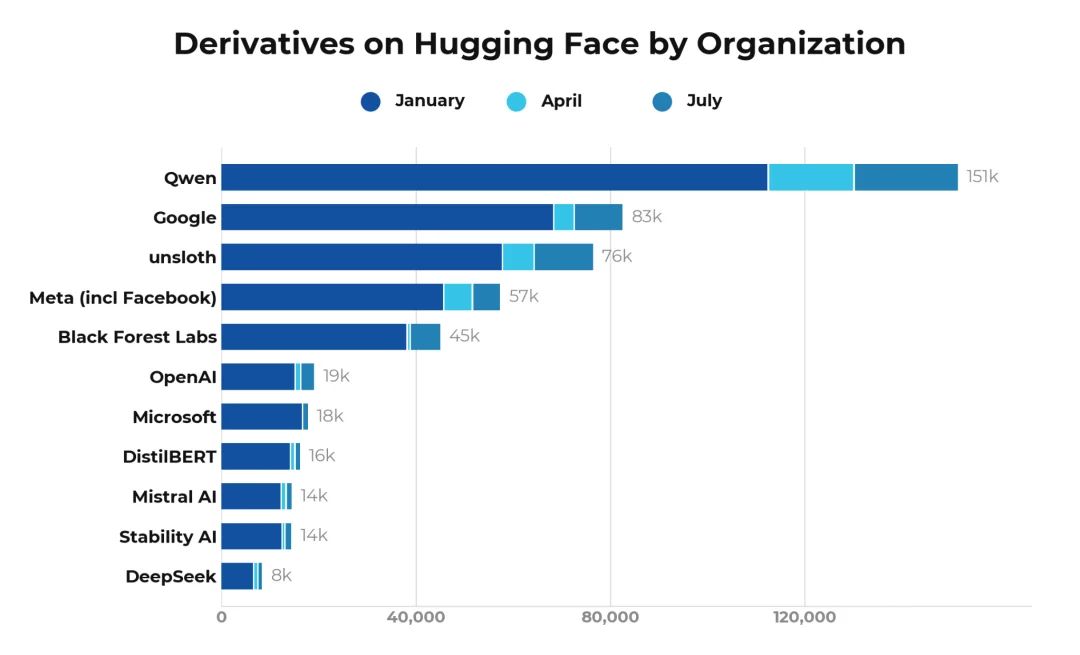
Такой интерес к младшим версиям понятен: модели Qwen с открытыми весами остаются самой популярной базой для локального и серверного развёртывания. Согласно летнему отчёту об открытых моделях за 2026 год от Hugging Face, с января по август 2026 года модели Qwen скачали на Hugging Face 2.045 млрд раз (по данным самой Alibaba, суммарное число загрузок на всех площадках превысило 3 млрд). На базе Qwen создано 151,448 производных моделей — в 2.6 раза больше, чем у Meta, и больше, чем у Google (82,506) и Meta вместе взятых.
В корпоративном секторе линейку тоже активно используют. В октябре 2025 года глава Airbnb Брайан Чески в интервью отметил, что ИИ-поддержка Airbnb во многом опирается на модели Qwen: «Она очень хороша. А ещё быстрая и дешёвая».
При этом проприетарный флагман не во всех сценариях обыгрывает собственные открытые модели меньшего размера. Пользователь Hacker News под ником chriddyp проверил Qwen4-Max на внутреннем командном бенчмарке коротких задач анализа данных: флагман набрал на несколько баллов меньше, чем вышедшая в августе с открытыми весами и работающая на настольном железе Qwen3.8 27B, а один прогон обошёлся немного дороже.
Команда Qwen опубликовала результаты 16 бенчмарков по программированию, офисным задачам, научным исследованиям и мультимодальности, сопоставив Qwen4-Max с Qwen3.8-Max-0902, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra и Kimi K3.1.
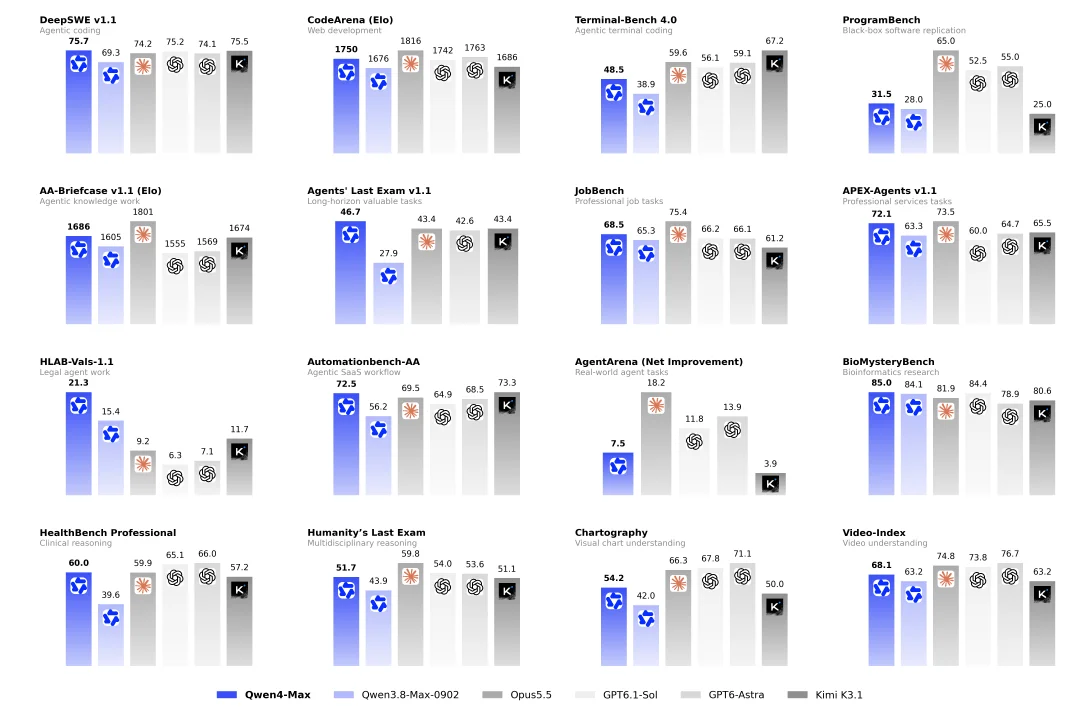
Полные цифры по всем 16 тестам с графика (полужирным выделен лучший результат в строке):
| Бенчмарк | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 (GPT, один столбец на графике) | — | 43.4 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | 11.8 | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Разработчики свели на одну иллюстрацию и победные дисциплины, и те, где модель заметно отстаёт:
В слепом рейтинге фронтенд-разработки CodeArena: WebDev (срез от 2026-11-14: 159 моделей и более 1 млн голосов) Qwen4-Max (xHigh) занимает 6-е место в мире с рейтингом 1,750 Elo — лучший показатель среди китайских моделей (следующая модель из Китая — Kimi K3.1 Pro на 13-й строчке с 1,686 баллами). Она уступает GPT-6 Astra (1,763), но обходит Claude Fable 5.1 (1,743), GPT-6.1 Sol (1,742) и Claude Sonnet 5.5 на уровне High (10-е место, 1,716). При этом стоит учитывать два момента: во-первых, Sonnet 5.5 на уровне xHigh набирает 1,772 балла и занимает 3-е место; во-вторых, у Qwen4-Max пока всего 1,814 голосов, статус оценки помечен как Preliminary (предварительная) с доверительным интервалом ±15, что соответствует разбросу мест (Rank Spread) с 3-го по 9-е.
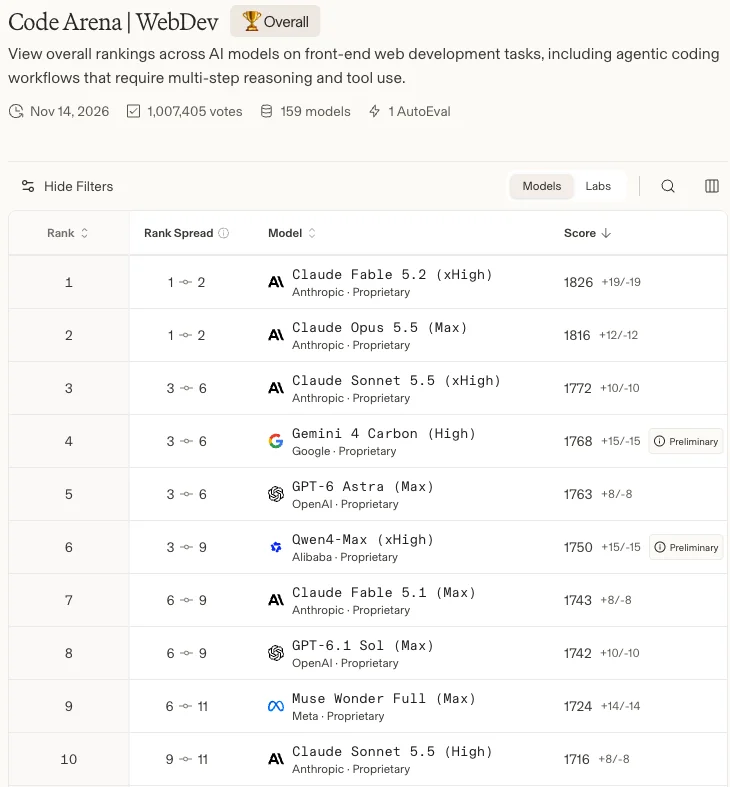
| Место | Модель | Рейтинг Elo | Примечание |
|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 ±19 | — |
| 2 | Claude Opus 5.5 (Max) | 1816 ±12 | — |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 ±10 | — |
| 4 | Gemini 4 Carbon (High) | 1768 ±15 | Preliminary |
| 5 | GPT-6 Astra (Max) | 1763 ±8 | — |
| 6 | Qwen4-Max (xHigh) | 1750 ±15 | Preliminary; интервал мест 3–9; 1,814 голосов; P50 за задачу $4.18 |
| 7 | Claude Fable 5.1 (Max) | 1743 ±8 | — |
| 8 | GPT-6.1 Sol (Max) | 1742 ±10 | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 ±8 | — |
| 13 | Kimi K3.1 Pro (Max) | 1686 ±9 | Следующая китайская модель |
| 16 | Qwen3.8-Max (0902) | 1676 ±6 | Предыдущее поколение |
| 19 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 ±7 | Модель для сравнения расхода токенов ниже |
По данным независимого агентства Artificial Analysis (срез от 2026-11-17), в сводном индексе Intelligence Index v5.0.1 из 9 тестов Qwen4-Max набирает 43 балла и занимает 38-е место из 81 модели (при медиане по классу 41 балл). Для сравнения: GPT-6.1 Sol (max) получает 55 баллов при средней стоимости задачи всего $1.27 — на 12 баллов выше и на 61% дешевле Qwen4-Max ($3.27 за задачу); у Kimi K3.1 Pro — 46 баллов и $3.68 за задачу.
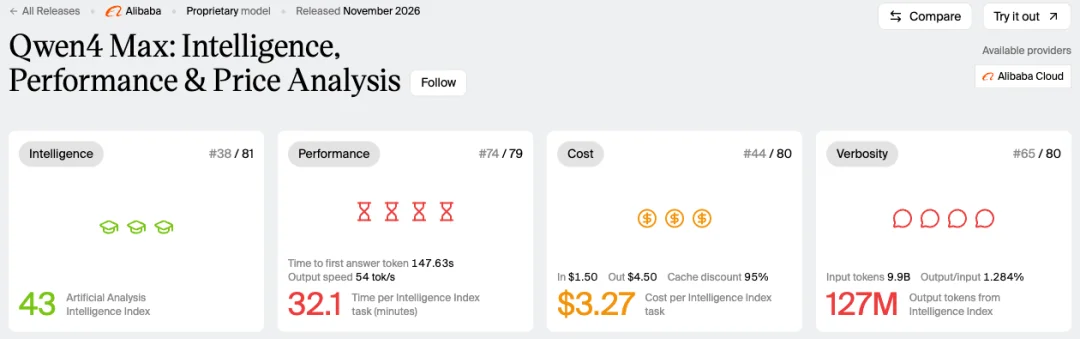
| Модель | Intelligence Index | Время на задачу (мин) | Стоимость задачи |
|---|---|---|---|
| Claude Fable 5.2 (max) | 65 | 40.8 | $26.54 |
| Gemini 4 Carbon (high) | 60 | 31.1 | $5.48 |
| Claude Opus 5.5 (max) | 59 | 24.6 | $10.04 |
| GPT-6 Astra (max) | 57 | 20.4 | $6.24 |
| GPT-6.1 Sol (max) | 55 | 23.0 | $1.27 |
| Kimi K3.1 Pro | 46 | 38.8 | $3.68 |
| Qwen4-Max | 43 | 32.1 | $3.27 |
| Grok 4.7 (xhigh) | 35 | 24.6 | $7.77 |
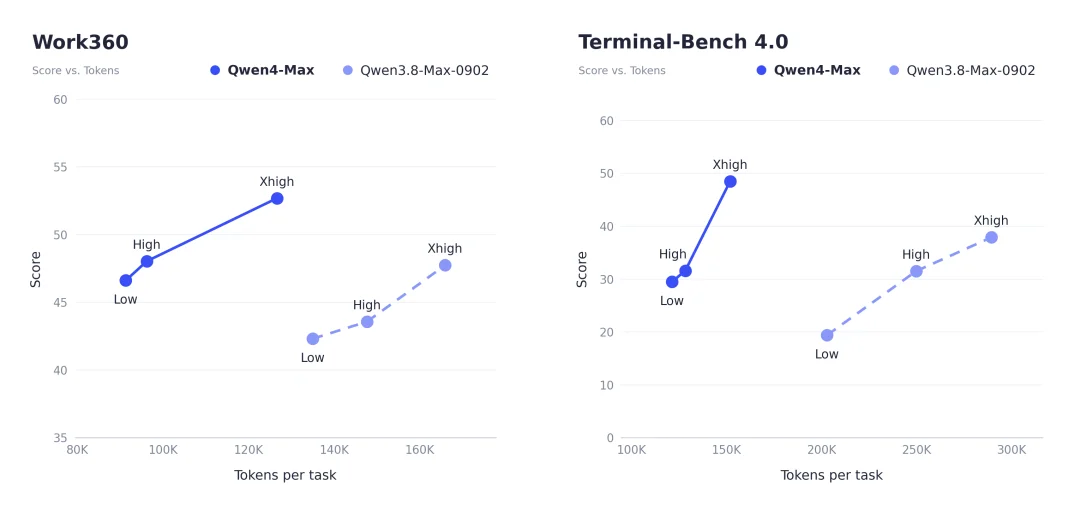
По официальным данным в сравнении с прошлой Qwen3.8-Max, на бенчмарке Work360 расход токенов на задачу у Qwen4-Max сократился примерно на 24% на уровне xhigh и на 35% на high. В Terminal-Bench 4.0 среднее потребление на xhigh снизилось примерно с 289K до 151K токенов (минус 48%) при росте балла с 38.9 до 48.5, а на high расход упал примерно на 49%.
Во время тестирования preview-сборки разработчики также опубликовали два независимых сравнения на одинаковых промптах:
Qwen4-Max-Preview и DeepSeek-v4.1-flash-1017: в 87 задачах из 103 модель Qwen израсходовала меньше токенов — в среднем около 77K на задачу против 115K у DeepSeek (экономия около 33%).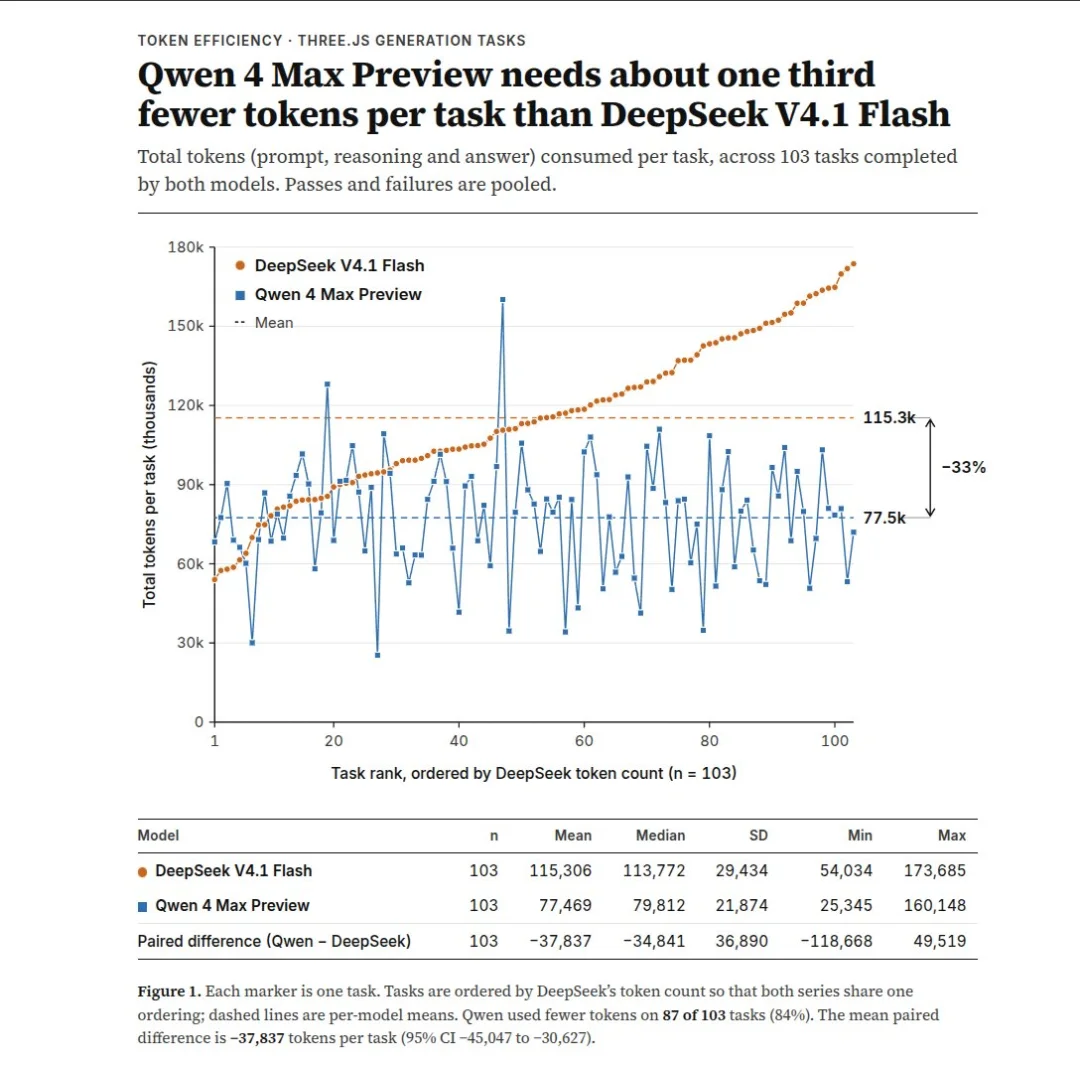
В обоих пользовательских тестах участвовала preview-версия, а соперником выступала DeepSeek V4.1 Flash. Хотя Qwen тратит на треть или вдвое меньше токенов, API-тариф у DeepSeek V4.1 Flash составляет всего $0.15 / $0.60 за миллион входных и выходных токенов — вдесятеро дешевле Qwen4-Max ($1.50 / $4.50) на входе и примерно в семь раз дешевле на выходе. Сам @ItsmeAjayKV в исходном посте отметил: «Если учитывать цену и размер модели, deepseek-v4.1-flash здесь явно выигрывает».
При этом в сквозном тестировании Artificial Analysis за полный прогон Intelligence Index Qwen4-Max сгенерировала 127M выходных токенов при медиане по сопоставимым моделям 78.6M, получив пометку «very verbose». Среднее время на задачу составило 32.1 минуты (медиана — 13.3 минуты), ожидание первого токена ответа (time to first answer token) достигло 147.63 секунды при скорости вывода 54 tok/s.
| Сценарий тестирования | База сравнения | Qwen4-Max | База сравнения (данные) | Комментарий |
|---|---|---|---|---|
| Work360 (xHigh / High) | Qwen3.8-Max-0902 | ≈127K / ≈96K | ≈166K / ≈148K | Меньше прошлого поколения примерно на 24% / 35% |
| Terminal-Bench 4.0 (xHigh / High) | Qwen3.8-Max-0902 | ≈151K / ≈129K | ≈289K / ≈250K | Меньше прошлого поколения примерно на 48% / 49% |
| 103 задачи Three.js (preview) | DeepSeek V4.1 Flash | 77.5K / задача | 115.3K / задача | На 33% меньше токенов, но токен у DeepSeek на порядок дешевле |
| Суммарный вывод и время за задачу в AA | Медиана передовых моделей | 127M / 32.1 мин | 78.6M / 13.3 мин | Пометка AA «very verbose», время примерно в 2.4 раза выше медианы |
На наш взгляд, экономия токенов у Qwen4-Max заметна именно на фоне собственной предшественницы Qwen3.8-Max и DeepSeek V4.1 Flash; в общем ряду передовых моделей на высоком уровне рассуждений она по-прежнему работает неспешно и генерирует объёмные ответы.
Согласно документации Alibaba Cloud Model Studio, параметр уровня рассуждений reasoning_effort у Qwen4-Max принимает три значения: low, high и xhigh (по умолчанию в релизной версии стоит high с максимальным бюджетом цепочки рассуждений thinking_budget=131072; значения minimal, medium и max автоматически приводятся к low, high и xhigh).
Баллы и расход токенов на задачу для трёх уровней с официального графика эффективности в Work360 и Terminal-Bench 4.0:
| Бенчмарк | Low | High (по умолчанию в релизе) | Xhigh | Разница между High и Xhigh |
|---|---|---|---|---|
| Work360 (офисные и отраслевые задачи) | ≈46.6 (≈91K) | ≈48.0 (≈96K) | 52.69 (≈127K) | На High ниже примерно на 4.7 балла, экономия около 24% токенов |
| Terminal-Bench 4.0 (работа в терминале) | ≈29.5 (≈122K) | ≈31.5 (≈129K) | 48.5 (≈151K) | На High ниже примерно на 17.0 балла, экономия лишь около 15% токенов |
На старте preview-версии уровень по умолчанию был жёстко зафиксирован на xhigh, что сильно растягивало выполнение простых запросов. Пользователь @SrinivasValekar приводил показательный пример генерации деревни на уровне xhigh у обеих моделей: Gemini 4 Hydrogen справилась за 12 минут и примерно $1.7, тогда как Qwen4-Max работала 1 час 15 минут и потратила около $0.9. Один прогон не заменяет полноценного рейтинга, но разница во времени огромная.
Автор YouTube-канала The Dark Factory протестировал qwen4-max-preview в Claude Code по подписке Token Plan на задаче создания приложения для учёта бюджета и сравнил два режима: когда уровень рассуждений в Claude Code снизили со стоявшего по умолчанию xhigh до low, время работы сократилось с 24 до 9 минут, объём чтения контекста упал с 4.4M до 1.1M токенов (минус 75%), вывод уменьшился с 83K до 31K (минус 63%), а слепая оценка от судьи Codex (GPT-6.1 Sol) выросла с 8/10 до 9/10.
| Уровень рассуждений | Выходные токены | Прочитано токенов | Время | Слепая оценка (судья GPT-6.1 Sol) |
|---|---|---|---|---|
| По умолчанию (xHigh) | 83K | 4.4M | 24 мин | 8 / 10 |
| low | 31K (-63%) | 1.1M (-75%) | 9 мин | 9 / 10 |
Эксперимент The Dark Factory — это один прогон одной фронтенд-задачи с одним ИИ-судьёй. Если сопоставить его с официальными кривыми выше, мы считаем, что установленного по умолчанию в релизе уровня high достаточно для повседневных офисных задач, типового фронтенда и ответов на вопросы. А вот на сложном фулстеке и агентных задачах в терминале (вроде сценариев Terminal-Bench) разрыв между high и xhigh достигает 17 баллов — там имеет смысл вручную переключаться на xhigh.
Минимальный пример вызова с выбором уровня рассуждений через OpenAI-совместимый Responses API на международной платформе QwenCloud:
from openai import OpenAIimport os client = OpenAI( api_key=os.getenv("DASHSCOPE_API_KEY"), base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",) resp = client.responses.create( model="qwen4-max", input="Добавь модульные тесты для этой функции", reasoning={"effort": "high"}, # low / high / xhigh, по умолчанию high)print(resp.output_text)Официальные тарифы API делятся на сетку для материкового Китая (Alibaba Cloud Model Studio, в юанях) и международную сетку (QwenCloud, Сингапур, в долларах). В материковом Китае стандартный ввод стоит ¥10 за 1 млн токенов, вывод — ¥30 за 1 млн токенов, что примерно на 16.7% ниже тарифов прошлой qwen3.8-max (¥12 / ¥36). Цена при попадании в кэш снижена до ¥0.5 за 1 млн токенов ($0.075 за 1 млн на международном QwenCloud) — всего 5% от базовой стоимости ввода. Вместе с сокращением расхода токенов это снизило среднюю стоимость задачи в официальном тесте Work360 с $4.43 у прошлого поколения до $1.67 (минус 62%).
| Позиция тарифа | Материковый Китай (Model Studio, CNY) | Международный (QwenCloud, Сингапур) |
|---|---|---|
| Стандартный ввод (0 < токенов ≤ 1M, с рассуждениями и без) | ¥10 / млн | $1.5 / млн |
| Вывод (токены рассуждений + ответ) | ¥30 / млн | $4.5 / млн |
| Попадание в кэш (явный / неявный кэш) | ¥0.5 / млн | $0.075 / млн |
| Создание явного кэша (TTL 5 минут) | ¥12.5 / млн | $1.875 / млн |
| Создание явного кэша (TTL 1 час) | ¥20 / млн | $3 / млн |
| Бесплатная квота для новых аккаунтов | 1 млн токенов (90 дней) | — |
По правилам биллинга Alibaba Cloud Model Studio кэширование работает так: неявный кэш (implicit cache) включён по умолчанию и не требует правок в коде, но попадание в кэш на каждом запросе не гарантируется; явный кэш (explicit cache) требует префикса от 1,024 токенов с временем жизни (TTL) 5 минут (по умолчанию) или 1 час и автоматически продлевается при попадании; кэш переиспользуется только между запросами одного аккаунта; выходные токены (включая токены рассуждений) всегда тарифицируются по полной ставке.
Пересчитаем по релизным ценам реальный расход токенов, который опубликовал разработчик @superalesha на задаче генерации в Blender сцены раменной в дождливом ночном Токио. Он запустил один и тот же промпт на preview-сборке в режиме xhigh через две разные обвязки (harness) — DeepSeek Harness (DSH) и Qwen Code. По формуле стоимость = ввод мимо кэша × цена ввода + попадание в кэш × цена кэша + вывод × цена вывода получаются следующие счета:
| Обвязка (один промпт, xHigh) | Весь ввод (в кэше / мимо кэша) | Вывод | Счёт в КНР (с кэшем) | КНР (при 0% кэша) | Международный (с кэшем) | Международный (при 0% кэша) |
|---|---|---|---|---|---|---|
| DeepSeek Harness | 11.96M (11.59M / 0.37M) | 130K | 3.70 + 5.80 + 3.90 = ¥13.40 | ¥123.50 | $2.01 | $18.53 |
| Qwen Code | 3.02M (2.85M / 0.17M) | 62K | 1.70 + 1.43 + 1.86 = ¥4.99 | ¥32.06 | $0.75 | $4.81 |
Из этого расчёта видны три практических вывода:
Опираясь на контекстное окно в 1 млн токенов, нативное зрение и вызов инструментов, команда Qwen и сообщество показали серию длинных многошаговых задач.
В 3D-моделировании и разработке игр @superalesha поручил модели собрать диораму раменной в дождливом ночном Токио исключительно скриптами на Python через Blender MCP без импорта готовых внешних ассетов. В промпте перечислялись тканевые занавески норэн, бумажные фонари, миска горячего рамена, торговый автомат и лужи с неоновыми отражениями, требовался рендер в Cycles и самостоятельный визуальный разбор готовых рендеров с доработкой ошибок. Команда Qwen, в свою очередь, продемонстрировала создание игр в Unity, Unreal Engine и Godot напрямую из текстового описания: модель собирала сцены, писала игровую логику, подключала внешние ассеты и по кадрам запущенной игры настраивала камеру и ощущение удара. Так были собраны 3D-приключение про кота-мага Meow of Magic на Unreal Engine, фэнтезийный экшен с полётами на мечах Yun Guan Xing и мобильная гонка под Android Flying Racer на Unity 6.
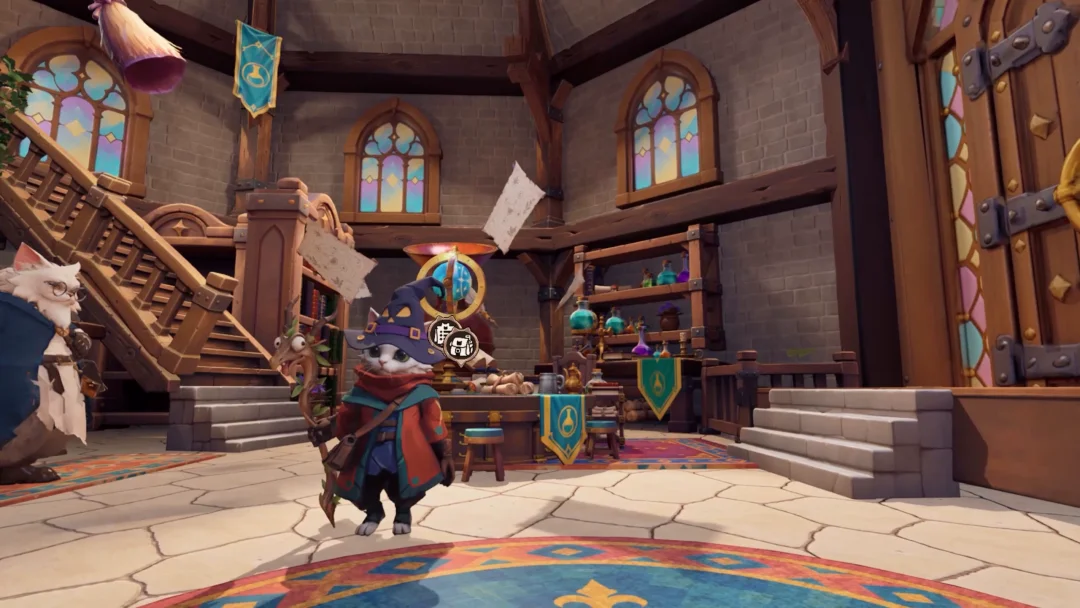
Чтобы решить типичную проблему длительных агентных сессий, когда модель уходит не в ту сторону в середине работы и переделывать финальный результат оказывается слишком поздно, в Qwen4-Max добавили механизм Live Delivery и выложили в открытый доступ сопутствующий плагин Qwen-Live-Delivery-Plugin: получив сложную задачу, агент сначала быстро выдаёт минимальную рабочую версию, а затем итеративно расширяет её по результатам выполнения и правкам пользователя, позволяя вмешаться и скорректировать курс на любом шаге.
В промышленности, финансах, юриспруденции, медицине и науке Alibaba раскрыла 6 совместных внедрений:
| Сфера | Содержание задачи | Ключевые показатели |
|---|---|---|
| Автопром (линии SANF, Pacific Union) | Построение 3D-линий по 2D-чертежам и параметрам техпроцесса с виртуальной отладкой ПЛК (PLC); проектирование дверных узлов и фрикционных колёс, генерация траекторий ЧПУ-обработки и симуляция зарезов и недорезов до запуска станка | Трудозатраты инженера на программирование одной детали снизились примерно с 475 до 24 минут (сокращение примерно на 95%) |
| Юридический due diligence перед IPO | Очистка разрозненных рабочих документов (working papers) клиента, переименование по сути содержимого, раскладка по папкам и индексация; перекрёстная сверка корпоративных реестров, ИС, судебных и кредитных баз, выявление скрытых рисков «условий восстановления» (reinstatement clauses) в соглашениях VAM | Разобрано 198 документов по 14 папкам, подготовлен отчёт на 86 страниц объёмом более 60 тыс. знаков по 12 направлениям проверки и 14 правовым вопросам со ссылками на исходники у каждого вывода |
| Финансовая аналитика (фьючерсы CSI 300) | Сбор котировок акций А-класса, Гонконга и США, облигаций, фондов и деривативов; расчёт теоретического базиса фьючерсов (theoretical futures basis) и спредов волатильности с учётом стоимости фондирования, дивидендной доходности и экспирации; выгрузка связанных таблиц Excel и редактируемых презентаций PPT | Вызов 90 инструментов MCP; двусторонняя зависимая консолидация (bilateral dependent consolidation) с переходом из ячейки Excel к первоисточнику и прямым соответствием графиков PPT листам рабочей книги (chart-to-workbook alignment) |
| Клиническая поддержка в реанимации | Анализ десятков бланков анализов, истории болезни объёмом свыше 10 тыс. знаков и врачебных назначений в одном диалоге; разбивка снимков на 6 серий и параллельный разбор сотен срезов КТ грудной клетки несколькими субагентами | Обработана история болезни более чем на 10 тыс. знаков и 1,433 снимка, выявлена дорсальная консолидация обоих лёгких (совпало с диагнозом лечащего врача), 4 рекомендации по ведению совпали с назначениями дня |
| Замкнутый цикл «сухой и мокрой» лаборатории (платформа Mira от Deep Principle) | Подбор теплоносителя для охлаждения высокомощных чипов в ЦОД: отбор структур, прогноз свойств MPA, первопринципные расчёты и ретросинтетический анализ с прямой отправкой заданий на роботизированный стенд для синтеза, очистки и испытаний | Непрерывный прогон 48 часов, скрининг 2.7 млн молекул-кандидатов, за 4 итерации получен экспериментально подтверждённый физический образец новой охлаждающей жидкости |
| Планирование облачных ресурсов (Alibaba Cloud + MindOpt) | Маршрутизация мультимодельных вызовов при разметке данных, онлайн-аллокация GPU и офлайн-перебалансировка CPU: генерация алгоритмов-кандидатов и совместная итеративная проверка с собственным солвером Alibaba MindOpt | Затраты на диспетчеризацию разметки снижены в среднем на 10.42%, простой целых узлов GPU в онлайне увеличен на 4.62% (высвобожденный пул), поиск оптимума при офлайн-перебалансировке CPU ускорен более чем в 14.61 раза |
Все перечисленные кейсы — это витринные проекты самой Alibaba и её партнёров без независимого воспроизведения третьими сторонами, поэтому приведённые проценты экономии времени и кратность ускорения стоит воспринимать как верхнюю планку в специально настроенном пайплайне.
Когда от модели требуют выдать готовую статическую страницу по одной короткой фразе, в пользовательских сравнениях отмечают, что по визуальной фактуре Qwen4-Max уступает ведущим передовым моделям. Например, в сравнительной генерации страниц китайского зодиака по одному промпту против GPT-6 Astra и DeepSeek V4.1 Flash каркас у preview-версии получился цельным, но свет, тени и мелкие детали оказались плоскими.
Чтобы получать качественный фронтенд и интерактивные интерфейсы, критерии готовности нужно явно задавать в промпте, а после генерации черновика точечно дорабатывать палитру и анимации в несколько итераций. В конец технического задания удобно добавлять такой чек-лист самопроверки:
Перед сдачей фронтенд-страницы проверь по пунктам:1. Визуальная иерархия: отступы, контраст размеров шрифта и цветовые акценты считываются сразу; не оставляй нестилизованные браузерные элементы форм по умолчанию.2. Интерактивность и состояния: все кнопки, фильтры, модальные окна и формы работают; добавь состояния наведения (hover), загрузки (loading) и пустых данных (Empty State).3. Доработка слабых мест: перед финальным ответом оцени страницу целиком, выбери самый слабый по визуалу или UX блок и отдельно доработай его ещё за один проход.4. Проверка рендеринга: убедись, что разметка рендерится полностью, нет незакрытых тегов, разъехавшейся вёрстки и ошибок в консоли браузера.С учётом результатов бенчмарков, времени ответа и расчётов стоимости выше, рекомендации по выбору модели под конкретные нагрузки выглядят так:
| Нагрузка / сценарий | Рекомендация | Аргументы и компромиссы |
|---|---|---|
| Многошаговые агенты с длинным контекстом / разбор документов и due diligence | Подходит для прямой работы | Контекст 1M токенов; 1-е место в ALE (46.7) и юридическом HLAB-Vals (21.3); попадание в кэш всего ¥0.5/млн в КНР ($0.075/млн глобально), стоимость задачи в Work360 снижена на 62% ($1.67). В продакшене рекомендуется настраивать явный кэш |
| Исправление багов в репозиториях и повседневный фулстек | Подходит с переключением уровня | 75.7 балла в DeepSWE v1.1; для рутинных правок оставляйте уровень по умолчанию high, а на сложном фулстеке и терминальных задачах переключайтесь на xhigh (в Terminal-Bench разница между ними составляет 17 баллов) |
| Интенсивная работа в терминале / воссоздание ПО «вслепую» | Лучше взять Claude или Kimi | В Terminal-Bench 4.0 всего 48.5 (у Kimi K3.1 — 67.2, у Opus 5.5 — 59.6); в ProgramBench всего 31.5 (у Opus 5.5 — 65.0) |
| Максимальный Intelligence Index при низкой цене за задачу | Лучше смотреть на GPT-6.1 Sol | В Artificial Analysis у GPT-6.1 Sol (max) индекс 55 и $1.27 за задачу; у Qwen4-Max индекс 43 и $3.27 за задачу |
| Генерация фронтенда по одному промпту | Требует подробного чек-листа | 6-е место в CodeArena WebDev (1,750 ±15), но при генерации в один шаг картинка часто выходит плоской — нужно явно прописывать требования к визуальной иерархии, пустым состояниям и дорабатывать итерациями |
| Критична задержка до первого токена и общее время / нужен локальный запуск | Не подходит | В замерах AA ожидание первого токена ответа составляет 147.63 с, среднее время на задачу — 32.1 мин; веса Max закрыты (только API), а размеры и даты релиза младших открытых моделей Qwen4 ещё не объявлены |
Модель можно подключить напрямую. Подписка Token Plan в QwenCloud совместима с протоколами OpenAI и Anthropic Messages, а в список официально поддерживаемых инструментов входят Claude Code, Cursor, Qwen Code, Codex, Qoder и OpenClaw (именно в Claude Code проводился тест канала The Dark Factory выше). При работе через интерфейс Anthropic Messages уровень рассуждений передаётся в параметре output_config.effort, где medium автоматически приводится к high, а max — к xhigh. Учитывайте, что для Token Plan используется отдельный эндпоинт token-plan.maas.qwencloudapi.com и специальный ключ с префиксом sk-sp-, который нельзя смешивать с ключами для поминутной/потокенной оплаты.
В материковом Китае (Alibaba Cloud Model Studio) стандартный ввод стоит ¥10 за 1 млн токенов, вывод — ¥30/млн, попадание в кэш — ¥0.5/млн, а новым пользователям даётся бесплатная квота на 1 млн токенов сроком на 90 дней. На международной платформе (QwenCloud, Сингапур) стандартный ввод стоит $1.5 за 1 млн токенов, вывод — $4.5/млн, попадание в кэш — $0.075/млн (для международного развёртывания внутри китайского Model Studio действует отдельный тариф ¥10.938 / ¥32.813). В пересчёте по курсу базовые расценки практически совпадают, однако подписка Token Plan сейчас продаётся и работает только в сингапурском регионе.
Сама Qwen4-Max остаётся проприетарной и доступна только через облачный API и официальные приложения. В релизном посте команда Qwen сообщила, что модели малого и среднего размера из семейства Qwen4, построенные на той же архитектуре и методике обучения, будут последовательно выходить с открытыми весами, но точные размеры и даты выпуска пока не названы.
В CodingPass доступны Claude, GPT, Gemini и Qwen3.8 Flash со списанием по официальным ценам API. Никаких неожиданных списаний, отмена в любой момент.