Вышла Claude Fable 5.2: бенчмарки, цены и впечатления редакции
Официальные бенчмарки Fable 5.2, новые цены, какой уровень рассуждений выбрать и как переключиться на неё в CodingPass Pro.
На всех графиках анонса OpenAI по горизонтальной оси отложена стоимость одной задачи. Экономия реальная: на Agents' Last Exam задача у Astra обходится в 5% от цены Fable 5.2. Но код лучше не стал, галлюцинаций больше, а читаемость планов вызывает жалобы у тестировщиков. Сводим официальные цифры, замеры AA и отзывы разработчиков.
OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol. Astra — новый флагман для «самых сложных проектов», Sol — основная модель на каждый день. Обе в один день вышли в ChatGPT, Codex и API под идентификаторами gpt-6.2-astra и gpt-6.2-sol.
Первые пользователи заметили GPT-6.2 Sol в A/B-тестах ChatGPT ещё в начале ноября, но официальный релиз затянулся почти на 20 дней. Главный аргумент вышедшего обновления — цена. На странице релиза почти у каждого графика по оси X указана стоимость одной задачи: тариф на Astra снизили на 20%, а стоимость отдельного прогона в ряде тестов оказалась в разы ниже, чем у конкурентов.
Если же свести вместе данные OpenAI, независимые замеры Artificial Analysis (AA) и практику разработчиков, картина меняется. В программировании прогресса нет, доля галлюцинаций выросла, а планирование и объяснение решений по-прежнему хромают. Реакция сообщества оказалась жёсткой: уже на второй день после релиза часть разработчиков вернулась на Claude.
Коротко: GPT-6.2 действительно экономит бюджет, но прибавила в основном в научных расчётах, 3D и работе с юридическими документами. В AA Coding Agent Index модель Astra осталась на уровне GPT-6 Astra (53 балла), а Sol отстала от GPT-6.1 Sol на 3 балла; доля галлюцинаций у Astra выросла с 50% до 59%. В длинных агентных сессиях разработчики жалуются на зацикливание и невнятные отчёты. Писать код разумнее на Claude, а код-ревью выгоднее перенести на GPT-6.2 Sol.
На странице анонса кривые стоимости выглядят убедительно, но в сообществе настроение изменилось буквально за день. В обсуждениях на Hacker News и в X жалоб на Astra заметно больше, чем похвалы, и претензии повторяются.
Зацикливание на длинных задачах. Самый заметный разбор опубликовал автор T3 Code Тео (Theo): ещё во время раннего тестирования он отправил OpenAI длинное письмо, а 17 ноября выложил его целиком под заголовком «Why I hate GPT-6.2 Astra» — за сутки пост набрал более 1,75 млн просмотров. Он проверял модель на переписывании компилятора TypeScript на Rust: до этого модели OpenAI сожгли на проекте больше $300 тыс. в токенах без результата, тогда как Opus закрыл задачу меньше чем за две недели и примерно за $20 тыс. GPT-6.2 Astra проработала семь дней подряд, не внесла ни одного улучшения и, решив «заодно уменьшить размер», замедлила компилятор на 56%; после переключения цели на производительность за следующие четыре дня изменений не появилось вовсе. В другой задаче на втором часу работы модель остановилась, чтобы уточнить название внутреннего промежуточного файла, и заблокировала сама себя.
Невнятные отчёты после прогона. Та же проблема проявляется в планировании: тексты выходят запутанными. Тео уже завёл привычку после длинного прогона Astra отдавать результат Opus 5.5, чтобы та кратко пересказала суть. На вопрос, почему worktree на одной машине работает медленнее, чем на трёх других, Astra выдала четыре абзаца про механизмы кэширования pnpm, а Opus 5.5 ответила одной строкой: «медленный SSD». Попытки поправить это через системный промпт с просьбой «отвечать проще» не помогли.
Нужен постоянный контроль. Участники HN отмечают, что Astra способна решать сложные задачи, но требует плотного надзора и выверенных промптов — всего того, без чего обходится Opus 5.5. Про Sol пишут, что она по-прежнему склонна к избыточному усложнению (overengineering), а качество кода Astra не оправдывает её цену. Даже в код-ревью бывают завышенные оценки: один из разработчиков прогнал продакшен-код через Astra и получил список из 12 проблем (8 с приоритетом P2), а после совместной проверки с Fable 5.2 осталось только 8 мелких замечаний P3.
Скорость не выросла. По замерам пользователей, обе модели выдают 20–80 токенов в секунду — на уровне прошлого поколения и примерно в пять раз медленнее моделей Anthropic. Часть разработчиков прямо пишет, что у OpenAI последние пару месяцев не задались, и возвращается с Astra на Opus 5.5.
Положительные отзывы тоже есть, и они совпадают с сильными сторонами в тестах: даже Тео признаёт, что Astra отлично проводит код-ревью, уверенно работает с 3D, играми и управлением компьютером. На HN некоторые хвалят Sol в сравнении с Opus 5.5 и отмечают, что по макетам UI она впервые догнала Claude.
На наш взгляд, расхождение между бенчмарками и реальной работой возникает именно там, что тесты почти не измеряют: застревает ли агент на длинной дистанции и способен ли внятно объяснить, что он сделал. Графики показывают цену одного прогона, но не учитывают время человека на присмотр за моделью и повторный пересказ её вывода через другую нейросеть.
Для Astra вход и выход подешевели на 20%, а чтение из кэша упало с $1 до $0.40 за миллион токенов. Тарифы Sol не изменились. Текущие $8 / $40 у Astra совпадают со сниженной ценой Fable 5.2 — в прошлом поколении GPT-6 Astra точно так же выравнивали по Fable 5.
| Модель | Ввод | Чтение из кэша | Запись в кэш | Вывод | Граница знаний |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $40 | 2026-05-18 |
| GPT-6 Astra | $10 | $1 | $12.50 | $50 | 2026-04-30 |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $10 | 2026-06-01 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $10 | 2026-04-30 |
Обе модели получили контекстное окно в 1 050 000 токенов и лимит вывода до 128 000 токенов. В примечаниях к прайсу в документации OpenAI есть несколько важных условий для длинных сессий:
Границу знаний сдвинули на две-четыре недели вперёд. Во время скрытого тестирования именно по ней отличали старую версию от новой: без доступа к сети спрашивали, знает ли модель про Fable 5, — GPT-6 Astra и GPT-6.1 Sol о ней не знали.
Главный тест в анонсе OpenAI — Agents' Last Exam, оценивающий длительную многошаговую работу. На сверхвысоком уровне рассуждений (xhigh) Astra набирает 78,3% при стоимости $2.89 за задачу; Fable 5.2 на уровне Max показывает 72,8% и $60.05. OpenAI подаёт это как «на 5,5 балла выше за 5% от стоимости».
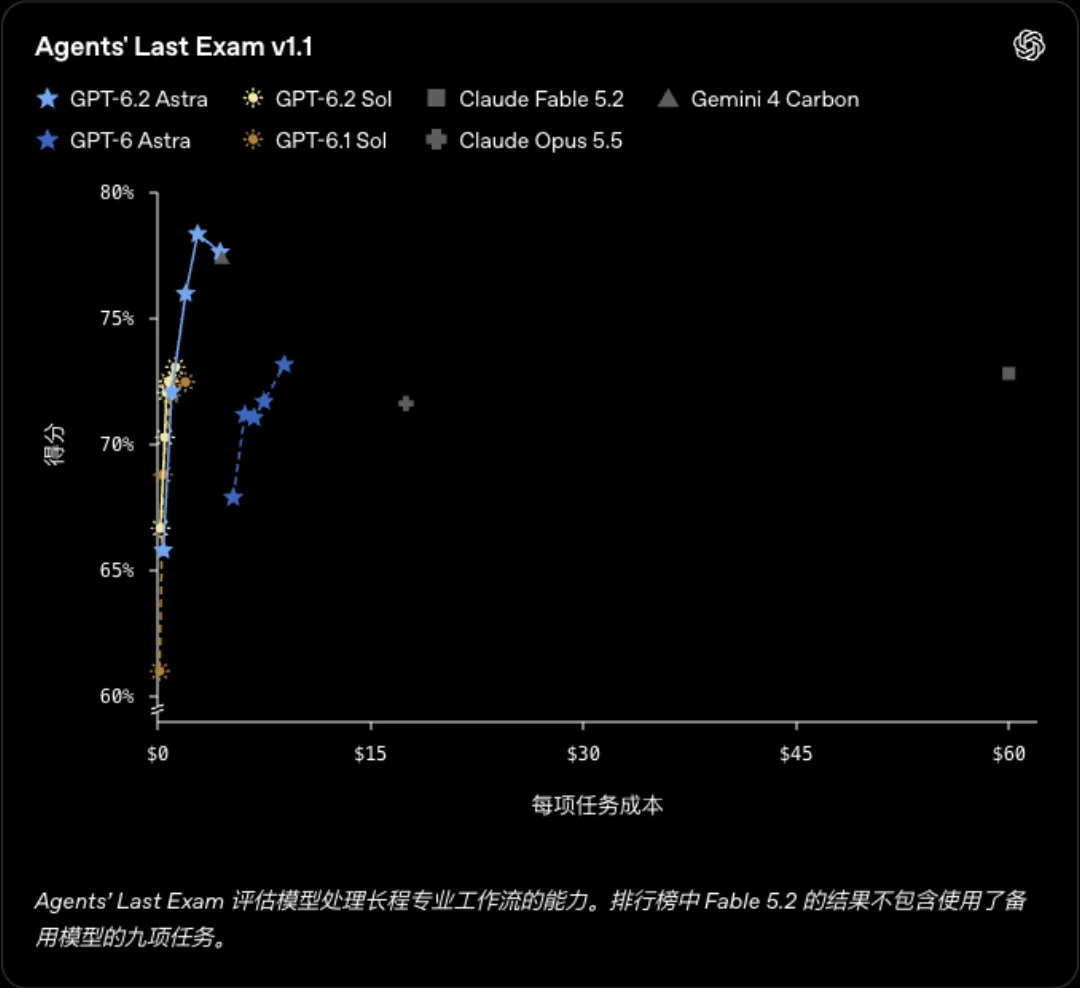
На этот график стоит посмотреть внимательнее:
High модель Carbon набирает 77,4% при $4.60 — всего на 0,9 балла ниже лучшего результата Astra. А вот при переключении Astra на Max её балл снижается до 77,6%, а цена растёт до $4.47 — практически без отличий от Carbon. В тексте анонса OpenAI сравнивает себя только с Fable 5.2 и GPT-6 Astra, не упоминая Carbon.Max набирает 73,0% за $1.32 — уровень прошлого флагмана GPT-6 Astra (73,1%, $8.99), но в семь раз дешевле.Результаты остальных официальных тестов (взяты лучшие режимы каждой модели):
| Тест | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | Claude Fable 5.2 |
|---|---|---|---|---|
| Agents' Last Exam | 78,3% ($2.89) | 73,0% ($1.32) | 73,1% ($8.99) | 72,8% ($60.05) |
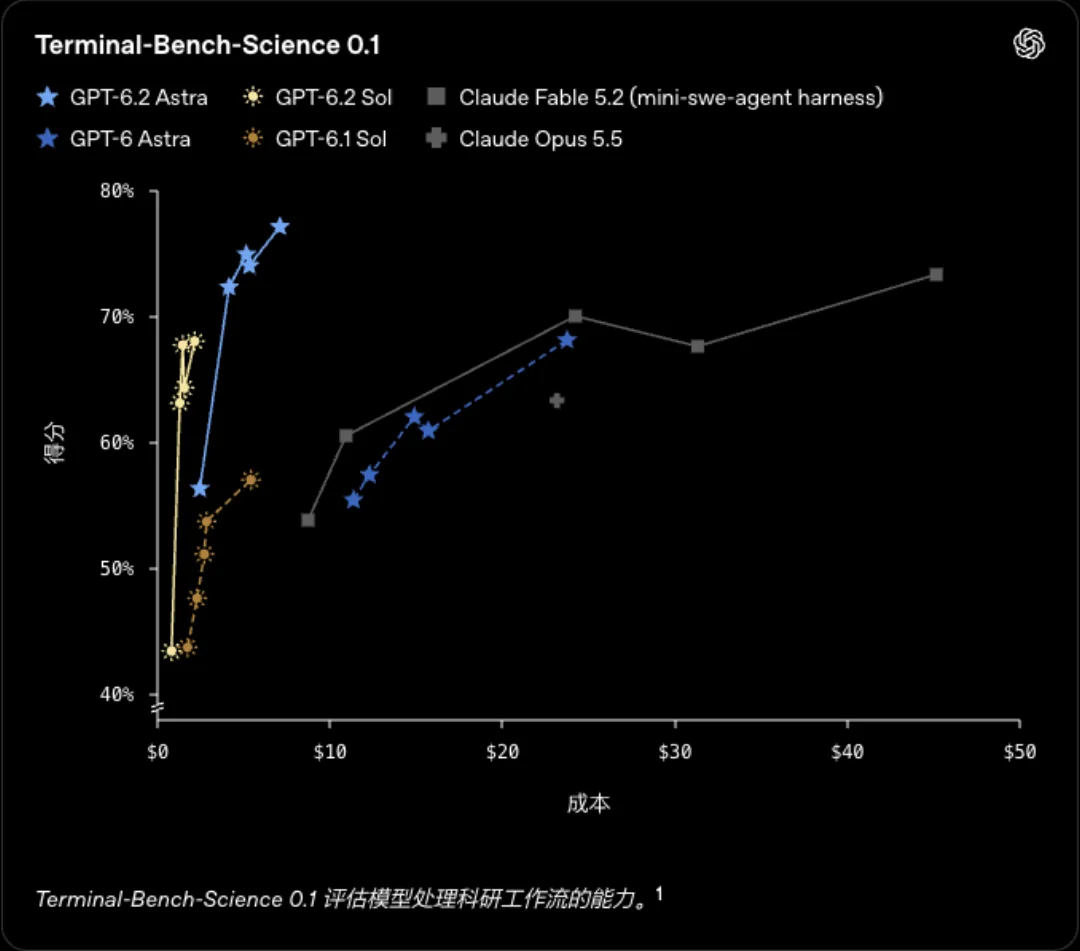
| Terminal-Bench-Science 0.1 | 77,1% ($7.15) | 68,0% ($2.21) | 68,1% ($23.80) | 73,3% ($45.21)* |
| FrontierCode 2.0 | 44,2% ($5.97) | 43,8% ($1.29) | 42,8% ($6.68) | 49,1% ($14.19) |
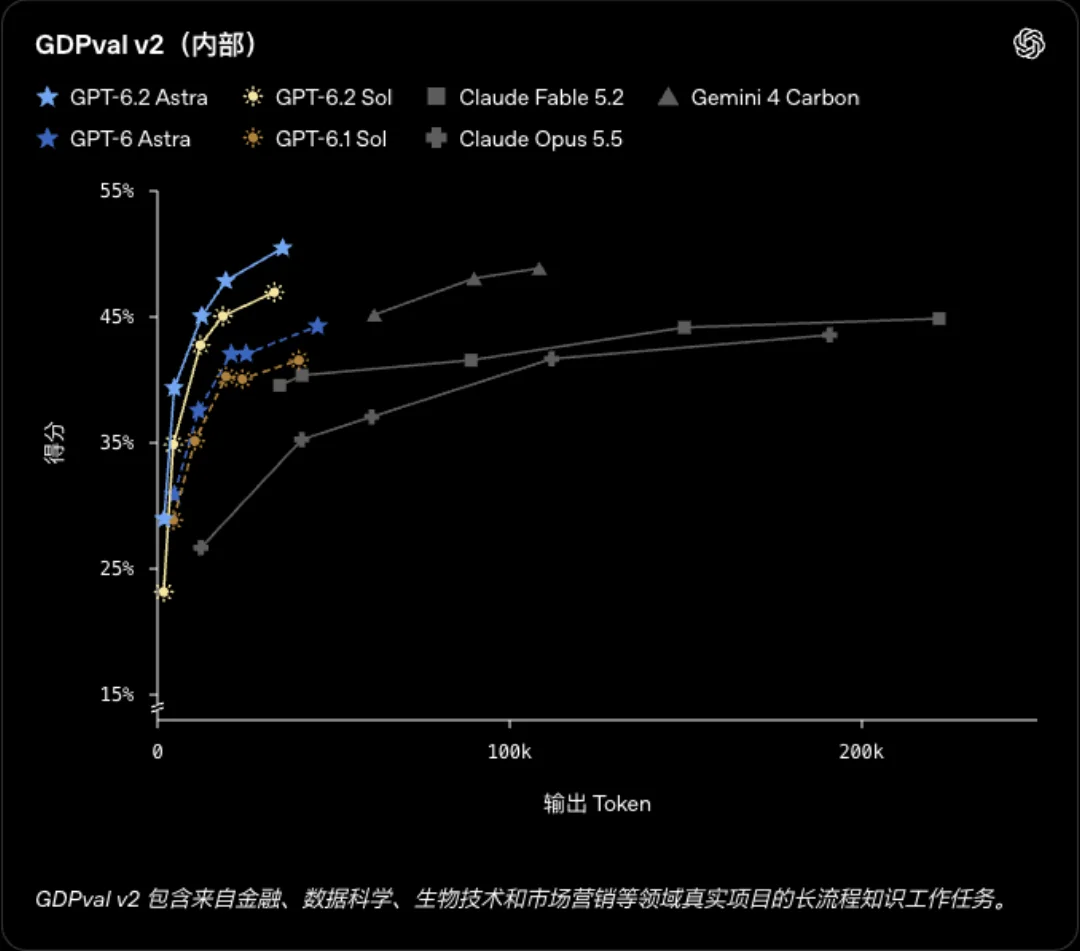
| GDPval v2 (внутренний, OpenAI) | 50,4% | 46,9% | 44,2% | 44,8% |
| Harvey LAB-AA v1.1 | 15,0% ($6.35) | 11,1% ($1.92) | 8,6% ($13.67) | 7,2% ($39.84) |
| LifeVal | 86,1% ($4.23) | 83,8% ($1.27) | 79,8% ($9.04) | — |
* Результат Fable 5.2 в Terminal-Bench-Science взят у AA на базе оснастки mini-swe-agent. В сноске OpenAI уточняет: по отчёту Anthropic в Claude Code на уровне Max модель набирает 74,6%.
Научные задачи — главный козырь релиза. В Terminal-Bench-Science, проверяющем исследовательскую работу в терминале, Astra опережает GPT-6 Astra на 9 процентных пунктов при цене менее трети. OpenAI прямо называет Astra «лучшей моделью в мире для учёных», и в Vals Science Index она также заняла первое место. Для научных расчётов исследователи и раньше выбирали GPT, а теперь отрыв стал ещё заметнее.
GDPval v2 и юридические задачи. Внутренний тест OpenAI GDPval v2 проверяет длительные рабочие процессы на реальных проектах из консалтинга, финансов и дизайна. Astra опережает GPT-6 Astra на 6,2 процентного пункта, тратя на 22% меньше выходных токенов; Sol прибавила 5,3 пункта к GPT-6.1 Sol. В юридическом бенчмарке Harvey LAB-AA доля пройденных заданий у Astra более чем вдвое выше, чем у Fable 5.2, примерно за одну шестую цены. Однако задача там засчитывается только при выполнении всех требований без существенных галлюцинаций — то есть при 15% успеха 85% заданий модель всё равно проваливает.
Сильная просадка на низком уровне рассуждений. LifeVal проверяет бытовые сценарии вроде выбора детского сада, поиска жилья или составления меню. На уровне Max Sol набирает 83,8% при одной седьмой от цены GPT-6 Astra, но при переключении на low падает до 25,3% — тогда как GPT-6.1 Sol на том же уровне давала 66,8%. У Astra на low результат снизился с 67,5% до 46,3%. Экономить за счёт минимального уровня рассуждений в этом поколении рискованно.
В анонсе OpenAI заявляет, что Astra пишет «более чистый код» и лучше вносит и тестирует сложные правки в существующих репозиториях. Но собственный график компании по FrontierCode 2.0 показывает другую картину.
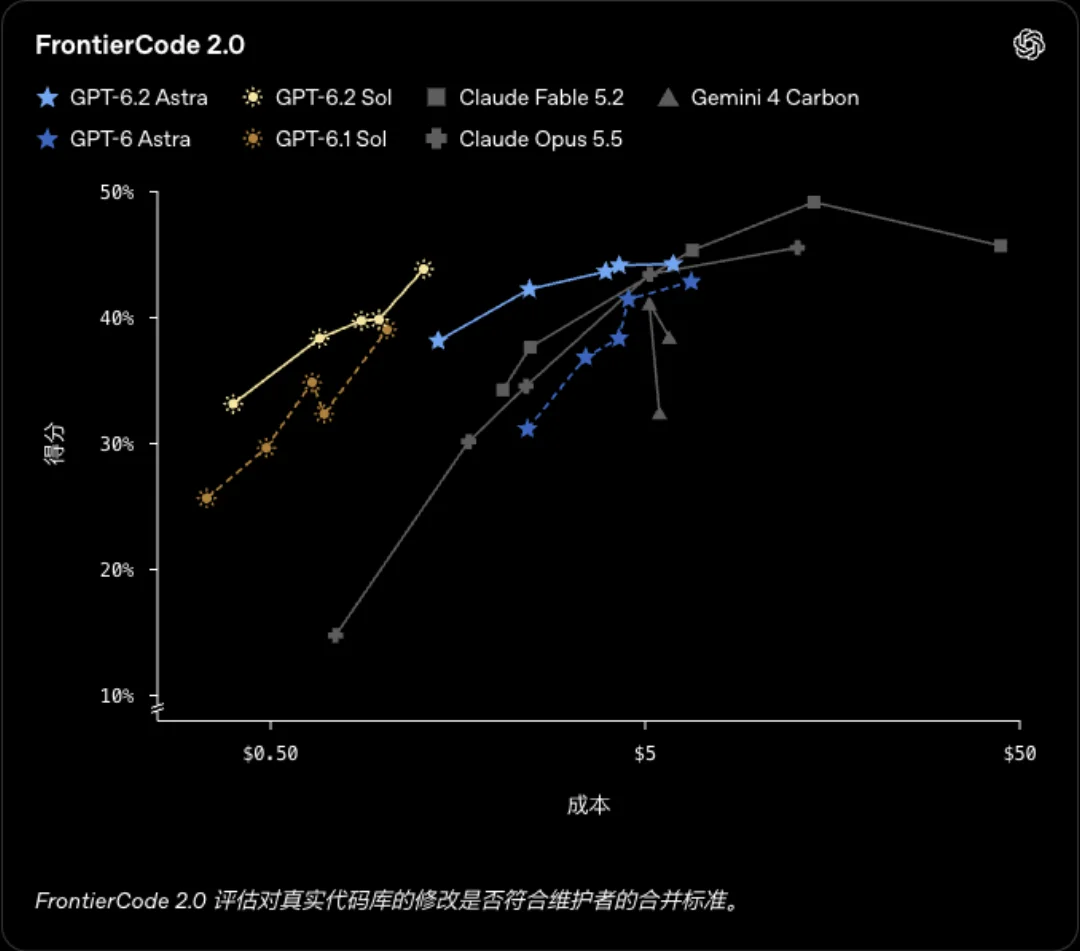
FrontierCode 2.0 оценивает, проходят ли изменения требования мейнтейнеров к слиянию кода. Лучший результат Astra — 44,2%: это ниже не только Fable 5.2 (49,1%), но и прошлогодней Claude Opus 5.5 (45,5%), и всего на 1,4 балла выше GPT-6 Astra. В самом тексте OpenAI предпочитает подчёркивать другое сравнение: Sol отстала от Astra меньше чем на 0,5 балла, но стоит примерно в пять раз дешевле.
Независимый замер Artificial Analysis ещё жёстче. В AA Coding Agent Index (оснастка Codex, уровень Max) GPT-6.2 Astra набрала 53 балла — ровно столько же, сколько GPT-6 Astra. У GPT-6.2 Sol результат 49 баллов, что на 3 балла ниже GPT-6.1 Sol. Для сравнения: Fable 5.2 и Opus 5.5 в Claude Code набирают по 58.
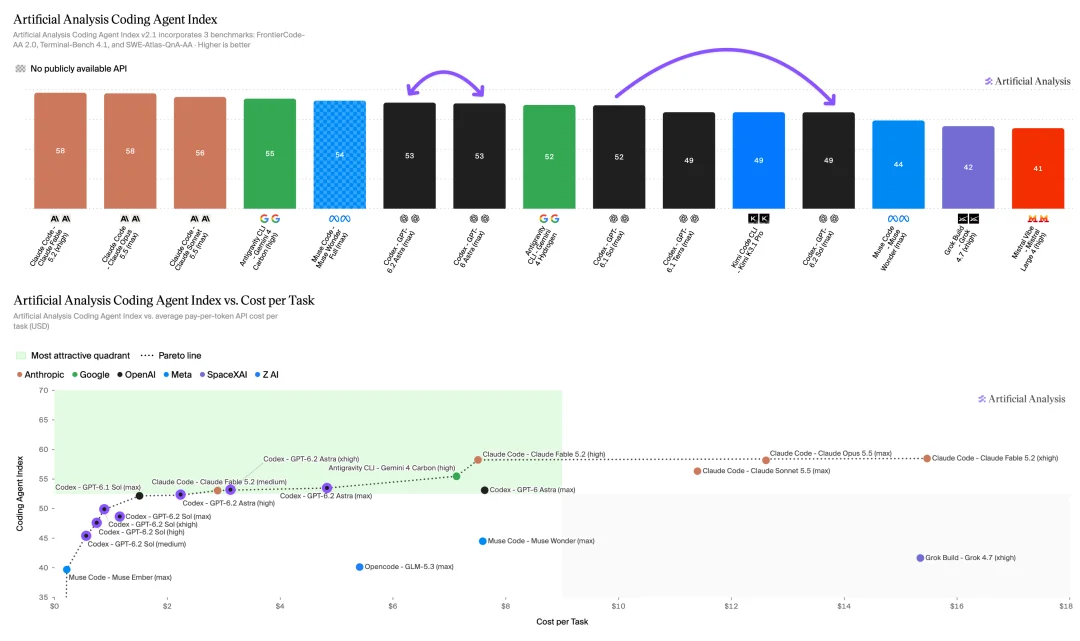
В AA объясняют падение тем, что в тесте SWE-Atlas-QnA-AA модель Sol потеряла 14 баллов и стала чаще упускать ключевые факты в ответах. При этом эксперты AA подтверждают: по соотношению качества и цены за задачу несколько режимов Astra и Sol уверенно выходят на границу Парето — экономия действительно заметна.
В сводном рейтинге AA Intelligence Index v5 (девять бенчмарков) GPT-6.2 Astra на уровне Max набрала 62 балла — на 5 больше, чем GPT-6 Astra. Это позволило обойти Gemini 4 Carbon (60) и Claude Opus 5.5 (59) и занять второе место после Claude Fable 5.2 (65). У GPT-6.2 Sol 57 баллов: на 2 балла выше GPT-6.1 Sol и вровень с GPT-6 Astra при стоимости около 15% от её цены.
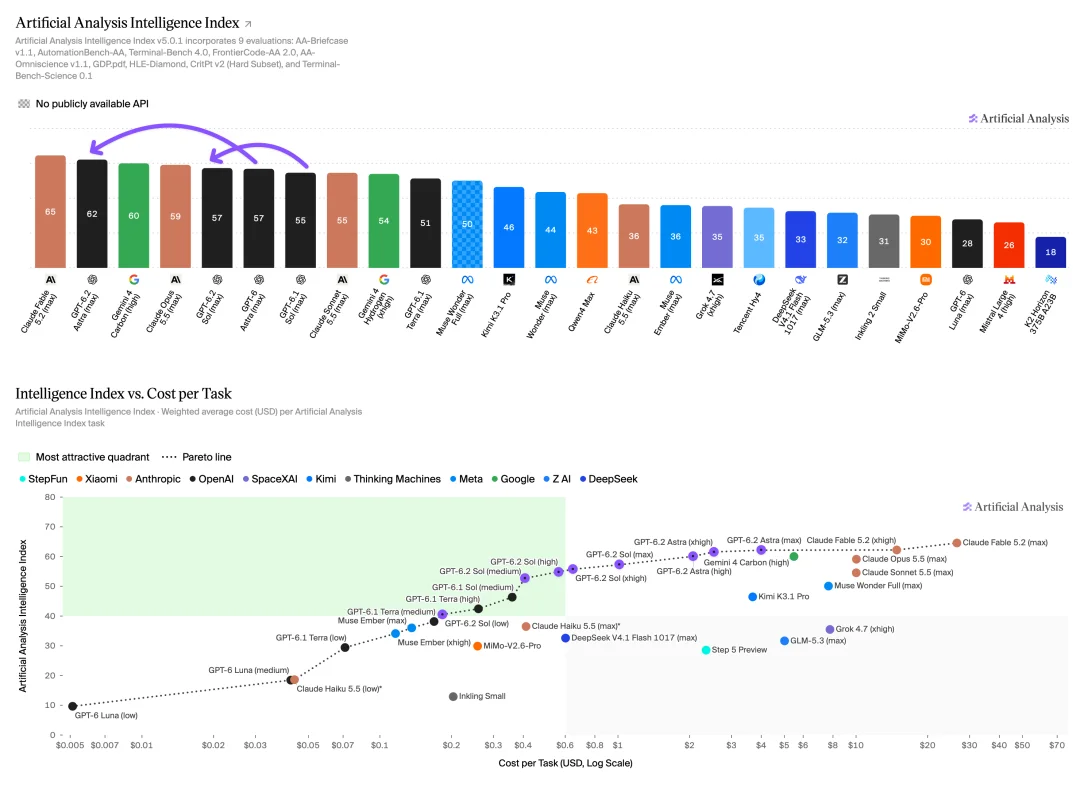
Во время закрытого тестирования по сети ходили слухи, что Sol якобы выбивает 60 баллов и делит первое место. Итоговый замер оказался ниже на 3 балла — 57.
Низкий чек объясняется объёмом вывода. AA посчитала, сколько выходных токенов в среднем уходит на одно задание индекса:
| Модель (уровень) | Выходных токенов / задачу | Цена вывода (за 1M) | Стоимость вывода / задачу |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 40K | $10 | $0.40 |
| GPT-6.2 Astra (Max) | 41K | $40 | $1.64 |
| GPT-6 Astra (Max) | 52K | $50 | $2.60 |
| Gemini 4 Carbon (High) | 123K | $10 | $1.23 |
| Claude Fable 5.2 (Max) | 274K | $40 | $10.96 |
При одинаковой цене за миллион токенов на одной и той же задаче Fable 5.2 генерирует в 6,7 раза больше текста и токенов рассуждений, чем Astra. На бумаге тариф идентичен, а итоговый счёт отличается на порядок. Разработчики проверили это и на подписке ChatGPT Pro за $200: за 4 видео- и 3D-кейса, 2 крупных плана и почти сотню код-ревью у Astra ушло 6% недельной квоты, тогда как раньше на 10 прогонах Fable 5.2 сгорало около 30%.
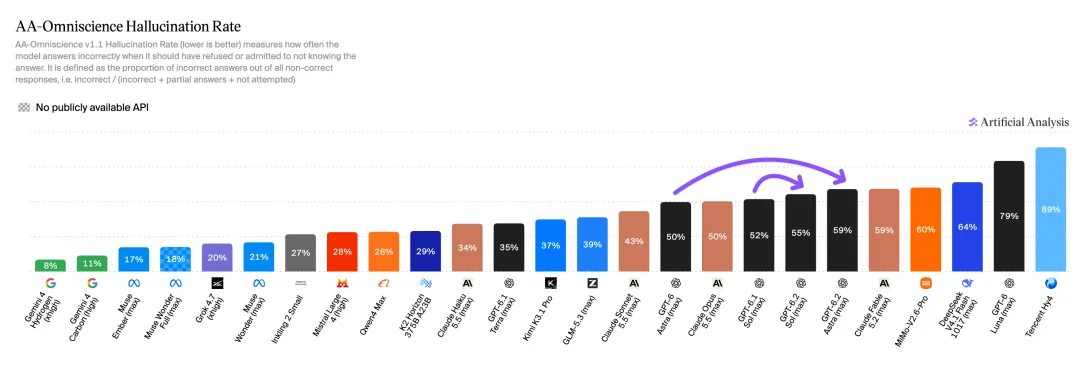
Но за экономию токенов приходится платить. В тесте AA-Omniscience, который проверяет, начинает ли модель выдумывать вместо того чтобы признать незнание, доля галлюцинаций у GPT-6.2 Astra выросла с 50% (у GPT-6 Astra) до 59%, а у Sol — с 52% (у 6.1 Sol) до 55%. Для сравнения, у Gemini 4 Carbon этот показатель составляет 11%.
Результаты пользовательских тестов на собственных проектах полностью совпадают с замерами: сильные стороны стали ещё лучше, а прежние слабые места никуда не делись.
Код-ревью — главный рывок. Схема «код пишет Claude, а проверяет GPT до трёх итераций» уже стала привычной. На собственном наборе тестов при уровне xhigh GPT-6.1 Sol находила 65% проблем, GPT-6.2 Sol — 84%, а GPT-6.2 Astra — 96%. Astra вдвое медленнее и вчетверо дороже Sol, находя на полтора десятка багов больше, поэтому тестировщик выбрал GPT-6.2 Sol xhigh в качестве модели по умолчанию для ревью.
Планирование и коммуникация всё так же проседают. На одинаковом задании — спроектировать систему комментариев для личного новостного сайта с учётом требований регуляторов и минимальных затрат — Gemini 4 Carbon за 5 минут выдала чёткий план: сначала требования к верификации и премодерации, затем бюджетная архитектура (без кастомных ников и многоуровневых веток, только избранные комментарии) с опорой на уже имеющегося на сайте агента модерации и сравнительная таблица вариантов. GPT-6.2 Astra думала 24 минуты, выдала небольшой, но запутанный текст и предложила на старте проверять комментарии вручную, что для проекта с одним автором нереалистично. По ощущениям тестировщика, по читаемости и инициативе в планировании новая версия уступила даже ранней GPT-6 Astra.
Неровные результаты в визуале. На одном и том же промпте для ролика к четырёхлетию ChatGPT работы Fable 5.2 и Gemini 4 Carbon получились смотрибельными, а результат Astra тестировщик описал как «посмотрел — и слов не осталось». Зато в 3D всё наоборот: паркур-игра от первого лица, осенняя сельская станция на Three.js и реконструкция древнегреческого полиса по референсам превзошли ожидания — над последним проектом модель работала больше часа.
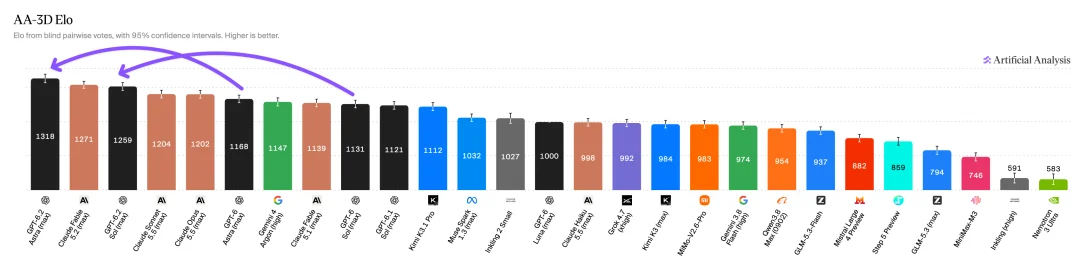
Оценки AA по 3D это подтверждают. В рейтинге AA-3D (слепое попарное голосование людей) GPT-6.2 Astra лидирует с 1318 очками против 1271 у Fable 5.2 и 1259 у GPT-6.2 Sol. В предварительном тесте по робототехнике (AA-Robotics v0.1) Astra набрала 79 баллов, Sol — 78, Fable 5.2 — 75.
В числе примеров OpenAI также показала редактируемую финансовую модель со ставкой дисконтирования 8% и терминальным ростом 3%, 19-слайдовую презентацию по корпоративному шаблону с точным соблюдением кеглей, подетальное моделирование радиоуправляемого внедорожника и рядного шестицилиндрового двигателя в CAD и браузерную гонку Meridian Sound Racing. В финансовом бенчмарке AA-AnalystAgent Astra безошибочно прошла 62,5% заданий во всех пяти независимых попытках.
О нескольких слабых местах OpenAI прямо написала на странице релиза и в системной карте GPT-6.2:
Сравнивать прайсы за миллион токенов напрямую бессмысленно — посчитаем по официальной стоимости одной задачи на 100 и 1000 запусков. В последней колонке указана цена задачи, делённая на долю успеха: грубая оценка стоимости одного удачного результата без учёта времени на ручную доработку.
| Модель (уровень) | Результат | 1 задача | 100 задач | 1000 задач | Цена с поправкой на результат |
|---|---|---|---|---|---|
| GPT-6.2 Sol (Max) | 73,0% | $1.32 | $132 | $1,320 | $1.81 |
| GPT-6.2 Astra (xhigh) | 78,3% | $2.89 | $289 | $2,890 | $3.69 |
| Gemini 4 Carbon (High) | 77,4% | $4.60 | $460 | $4,600 | $5.94 |
| GPT-6 Astra (Max) | 73,1% | $8.99 | $899 | $8,990 | $12.30 |
| Claude Opus 5.5 (Max) | 71,6% | $17.57 | $1,757 | $17,570 | $24.54 |
| Claude Fable 5.2 (Max) | 72,8% | $60.05 | $6,005 | $60,050 | $82.49 |
Стоимость задачи для Gemini 4 Carbon указана по вводным тарифам; с 1 декабря базовая цена Carbon удваивается.
Если сделать такой же пересчёт для программирования по FrontierCode 2.0 (стоимость задачи, делённая на балл, — сколько примерно стоит один готовый к слиянию патч), получится: GPT-6.2 Sol — $2.95, GPT-6.2 Astra — $13.51, Claude Opus 5.5 — $28.18, Claude Fable 5.2 — $28.90. На наш взгляд, именно эта раскладка показывает реальное место GPT-6.2: Sol даёт почти 90% результата Fable 5.2 примерно за десятую часть цены, а Astra в программировании застряла посередине — в 4,6 раза дороже Sol при прибавке всего в 0,4 балла.
| Задача | Рекомендация | Почему или какой компромисс |
|---|---|---|
| Написание кода, крупный рефакторинг | Claude Fable 5.2 / Opus 5.5 | Лидируют в FrontierCode и AA Coding Agent Index; Fable 5.2 расходует много токенов |
| Код-ревью, поиск багов | GPT-6.2 Sol (xhigh) | Находит 84% ошибок при четверти цены Astra; для 96% можно переключаться на Astra |
| Наука, анализ данных, эксперименты в терминале | GPT-6.2 Astra | Первое место в Terminal-Bench-Science, примерно в шесть раз дешевле Fable 5.2 |
| 3D, Three.js, прототипы игр | GPT-6.2 Astra | Лидер в AA-3D; в видео и моушн-графике по-прежнему слаба |
| Архитектурные планы, обсуждение требований | Gemini 4 Carbon / Claude | У GPT-6.2 запутанное изложение и долгие паузы |
| Фактчекинг, тексты с точными цитатами | Gemini 4 Carbon | Доля галлюцинаций у GPT-6.2 — 55%–59% против 11% у Carbon |
| Массовые недорогие агентные прогоны | GPT-6.2 Sol (medium и выше) | Не ставьте low: в LifeVal на low модель падает до 25,3% |
На практике хорошо работает связка: Claude или Gemini отвечают за проектирование и написание кода, а GPT-6.2 забирает строгие подзадачи и код-ревью. Линейка GPT остаётся дисциплинированной и плотной по фактам — для науки и алгоритмов это плюс, но с самостоятельным планированием и ясным изложением проблем у нового поколения легче не стало.
GPT-6.2 Sol доступна на тарифе Plus ($30 в месяц), Pro и командных тарифах — на Plus квота до $200 в месяц. GPT-6.2 Astra открыта на Pro ($100 в месяц) и командных тарифах — на Pro квота до $500 в месяц. Расход списывается по официальным ценам API OpenAI, чтение из кэша тарифицируется так же по официальным ценам.
codex -m gpt-6.2-sol # код-ревью и повседневные задачиcodex -m gpt-6.2-astra # научные расчёты и 3DПодробности подключения — в руководстве по Codex; в OpenCode, Cline и других клиентах указывайте те же ID моделей. Если вы только пишете код и модели GPT вам не требуются, обновлять тариф ради них не обязательно: Claude Sonnet 5.5 на Go и Opus 5.5 на Plus пишут код стабильнее GPT-6.2.
Один ключ для переключения моделей, списание по официальным ценам API. Никаких неожиданных списаний, отмена в любой момент.