Все модели
ID каждой модели, минимальный тариф и месячная квота в Go, Plus и Pro.
Tencent дистиллировала Hy4 flash из флагманской Hy4: ввод и вывод подешевели в 12 и 9 раз соответственно, а офисные задачи с презентациями, документами и таблицами обходятся примерно в ¥0.2 за штуку. В приложении к отчёту тесты программирования резко просели — для длинных инженерных сессий по-прежнему нужна Hy4. Сводим все бенчмарки, слепое тестирование, расчёт счетов по реальному трафику и параметры локального развёртывания.
16 ноября подразделение Tencent Hunyuan представило Hy4 flash — по формулировке разработчиков, «самую экономичную модель семейства Hy на сегодня». Это облегчённая версия Hy4 с открытыми весами: 224B общих параметров (из них 64B приходится на Engram), 12B активных параметров на токен, нативный ввод текста и изображений и контекстное окно 1M токенов. В API миллион входных токенов стоит ¥0.5, выходных — ¥2, а попадание в кэш — ¥0.02.
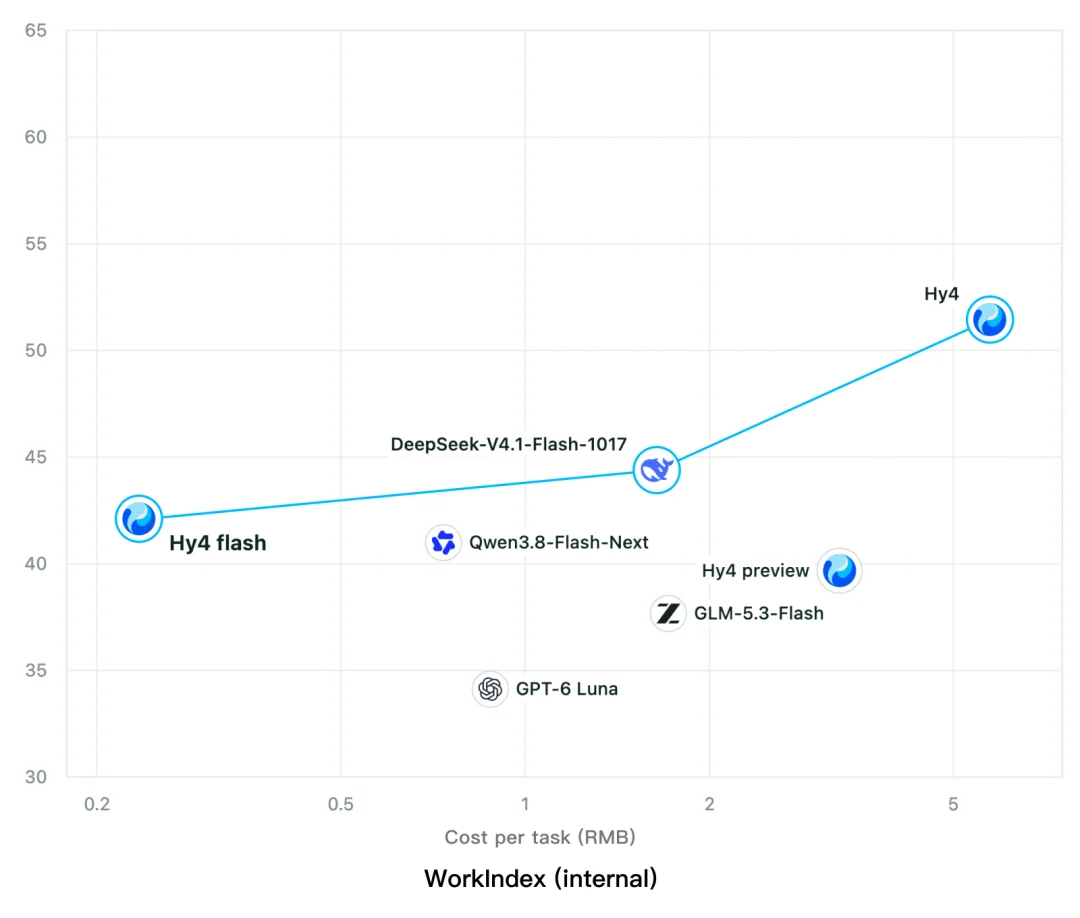
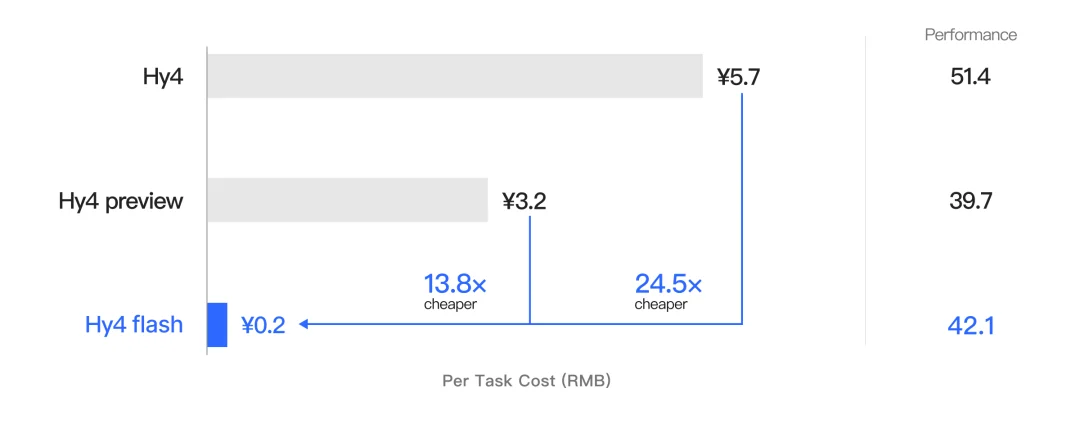
Главной витриной релиза стали не публичные рейтинги, а собственный бенчмарк WorkIndex. На повседневных офисных сценариях вроде подготовки презентаций, редактирования документов и работы с таблицами Hy4 flash набрала 42.1 балла — чуть выше Hy4 preview (39.7). При этом средняя стоимость задачи упала до ¥0.2 против ¥5.7 у полной Hy4.
Главное: для рутинных агентных задач — работы с документами, презентациями, глубокого поиска и простых веб-интерфейсов — у Hy4 flash самая низкая цена за запрос среди сопоставимых моделей. По структуре трафика CodingPass один запрос обходится примерно в ¥0.0064: это около 1/12 цены Hy4 и 3/10 от пикового тарифа DeepSeek-V4.1-Flash. Но для серьёзной разработки модель не подходит: в приложении к отчёту Terminal-Bench 4.0 упал до 19.2 (против 44.4 у Hy4 и 40.0 у DeepSeek-V4.1-Flash), а ProgramBench — до 16.0 (против 30.0 у Hy4). Сама Tencent прямо рекомендует оставлять длительную программную инженерию за старшей Hy4.
Экономию заложили в саму конструкцию модели: Hy4 flash сочетает гибридное внимание, LatentMoE и Engram, что сжало объём KV-кэша до 1/24 от уровня Hy3 и 1/6 от Hy4. Все архитектурные изменения, по заявлению команды, предварительно проверили на серии экспериментов по масштабированию (scaling ladder experiments).
Обучение прошло в два этапа: сначала самодистилляция из Hy4 для переноса базового интеллекта, затем обучение с подкреплением (RL), которое сократило среднюю длину сквозного вывода на 50%. На этапе инференса модель опирается на megakernels, 4-битное квантование и спекулятивное декодирование DFly2, за счёт чего скорость генерации превышает 150 токенов в секунду.
Подробная спецификация опубликована в README на GitHub:
| Параметр | Hy4 flash |
|---|---|
| Всего параметров | Основа 155.5B + Engram 63.5B + визуальный кодировщик 0.43B + DFly2 0.85B, суммарно около 220B |
| Активных на токен | Текст 11.3B + зрение 0.43B |
| Число слоёв | 42 слоя: 1 плотный + 41 слой MoE |
| Эксперты | 512 маршрутизируемых экспертов на слой (16 активных на токен) и 1 общий эксперт; вычисления идут в низкоразмерном латентном пространстве (LatentMoE) |
| Внимание | Чередование разреженного внимания (IndexPool, выбор до 2,048 позиций) и скользящего окна (окно 512 токенов) в пропорции 1:3 |
| Engram | Поиск представлений биграмм и триграмм по многоголовым хеш-таблицам на слоях 1, 11, 21, 31 (нумерация с 0) |
| Визуальный кодировщик | Адаптирован из SigLIP2-So400m и подключён к основе через MLP-проектор |
| Спекулятивное декодирование | Встроенный 5-слойный драфтер DFly2 переиспользует KV-кэш и разреженные индексы основной модели без дополнительной памяти под KV |
| Контекст | 1,048,576 токенов |
В блоге указаны округлённые значения 224B, 64B и 12B, тогда как сумма компонентов из README даёт 220B, 63.5B и 11.7B — расхождение компания не поясняет.
Hy4 flash уже работает в Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima и Marvis; в ближайшее время модель также появится на OpenRouter.
| Модель (¥ / 1M токенов) | Ввод (попадание в кэш) | Ввод | Вывод |
|---|---|---|---|
| Hy4 flash | 0.02 | 0.5 | 2 |
| Hy4 | 0.3 | 6 | 18 |
| DeepSeek-V4.1-Flash (часы пик) | 0.04 | 2 | 8 |
| DeepSeek-V4.1-Flash (непиковые часы) | 0.02 | 1 | 4 |
| GLM-5.3-Flash | 0.23 | 0.8 | 2.8 |
По сравнению с Hy4 ввод у flash-версии дешевле в 12 раз, вывод — в 9 раз, а чтение из кэша — в 15 раз. До 30 ноября в Tencent Cloud TokenHub действует скидка 50% на API, а внутри WorkBuddy модель временно доступна бесплатно.
Для сопоставления с DeepSeek-V4.1-Flash Tencent взяла тарифы в часы пик (01:00–04:00 и 06:00–10:00 UTC по будням, что соответствует 09:00–12:00 и 14:00–18:00 по пекинскому времени). Согласно странице тарифов DeepSeek, в непиковые часы цены вдвое ниже: попадание в кэш стоит те же ¥0.02, а ввод и вывод остаются в два раза дороже, чем у Hy4 flash. Цены GLM-5.3-Flash взяты с прайс-листа Zhipu.
Мы пересчитали расходы по реальному профилю трафика CodingPass: один агентный запрос в среднем расходует около 100K токенов, из которых ~5% приходится на свежий ввод, ~1% на вывод и ~94% на чтение из кэша.
Стоимость запроса = 5K × ввод + 94K × попадание в кэш + 1K × выводHy4 flash = 0.0025 + 0.00188 + 0.002 = ¥0.00638| Модель | За запрос (¥) | 10K запросов/мес (¥) | 100K запросов/мес (¥) | 1M запросов/мес (¥) |
|---|---|---|---|---|
| Hy4 flash | 0.0064 | 64 | 638 | 6,380 |
| DeepSeek-V4.1-Flash (непик) | 0.0109 | 109 | 1,088 | 10,880 |
| DeepSeek-V4.1-Flash (пик) | 0.0218 | 218 | 2,176 | 21,760 |
| GLM-5.3-Flash | 0.0284 | 284 | 2,842 | 28,420 |
| Hy4 | 0.0762 | 762 | 7,620 | 76,200 |
Поскольку более 90% токенов читается из кэша, итоговый счёт определяется именно его ставкой. У GLM-5.3-Flash ввод и вывод недорогие, но попадание в кэш стоит ¥0.23 — в 11.5 раза дороже Hy4 flash, из-за чего в этой раскладке она обходится дороже даже пикового тарифа DeepSeek.
Таблица исходит из равного расхода токенов у всех моделей. По данным Tencent, RL-обучение сократило сквозной вывод Hy4 flash на 50%: если она действительно укладывается в меньшее число токенов и шагов, разрыв увеличится. Если же модель не справляется с первого раза и требует переделки, реальную цену нужно считать как «стоимость попытки ÷ доля успеха с первого прохода».
Tencent опубликовала два набора тестов. Первый — внутренний WorkIndex на базе реальных задач WorkBuddy с ручной оценкой качества результата, длины ответа за шаг и времени выполнения; в него входят 8 подтестов (создание и правка презентаций, совместное редактирование PPT и Markdown, правка документов, починка таблиц, обработка аудио/видео и визуальное понимание). Второй — 7 открытых агентных бенчмарков: DeepSWE, ProgramBench, Terminal-Bench 4.0, APEX-Agents, AutomationBench, HLE и OSWorld 2.1. На обоих графиках по горизонтальной оси в логарифмическом масштабе отложена стоимость задачи в юанях. В WorkIndex Hy4 flash занимает крайнюю левую позицию, отставая от DeepSeek-V4.1-Flash примерно на 2 балла:
На 7 открытых агентных тестах отрыв по качеству становится заметнее:
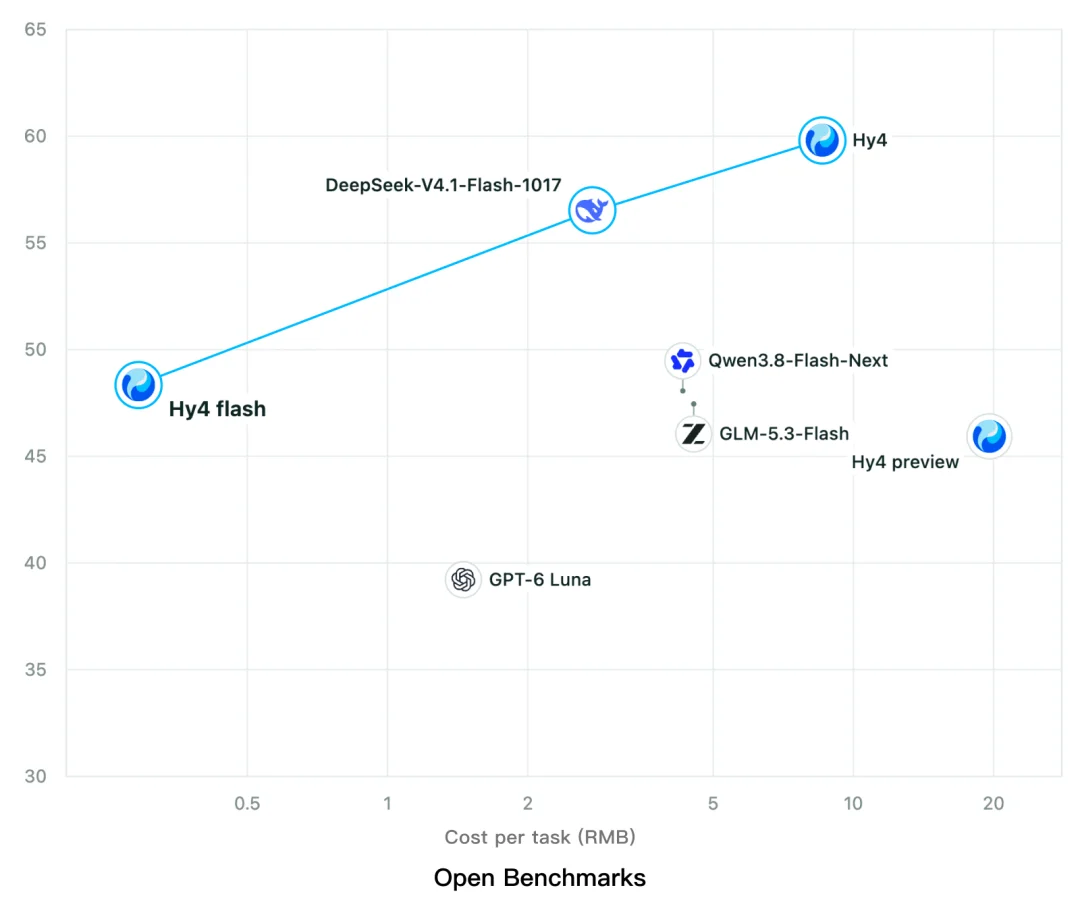
Здесь Hy4 flash идёт вровень с Qwen3.8-Flash-Next и GLM-5.3-Flash, уступает DeepSeek-V4.1-Flash около 8 баллов, но выигрывает у них на порядок по стоимости прогона.
Главный вывод компания строит вокруг WorkIndex: Hy4 flash немного опережает Hy4 preview по качеству при стоимости задачи в 1/13 от Hy4 preview, 1/20 от Hy4 и 1/8 от DeepSeek-V4.1-Flash-1017 (максимальный режим рассуждений, пиковый тариф).
В приложении приведены баллы и стоимость задачи по всем 17 тестам:
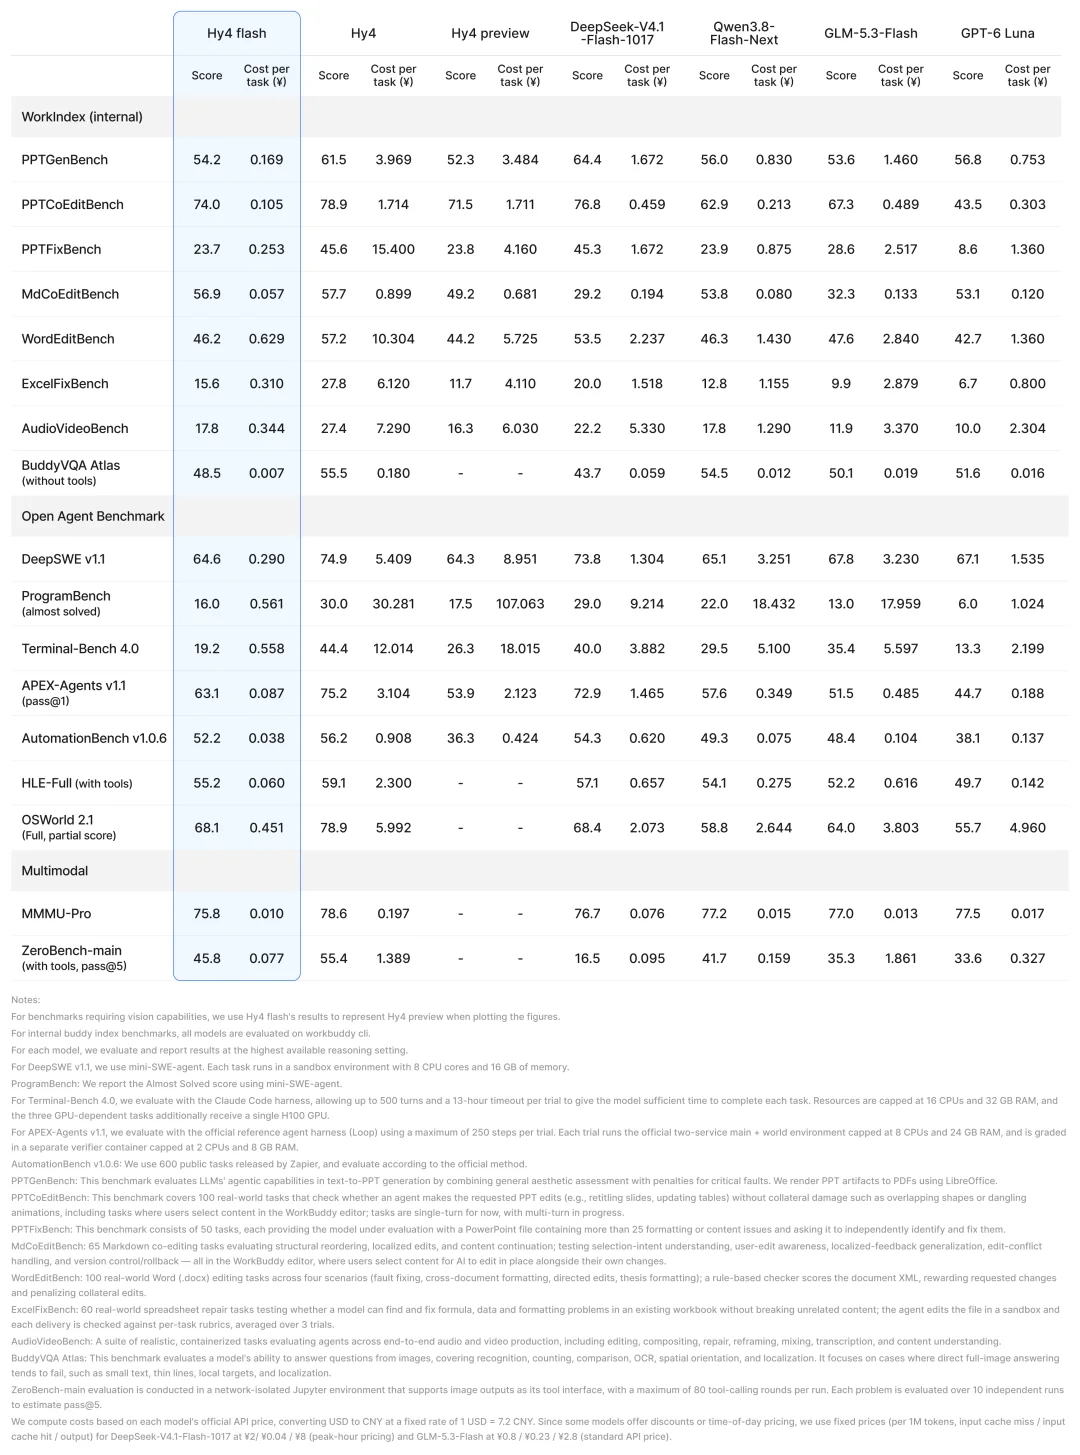
Для удобства мы разбили исходную таблицу на три части. В скобках указана стоимость одной задачи в юанях, полужирным выделен лучший балл среди пяти моделей класса Flash (Hy4 flash, DeepSeek-V4.1-Flash, Qwen3.8-Flash-Next, GLM-5.3-Flash и GPT-6 Luna):
| WorkIndex (внутренний, 8 тестов) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| PPTGenBench | 54.2 (0.169) | 61.5 (3.969) | 52.3 (3.484) | 64.4 (1.672) | 56.0 (0.830) | 53.6 (1.460) | 56.8 (0.753) |
| PPTCoEditBench | 74.0 (0.105) | 78.9 (1.714) | 71.5 (1.711) | 76.8 (0.459) | 62.9 (0.213) | 67.3 (0.489) | 43.5 (0.303) |
| PPTFixBench | 23.7 (0.253) | 45.6 (15.400) | 23.8 (4.160) | 45.3 (1.672) | 23.9 (0.875) | 28.6 (2.517) | 8.6 (1.360) |
| MdCoEditBench | 56.9 (0.057) | 57.7 (0.899) | 49.2 (0.681) | 29.2 (0.194) | 53.8 (0.080) | 32.3 (0.133) | 53.1 (0.120) |
| WordEditBench | 46.2 (0.629) | 57.2 (10.304) | 44.2 (5.725) | 53.5 (2.237) | 46.3 (1.430) | 47.6 (2.840) | 42.7 (1.360) |
| ExcelFixBench | 15.6 (0.310) | 27.8 (6.120) | 11.7 (4.110) | 20.0 (1.518) | 12.8 (1.155) | 9.9 (2.879) | 6.7 (0.800) |
| AudioVideoBench | 17.8 (0.344) | 27.4 (7.290) | 16.3 (6.030) | 22.2 (5.330) | 17.8 (1.290) | 11.9 (3.370) | 10.0 (2.304) |
| BuddyVQA Atlas (без инструментов) | 48.5 (0.007) | 55.5 (0.180) | — | 43.7 (0.059) | 54.5 (0.012) | 50.1 (0.019) | 51.6 (0.016) |
| Открытые агентные тесты (7) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 64.6 (0.290) | 74.9 (5.409) | 64.3 (8.951) | 73.8 (1.304) | 65.1 (3.251) | 67.8 (3.230) | 67.1 (1.535) |
| ProgramBench (almost solved) | 16.0 (0.561) | 30.0 (30.281) | 17.5 (107.063) | 29.0 (9.214) | 22.0 (18.432) | 13.0 (17.959) | 6.0 (1.024) |
| Terminal-Bench 4.0 | 19.2 (0.558) | 44.4 (12.014) | 26.3 (18.015) | 40.0 (3.882) | 29.5 (5.100) | 35.4 (5.597) | 13.3 (2.199) |
| APEX-Agents v1.1 (pass@1) | 63.1 (0.087) | 75.2 (3.104) | 53.9 (2.123) | 72.9 (1.465) | 57.6 (0.349) | 51.5 (0.485) | 44.7 (0.188) |
| AutomationBench v1.0.6 | 52.2 (0.038) | 56.2 (0.908) | 36.3 (0.424) | 54.3 (0.620) | 49.3 (0.075) | 48.4 (0.104) | 38.1 (0.137) |
| HLE-Full (с инструментами) | 55.2 (0.060) | 59.1 (2.300) | — | 57.1 (0.657) | 54.1 (0.275) | 52.2 (0.616) | 49.7 (0.142) |
| OSWorld 2.1 (Full, partial score) | 68.1 (0.451) | 78.9 (5.992) | — | 68.4 (2.073) | 58.8 (2.644) | 64.0 (3.803) | 55.7 (4.960) |
| Мультимодальные тесты (2) | Hy4 flash | Hy4 | Hy4 preview | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next | GLM-5.3-Flash | GPT-6 Luna |
|---|---|---|---|---|---|---|---|
| MMMU-Pro | 75.8 (0.010) | 78.6 (0.197) | — | 76.7 (0.076) | 77.2 (0.015) | 77.0 (0.013) | 77.5 (0.017) |
| ZeroBench-main (с инструментами, pass@5) | 45.8 (0.077) | 55.4 (1.389) | — | 16.5 (0.095) | 41.7 (0.159) | 35.3 (1.861) | 33.6 (0.327) |
По итогам всех 17 дисциплин вырисовывается чёткое разделение:
В сносках к приложению уточняются условия: все модели запускались на максимальном доступном уровне рассуждений; внутренний WorkIndex прогоняли в WorkBuddy CLI; DeepSWE и ProgramBench работали на оснастке mini-SWE-agent; Terminal-Bench 4.0 запускали в Claude Code с лимитом до 500 шагов и 13 часов на задачу; расходы посчитаны по официальным прайсам API с пересчётом долларов в юани по курсу 1:7.2.
Для оценки восприятия на практике Tencent провела слепое тестирование с участием 85 внутренних пользователей WorkBuddy на 259 повседневных задачах из 27 категорий. Сторонние модели (DeepSeek, Claude Haiku, GLM) запускались в режиме high.
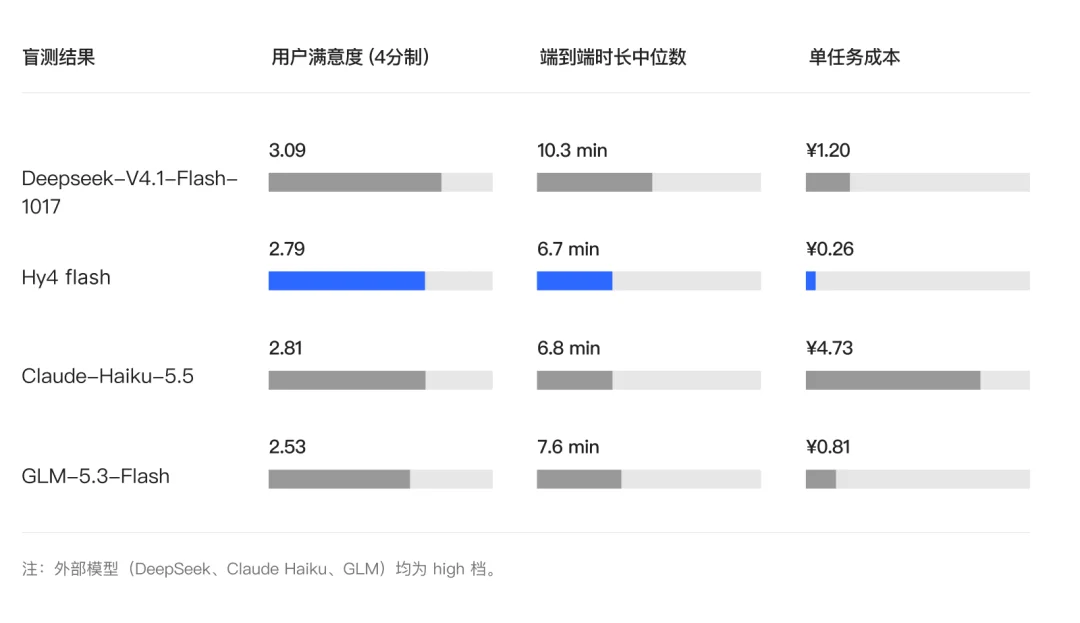
| Модель | Оценка пользователей (по 4-балльной шкале) | Медианное сквозное время | Стоимость задачи |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 3.09 | 10.3 мин | ¥1.20 |
| Hy4 flash | 2.79 | 6.7 мин | ¥0.26 |
| Claude Haiku 5.5 | 2.81 | 6.8 мин | ¥4.73 |
| GLM-5.3-Flash | 2.53 | 7.6 мин | ¥0.81 |
В тексте релиза компания делает акцент на близости к Claude Haiku 5.5 (2.79 против 2.81), не подсвечивая, что первое место с отрывом в 0.3 балла заняла DeepSeek-V4.1-Flash (3.09). Обратная сторона качества DeepSeek — время и цена: медиана составила 10.3 минуты при ¥1.20 за задачу, что в 1.5 и 4.6 раза выше показателей Hy4 flash. Claude Haiku 5.5 показала почти ту же оценку, что и Hy4 flash, но обошлась в 18 раз дороже.
Команда WorkBuddy в своём отчёте сформулировала итог так: по сравнению с Hy4 среднее время задачи снизилось на 70%, цена упала примерно в 15 раз, рутина осталась на том же уровне, а в «длинных задачах кодинга отмечено небольшое снижение». Но если вынести тесты программирования из приложения в отдельную таблицу, картина выглядит жёстче:
| Бенчмарк | Hy4 flash | Hy4 | DeepSeek-V4.1-Flash | Qwen3.8-Flash-Next |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 19.2 (0.558) | 44.4 (12.014) | 40.0 (3.882) | 29.5 (5.100) |
| ProgramBench | 16.0 (0.561) | 30.0 (30.281) | 29.0 (9.214) | 22.0 (18.432) |
| DeepSWE v1.1 | 64.6 (0.290) | 74.9 (5.409) | 73.8 (1.304) | 65.1 (3.251) |
В Terminal-Bench 4.0 балл рухнул с 44.4 до 19.2 — меньше половины от Hy4; в ProgramBench осталась чуть больше половины результата. Среди всех пяти Flash-моделей у Hy4 flash худший балл в DeepSWE, а в Terminal-Bench 4.0 она опередила только GPT-6 Luna. Формулировка «небольшое снижение» явно смягчает реальный разрыв.
Для пользователей Claude Code эти цифры особенно показательны, поскольку Terminal-Bench 4.0 прогоняли именно на оснастке Claude Code.
Сообщество на r/LocalLLaMA отреагировало на это сразу: один из участников (Hoppss) после чтения карточки модели заметил, что для программирования Qwen Flash Next выглядит предпочтительнее, на что ему возразили (mechkbfan), что стоит смотреть и на стоимость задачи — с Hy4 flash можно быстрее прогнать черновик и сделать пару дополнительных проверок. Данные из приложения подтверждают оба аргумента: в Terminal-Bench 4.0 у Qwen3.8-Flash-Next 29.5 балла против 19.2 у Hy4 flash, но одна задача стоит ¥5.10 против ¥0.56.
Официальные рекомендации Tencent это фиксируют: для глубокого поиска, работы с документами, генерации презентаций, простых фронтенд-демо и управления компьютером (computer use) подходит Hy4 flash, а для длительной программной инженерии с более высоким потолком интеллекта следует брать Hy4. На наш взгляд, ставить Hy4 flash основной моделью в Claude Code или OpenCode не стоит; зато для массовых однотипных операций — разбора логов, систематизации документации или вёрстки простых страниц — её ресурсов достаточно.
В релизе также приведены внутренние замеры от 8 продуктовых команд Tencent:
| Продукт (оценщик) | Сценарий | База сравнения | Результаты |
|---|---|---|---|
| WorkBuddy (продакт-менеджер Anne) | Повседневные офисные задачи | Hy4 | Среднее время задачи снизилось на 70%, средняя стоимость — около 1/15 от Hy4; качество в рутине на прежнем уровне, в длинном кодинге — небольшая просадка; нативная мультимодальность |
| Yuanbao (руководитель продукта Logan) | Агентные задачи, общие диалоги | Hy3, GLM-5.3-Flash | Агентные возможности выше Hy3 на 13.6%, оценка GSB при ручном сравнении выше на 7.56%; в общих диалогах прирост к GLM-5.3-Flash составил 2.52% (максимальный — в многошаговых диалогах) |
| WeChat Pay (лаборатория ИИ yilin, инженер безопасности Simba) | Управление реальным устройством для тестов платёжного клиента; статический анализ кода | DeepSeek-V4.1-Flash-1017 | По траектории выполнения, использованию знаний, приёмке и точности генерации тестовых аккаунтов баллы не ниже или выше; число шагов меньше примерно на 6%, длина одного ответа короче на 29%; в статическом анализе время снизилось на 37%, расход токенов — на 46% при сопоставимом качестве |
| WeCom (руководитель алгоритмов Dylan) | Корпоративный поиск, анализ материалов, систематизация документов | Hy4 | Скорость вывода выросла на 88%, расход выходных токенов в режиме рассуждений сократился примерно на 60%; модель самостоятельно планирует вызовы инструментов |
| Honor of Kings (руководитель управления проектами TH) | Поиск первопричин багов в разработке игры (UI и системная логика) | DeepSeek-V4.1-Flash-1017, GLM-5.3-Flash | Точность локализации близка к конкурентам; число запросов к модели снизилось на 22.0%–39.1%, а расход токенов по квитанциям запросов — на 40.5%–61.2%; при этом вызовов инструментов стало больше на 51.2% и 7.7%, а отчёты короче на 13.8% и 37.0% |
| ima (продакт-менеджер Kaycee) | Вопросы и ответы по базе знаний | DeepSeek-V4.1-Flash-1017, GLM-5.3-Flash | Среднее время ожидания сократилось примерно на 18%–35%; общая оценка ответов выросла на 1.8%, качество содержания — на 8.1%, качество цепочек рассуждений — на 2.1% |
| QQ (техлид Xiao Q Red, разработчик каналов Look) | Агентные функции Xiao Q; UGC-взаимодействие помощника каналов | DeepSeek-V4.1-Flash | Доля успешных ответов в рекомендациях музыки, каналах, Qzone и длинных астрологических разборах выше на 6.16, 2.84, 0.92 и 2.22 п. п.; время выполнения сократилось на 11%–27%; у помощника каналов точность распознавания намерений осталась прежней, P90 задержки комментариев снизился на 39%, пиковая — на 47%, вывод сократился на 30%, заметно вырос процент попаданий в кэш |
| Marvis (инженер алгоритмов Baihan) | ИИ-ассистент | DeepSeek-V4.1-Flash-1017 | Общая удовлетворённость на том же уровне; установка приложений выросла на 6.2%, системная настройка и диагностика — на 4.4%, работа с документами и исследовательскими отчётами — на 6.9% |
Все 8 кейсов собраны внутри экосистемы самой Tencent и в основном сравниваются с DeepSeek-V4.1-Flash без независимого воспроизведения. В примере Honor of Kings стоит обратить внимание на деталь: запросов и токенов стало меньше, но число вызовов инструментов против DeepSeek выросло на 51.2% — экономия получилась за счёт объёма токенов, а не снижения числа обращений к инструментам.
Поскольку все замеры и кейсы исходят от самой Tencent, к методике есть три практических замечания:
high.В открытый доступ выложены три набора весов: Hy4 flash, Hy4 flash-FP8 и базовая предобученная модель Hy4 flash-base (не для диалога). Файлы размещены на Hugging Face, ModelScope и AtomGit (GitCode), а код для инференса и дообучения лежит на GitHub. Веса самой Hy4 пока закрыты — компания обещает выпустить их «в ближайшее время».
Для продакшена рекомендуются vLLM или SGLang с квантованием FP8 и тензорным параллелизмом на 8 GPU. Для vLLM уже подготовлен официальный Docker-образ:
docker run --gpus all -p 8000:8000 --ipc=host \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \ --tensor-parallel-size 8 \ --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \ --attention-backend FLASHMLA_SPARSE \ --tool-call-parser hy_v4 \ --reasoning-parser hy_v4 \ --enable-auto-tool-choice \ --served-model-name hy4-flashСервер поднимает OpenAI-совместимый API. Уровень рассуждений задаётся через chat_template_kwargs, где no_think отключает цепочку размышлений:
from openai import OpenAI client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")resp = client.chat.completions.create( model="hy4-flash", messages=[{"role": "user", "content": "Кратко перескажи этот еженедельный отчёт в трёх предложениях"}], extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}},)print(resp.choices[0].message.content)Команда AngelSlim также выложила сборку в GGUF, но в README прямо оговорено, что она предназначена только для сквозного тестирования (end-to-end testing), а не для продакшена.
Заявленные 150 токенов в секунду измерены на собственной инфраструктуре Tencent — публичных замеров от сторонних провайдеров пока нет. В ветке релиза на Hacker News один из пользователей (vcryan) похвалил модель, но отметил, что работает она «немного медленно» (не уточнив провайдера); другой участник (Rodmine) напомнил, что по соотношению цены и скорости лидирует DeepSeek-V4.1-Flash, которая на OpenRouter стабильно выдаёт 200–400 токенов в секунду, хотя и выразил надежду, что компактная Hy4 flash у сторонних хостеров пойдёт быстрее.
Модель распространяется под лицензией Tencent Hy License 1.0 на базе Apache 2.0 с отдельным ограничением для коммерческих MaaS-сервисов: компаниям, предоставляющим модель как сервис при совокупной мировой выручке свыше $50 млн в год или более 100 млн активных пользователей в месяц, требуется отдельное лицензионное соглашение с Tencent. Внутреннее использование без предоставления модели и её вывода третьим лицам под это ограничение не подпадает.
| Рабочая нагрузка | Рекомендация | Аргументы и компромиссы |
|---|---|---|
| Документы, презентации, таблицы, глубокий поиск | Hy4 flash | Около ¥0.2 за задачу в WorkIndex; DeepSeek-V4.1-Flash точнее в PPT и правке документов, но дороже в 4–10 раз |
| Массовые диалоги и Q&A с упором на скорость | Hy4 flash | Самое короткое медианное время в слепом тесте (6.7 мин); в ima ожидание сократилось на 18%–35% |
| Написание кода и работа в терминале (Claude Code, OpenCode) | Hy4 или DeepSeek-V4.1-Flash | Terminal-Bench 4.0: Hy4 flash 19.2 против 44.4 у Hy4 и 40.0 у DeepSeek-V4.1-Flash |
| Приоритет — качество результата без спешки | DeepSeek-V4.1-Flash | Высшая оценка в слепом тестировании (3.09), но 10.3 мин и ¥1.20 за задачу; в непиковые часы тариф вдвое ниже |
| Визуальное рассуждение с вызовом инструментов | Hy4 flash | Лучшая среди Flash-моделей в ZeroBench (45.8), но худшая в классе на MMMU-Pro (75.8) |
| Собственный хостинг для внешнего сервиса | Проверить железо и лицензию | Для FP8 нужен тензорный параллелизм на 8 GPU; крупным MaaS-провайдерам требуется отдельное разрешение Tencent |
В CodingPass сейчас подключена старшая модель Hy4 (ID модели hy4): она доступна на тарифах Go, Plus и Pro со списанием из квоты по официальным ценам API. Самой Hy4 flash в каталоге пока нет. По рекомендациям самой Tencent для длительной разработки всё равно нужна именно Hy4. Если же ваша цель — дёшево прогонять массовую офисную рутину через Hy4 flash, выгоднее подключаться напрямую к Tencent Cloud TokenHub, где до 30 ноября действует скидка 50%, а не брать подписку ради неё. Квоты по всем моделям собраны на странице моделей.
В CodingPass доступны Hy4, DeepSeek, Claude, GPT, Gemini и другие модели со списанием по официальным ценам API. Никаких неожиданных списаний, отмена в любой момент.